
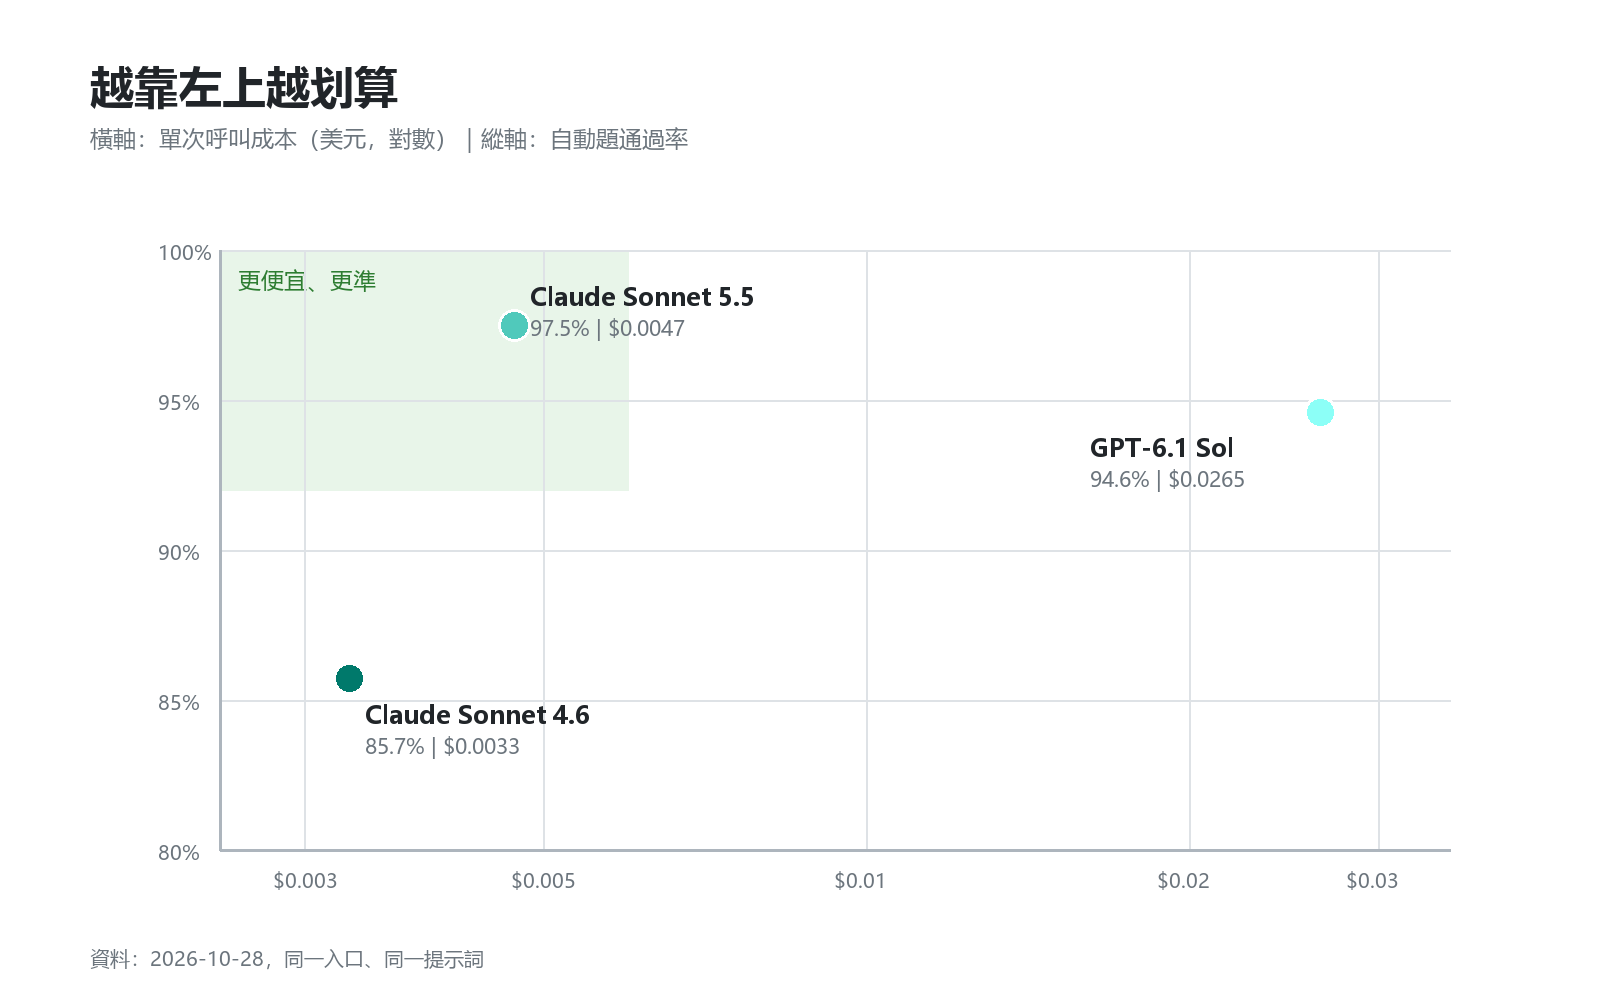
12 題、每題 5 遍、3 個模型。單次呼叫成本落在 0.0033 到 0.0265 美元之間。
單價以 Sonnet 4.6 價格頁 為準。
問題:批次驗證時,單次呼叫的結果不能當依據
把模型接到批次流程之後,真正的問題不是「答得好不好」,而是「會不會每次都答對」。
單次呼叫只會告訴你這一筆過了。過了可能是它穩定,也可能是這次運氣好;沒過可能是它不擅長,也可能是這次取樣歪掉。兩種情況的處理方式完全不同:前者重試就好,後者要換模型或加一層驗證。
所以我用同一個提示詞連跑五次,讓同一個錯誤有機會出現第二次。
環境與方法
三個模型、十二道題、每題五次,總共 180 次呼叫,同一個入口、同一組提示詞、同一天完成。
題目刻意選小、選有唯一答案的:一道計算、一道機率、一道有字數上限的定義題、幾道結構化輸出。其中八題可以程式判分,四題是程式碼與改寫,需要人眼讀,不列入通過率。
| 模型 | 自動判分通過 | 延遲中位數 | 每次呼叫成本 |
|---|---|---|---|
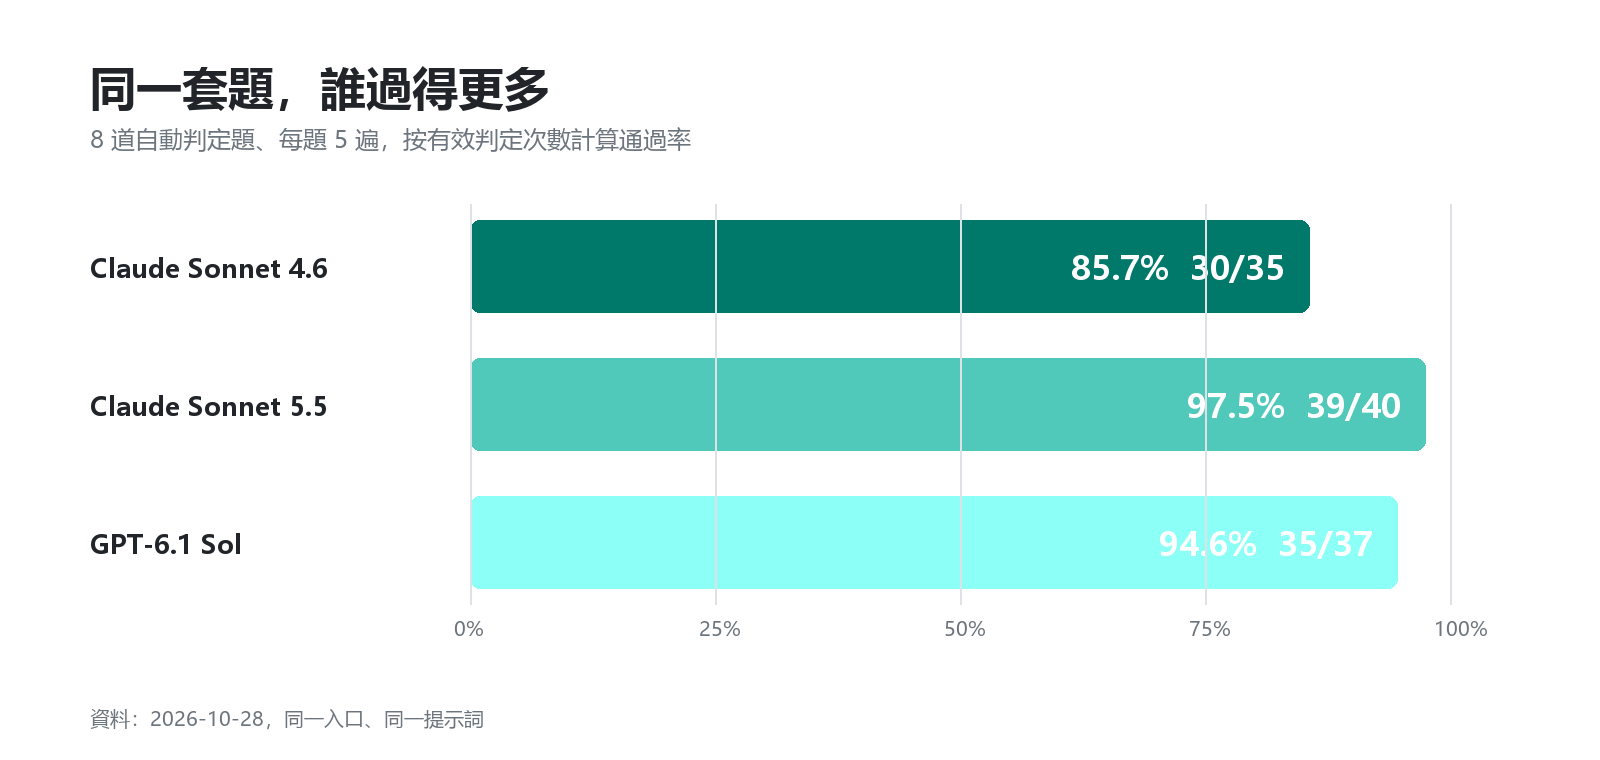
| Claude Sonnet 4.6 | 30/35 | 3.29 秒 | 0.0033 美元 |
| Claude Sonnet 5.5 | 39/40 | 2.81 秒 | 0.0047 美元 |
| GPT-6.1 Sol | 35/37 | 6.19 秒 | 0.0265 美元 |
分母不是 40,因為 180 次裡有 13 次是網路錯誤,直接丟棄。硬湊成同一個分母,比到的會是連線品質。
第一個差異:字數上限
題目要求用 60 個字元以內解釋 MoE,而且不能用「專家」這個詞。
三個模型分別回了 65、58、48 個字元。Claude Sonnet 4.6 超標五個字元,超出的部分是「閘門機制」「動態選擇」這類修飾語——讓定義更精確,也讓句子更長。
再跑四次:65、62、68、66、70。一次都沒進到 60 以內。
這不是算錯字數,而是優先順序不同:它把「講完整」排在「守上限」前面。寫文章時這是優點,跑批次時就是不良品,因為每一筆都要人工修,而人工修剪比呼叫費用貴。
順帶一提,在 API 層設 max_tokens 不會解決這件事。它只是把句子砍斷,不會讓模型事先規劃長度。
第二個差異:五次裡滑一次
機率題:從 1 到 5 取三個相異數字,和為偶數的機率,答案是 3/5。
Claude Sonnet 5.5 五次答對四次。錯的那次推理是這樣(節錄):
三個都是偶數:只有 2 和 4,取不出三個,0 種。一個奇數兩個偶數:C(3,1)×C(2,2)=3 種。所以機率是 3/10。
它把「兩個奇數一個偶數」算成「一個奇數兩個偶數」,有利情形少一半,答案也少一半。推理自洽、結論錯誤。
只看一次,這個模型不是完美就是不能用。看五次,它是 39/40,只有在有明確答案的那題滑了一次,重試即可。
第三個差異:同一個價目表,帳單差 5.6 倍
Claude Sonnet 5.5 和 GPT-6.1 Sol 的價目表完全一樣:輸入每百萬 token 2 美元,輸出每百萬 token 10 美元。
實測每次呼叫成本是 0.0047 與 0.0265 美元,同樣的單價,帳單差 5.6 倍。
差距來自每道題的消耗量,不是單價:Sol 在問題與答案之間做了更多事。
多花的錢也沒有換到準確度。橢圓切線那題答案是 16/5,Sol 五次裡有兩次只回 4/5,兩個 Claude 模型五次全對。
真正像工作的那一輪
十二道小題只是篩選,不是工作量。所以另外跑了二十張客服工單、每張抽五個欄位,一共一百格。
三個模型一百格全對,準確度分不出高下。
分得出來的是時間:7.5 秒、29.3 秒、37.9 秒。單次差半分鐘不算什麼,一天一萬次就超過 84 小時。
可重現的最小腳本
想在自己的題目上重跑,不需要整套流程。固定提示詞、跑五次、記四個數字就夠:
import asyncio, statistics, time

async def run_once(client, model, prompt):
    t0 = time.perf_counter()
    r = await client.chat(model=model, prompt=prompt)
    return r.text, time.perf_counter() - t0, r.usage

async def screen(client, model, prompts, runs=5):
    rows = []
    for p in prompts:
        outs = [await run_once(client, model, p) for _ in range(runs)]
        rows.append({
            "prompt": p[:40],
            "answers": [o[0] for o in outs],
            "latency_median": statistics.median(o[1] for o in outs),
            "cost": sum(o[2].cost for o in outs) / runs,
        })
return rows判分要自己接,answers 留著是為了人工比對:同一個錯誤出現兩次以上才算穩定行為,只出現一次的當成雜訊。
邊界
以上全部是單輪、短輸入的文字工作。
長上下文、多輪對話、工具呼叫、看圖都沒測。三個模型的上下文視窗是 200K、1M、922K token,但那是規格,不是量測結果。
四題由人工判分,沒有進通過率;13 次呼叫因網路錯誤被丟棄。價格依 2026 年 10 月 28 日的模型列表,實際帳單看用量。
結論
有硬性長度或格式契約的工作——批次生成、結構化輸出、API 回傳——Claude Sonnet 5.5 是三個裡最省事的選擇:五次都沒有違反限制,延遲中位數最短,單次成本也最低。
由人編輯的一次性文字,Claude Sonnet 4.6 仍然合理,長一點、資訊多一點的答案在那個情境是材料。
GPT-6.1 Sol 不是便宜的替代品。價目表一樣,實付 5.6 倍,還在簡單計算題上錯兩次。要選它,理由不能是「比較便宜」。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

