
把 Gemini Omni 1.2 Flash 接進流程之前,我想先問一個工程上的問題:它生成出來的片段,能不能直接拿去用?
2026年11月5日 Google 發布這一版,把原生影片生成和編輯延長到15秒,主打參考素材遵循和多輪對話式修改。核驗到2026年11月16日,我的判斷是:不能盲信一次生成。
輸入這端你能控制的其實不少(參考圖、首尾清單自己查。適合要做角色分鏡、在已有片段上局部改色改風格的人;不適合直接拿去當精確物理、碰撞教學的素材。
先給結論:哪幾層交給模型,哪幾層自己把關
當成一個生成元件來看,這一版的可控程度可以分層:
| 這一層 | 交給模型行不行 | 驗收時盯什麼 |
|---|---|---|
| 角色外觀(同一角色換鏡頭) | 大致可以,給足參考圖 | 頭身比例、配色、手腳設計有沒有在鏡頭間走樣 |
| 改色後的動作與事件時間 | 可以 | 位置和時間點有沒有被改色帶偏 |
| 改風格後的運動節奏 | 一半 | 材質變了,定格那種一頓一頓的節奏通常沒跟上 |
| 物理連續性(數量、碰撞路徑) | 不行,要自己查 | 物體數量全程不變、碰撞接觸看得清、不複製不消失 |
規律是越往下越要自己盯。輸入端給得越明確,外觀和改色這兩層越穩;到了物理連續性這層,Omni 官方自己把複雜物理列進待改進,我後面換 Veo 3.1 又撞上同一個問題。下面按「輸入能控到哪 → 外觀 → 改色 → 物理」一層一層拆。
Gemini Omni 1.2 Flash 的輸入和輸出:你能控制到哪
先把這一版的介面攤開。官方給的是一條連續操作:先生成短片,再用後續提示改細節,最後把選定版本放大輸出。對應到輸入和輸出,是這樣:
| 項目 | 這一版的說法 |
|---|---|
| 短片長度 | 常規生成與編輯支援3—15秒,按1秒遞增;上一版上限是10秒 |
| 參考素材 | 可用角色、產品或風格素材引導生成,實際輸入能力看使用入口 |
| 影片修改 | 對同一片段繼續提改背景、光線、天氣等要求 |
| 輸出解析度 | 先出360p或720p草稿,再放大到1080p或4K |
| 聲音 | 支援帶聲音的影片,本文案例未涉及中文對白 |
輸入端值得先分清楚的是三種圖,各自控制的東西不一樣:
| 輸入方式 | 控制什麼 | 例子 |
|---|---|---|
| 首幀圖片 | 影片開場 | 從機器人站在街道的照片開始,讓它往前走 |
| 角色參考圖 | 角色外觀 | 給正面、側面和近景,安排不同鏡頭 |
| 首尾幀 | 開頭與結尾 | 給起點、終點,讓模型生成中間過程 |
這裡有一條入口限制要記下來:DataCamp 提到,公共 Gemini API 不提供上傳音訊參考,Google Cloud 相關能力需要批准。接之前先核對所選入口支援哪些欄位和時長,不要照著公告的全集去填。輸出這端你拿得到時長、解析度、聲音軌,但「畫面對不對」不在輸出欄位裡——那部分只能靠驗收。往下三節就是在驗這三層。
參考圖把角色外觀鎖到什麼程度
第一層,角色外觀。沒有參考圖時,常見的樣子是:上一個鏡頭是圓腳和手套,下一個鏡頭長出關節腿和爪子,剪在一起像換了角色。Treza 用一個燈籠機器人做了對照。
這組測試的設置:
- 來源:Alex Daro,Treza 四鏡頭參考圖實測,2026年11月10日。
- 素材:正面全身、面部近景、側面全身,共三張參考圖。
- 輸出:每組四條8秒影片,720p、9:16、開啟聲音。
- 鏡頭:遠景推進、特寫、側面跟拍、低角度。
無圖組把參考圖和提示詞裡對應的句子都移掉。四個機器人都有燈籠身體、銅色頭部和青綠色圍巾,但眼睛、手腳和身體結構各不相同。補上三張參考圖之後,主要造型在四個鏡頭裡明顯統一了。
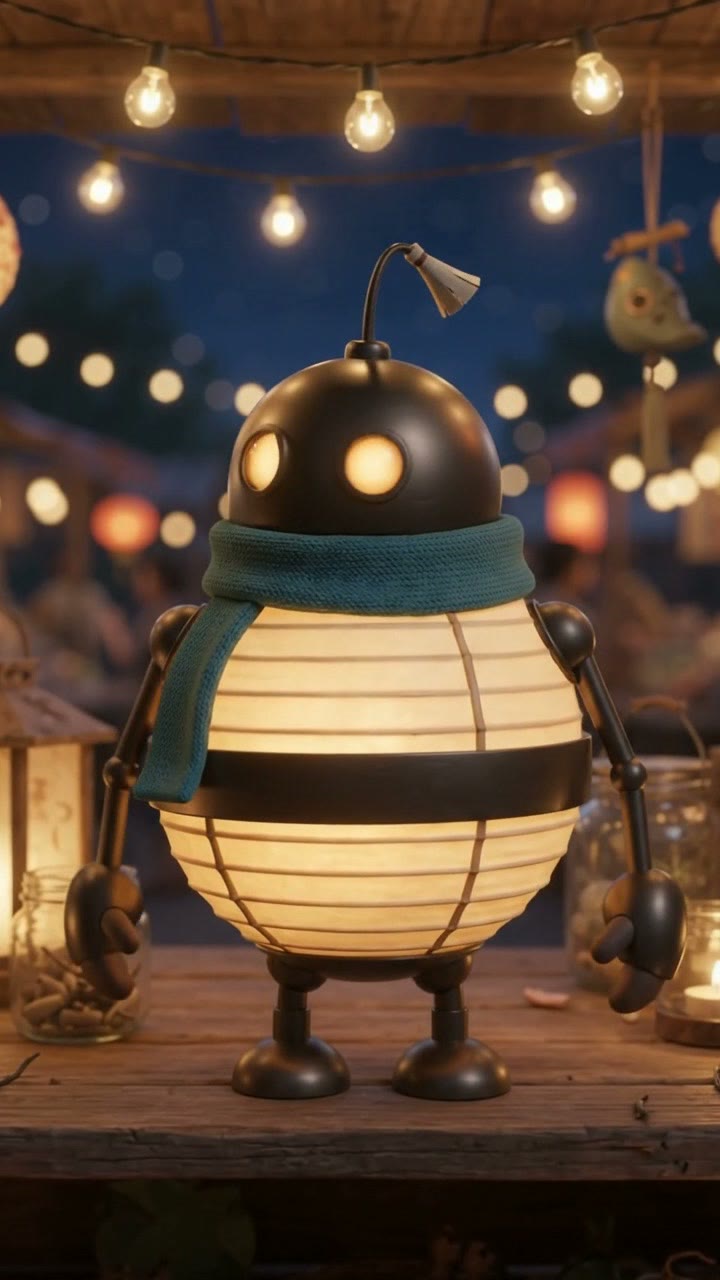
圖片引用:Alex Daro/Treza,2026年11月10日,上述原文的帶參考圖第1鏡頭,展示的是原作者的 Omni 輸出。
外觀鎖住了,不代表每一格都對。動作上還有兩處漏:機器人鬆開燈繩後懸在半空,作者把提示改成「雙腳站在箱子上,伸手碰燈籠」才避開;原本沒有嘴的機器人,在一個鏡頭裡短暫長出了嘴。所以這層的驗收點很清楚——參考圖負責把「這是同一個角色」釘住,頭身比例和配色可以交給它,逐格的動作細節還是自己過。準備素材時我會把幾張視圖並排核對,背景盡量乾淨,省得無關物體跟著角色進新鏡頭。要補一句邊界:這組來自模型服務商自己的測試,覆蓋的是一個風格化角色,沒有真人、多角色和長劇情。
在已生成片段上改色、改風格,動作會不會跑掉
第二層,改色和改風格之後,動作能不能守住?Khalid Abdelaty 在2026年11月6日的 DataCamp 實測文章 做了三輪,都是15秒、720p、16:9。
第一輪,生成原片。 紅彈珠沿軌道滾動,穿過銅環、撞倒骨牌,最後觸發鈴鐺。原片本身就帶了一個毛病:彈珠中途消失,之後又重新出現。
第二輪,紅色改藍色。 按作者的觀察,彈珠變藍之後,位置、主要外觀和事件發生的時間基本保留——動作這層跟住了。但問題也在這:原片那個連續性錯誤,原樣進了新版本。它對齊的是原片,不是把原片修對。所以順序不能反:先挑一個動作滿意、又沒有硬傷的版本,再去做顏色變體。
第三輪,改成定格風格。 木軌道和骨牌出現紙板質感,但部分背景仍然寫實,運動也仍然平滑。材質換了,逐格定格那種一頓一頓的節奏沒跟上,這兩件事得分開看。
作者還報了幾個數:首次生成不到1分鐘,每次編輯大約2分鐘;音軌相對原片,第一次編輯後移約45毫秒,第二次後移約85毫秒。這層的驗收點是兩個:改色改風格之後,動作和時間要核對有沒有被帶偏;還要順手查原片的錯誤有沒有被一起複製過去,以及聲音有沒有漂移。模型保的是「和原片一致」,修錯這件事它不替你做。
物理連續性:我用 Veo 3.1 跑了一條,結尾多一顆彈珠
第三層最硬:物體的數量和碰撞路徑,物理上連不連得上?DataCamp 改色那輪把原片錯誤原樣留著,正好把我推回「第一次生成」本身——如果一開始就只留彈珠滾動和碰鈴,把多餘環節砍掉,另一款 Google 影片模型會交出什麼?我拿 Veo 3.1 試了試。
我先核對了 Crazyrouter 的 Veo 3.1 模型頁面,於2026年11月16日透過 https://api.crazyrouter.com/v1/video/generations 提交了一次文生影片請求,用標準版模型 ID aigc-video-gv-3.1。參數設成8秒、720p、16:9並開啟聲音。從提交到輪詢發現完成大約67.35秒(含請求和輪詢等待),下載後的檔案是1280×720、24fps,帶48kHz立體聲 AAC 音軌。
我把 DataCamp 那套裝置簡化成「彈珠碰鈴鐺」:去掉銅環、骨牌和後續編輯,把動作壓進8秒。實際用英文提示詞,中文意思是:
暖色鐘錶工作間,一顆紅色玻璃彈珠沿木斜坡從左向右滾動,清楚地碰到工作檯上的銅鈴,然後停在旁邊。保持連續鏡頭,接觸時同時看清彈珠和鈴鐺;不要出現物體複製或消失。保留滾動聲,可見撞擊時響鈴,無音樂、對白和字幕。
我盯的就是彈珠從斜坡到鈴鐺旁這一段:位置怎麼變,數量有沒有變,最後停在哪。
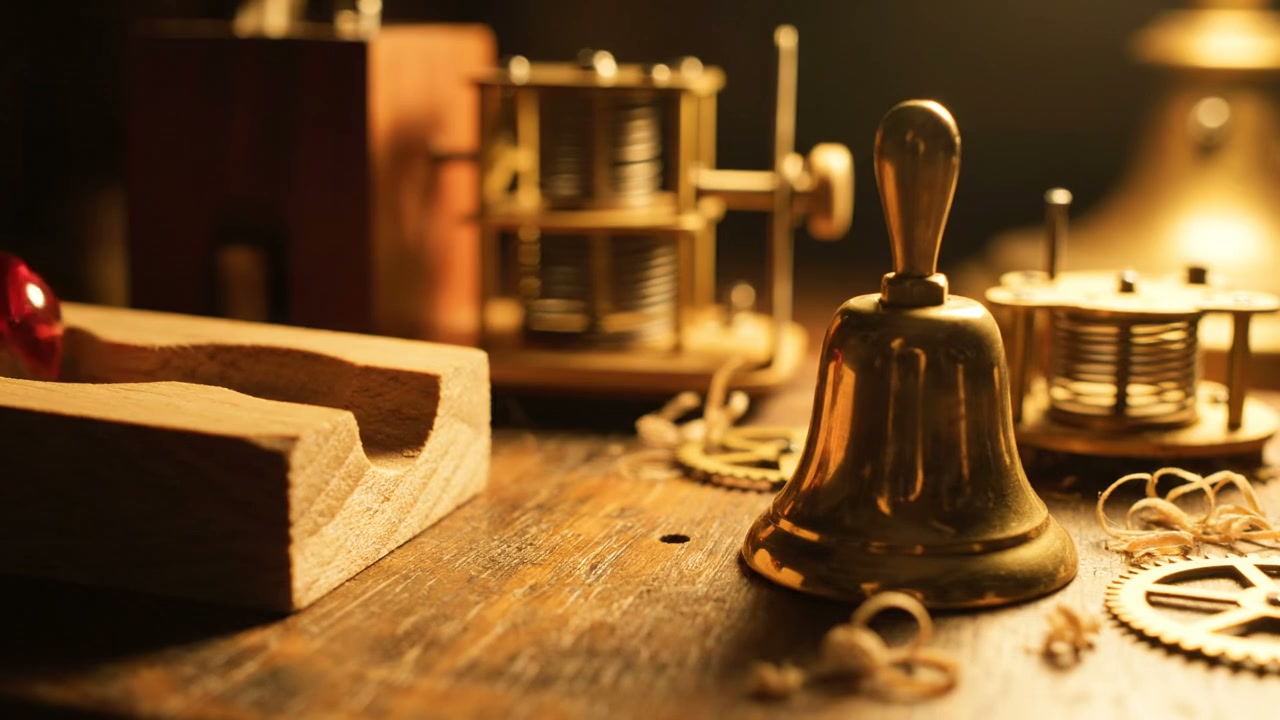
本次 Veo 3.1 輸出,第0秒。以下三張圖都從同一條原影片擷取。
開場是對的:暖色工作間、木斜坡、銅鈴都清楚地擺在前景,背景有機械零件,玻璃和金屬都有反光。單看這一格,佈景、色調、主體位置都沒問題。
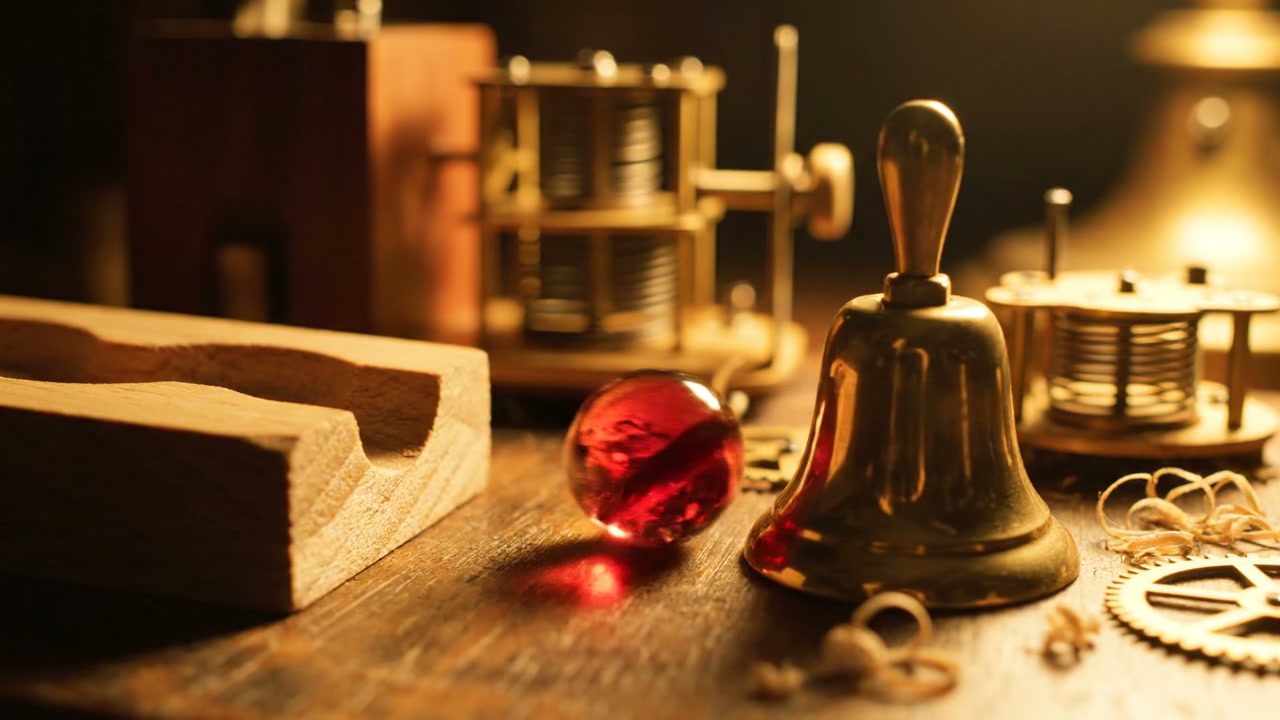
第4秒,紅色彈珠已經來到銅鈴左側。
到第4秒還是一顆。可接近結尾,數量變了。提示詞寫的是一顆彈珠、明確要求別複製,畫面裡卻出現了兩顆。
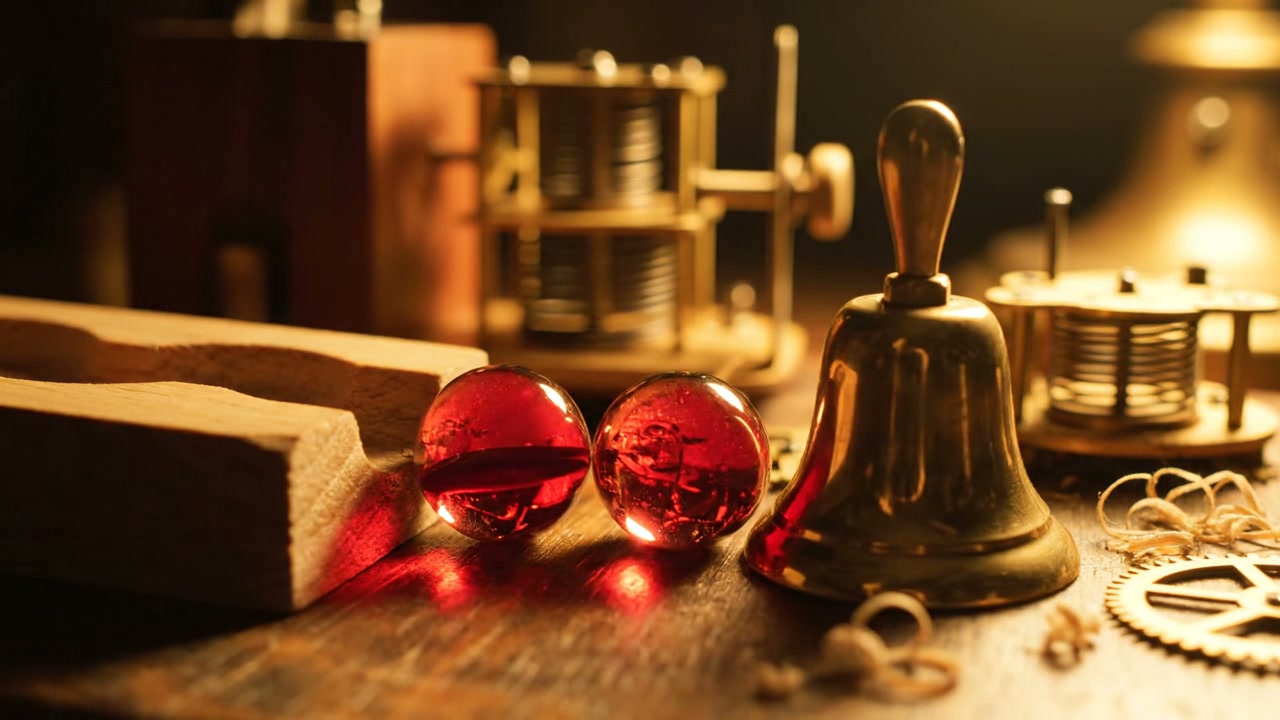
第7秒出現兩顆彈珠,沒滿足「單顆、不複製」的要求。
球憑空多了一顆。這就是我要驗的那層:換一款模型,物理連續性會不會好一點?這一條的答案是沒有。Omni 官方把複雜物理列進待改進,DataCamp 的原片有彈珠消失又出現,我這條 Veo 結尾多一顆——三處撞的是同一類問題,兩家都沒替我把它解掉。
要說明的是,這次我只生成一條,沒有追加重試;聲音只檢查到「檔案裡有音軌」這一項,音畫時間差沒測量,所以這條不打分。要復現,可以查看 Veo 3.1 的模型與呼叫資訊。這層給工程上的提醒也很直接:驗收這類影片,數量和碰撞要逐段看到最後一格,不能只看開場。如果片段是用來講彈珠運動的,觀眾會直接問第二顆從哪來;如果只是拿來做分鏡、留佈景和光線參考,它還能用。
Gemini Omni 1.2 Flash 和 Veo 3.1,按任務怎麼分
把三層的結論落到分工上:
| 你的任務 | 我會先試 | 用的時候盯什麼 |
|---|---|---|
| 同一個角色出現在多個鏡頭裡 | Gemini Omni 1.2 Flash | 按 Treza 的辦法準備統一視圖,再檢查運動中的造型變化 |
| 保留原片動作,只改顏色或視覺風格 | Gemini Omni 1.2 Flash | 參考 DataCamp,逐輪保留版本,順手核對聲音有沒有漂移 |
| 已經接了 Crazyrouter,先出一條獨立鏡頭草稿 | Veo 3.1 | 接入流程已經跑通;逐段檢查主體數量、動作和結尾 |
| 精確物理、碰撞教學這類內容 | 優先實拍或可控動畫 | 兩邊的彈珠案例都在物理連續性上出問題,物體運動得準 |
兩條線對應兩件事。角色分鏡和連續改片,Omni 有參考圖和連續編輯的公開案例,外觀一致和改色一致守得住,我會先從三張角色視圖或一次局部改色上手。要先出獨立小樣,Veo 3.1 在我這次呼叫裡完成了生成和檔案下載,接入條件已經具備,我會先用它把明確的小片段做出來,再決定要不要加第二種模型。但只要任務落到精確物理,這兩款我都會先退回實拍或可控動畫——物體數量這關,它們這輪都沒過。
還有人會先問這些
Q:Gemini Omni 1.2 Flash 的參考圖能保證角色完全一樣嗎?
A:能保住主要造型。Treza 那組加了參考圖之後,四個鏡頭的身體、頭部、圍巾是統一的;但動作細節仍會漏,像懸浮和短暫長嘴。外觀一致鎖得住,逐格的動作還得自己查。
Q:在已有片段上改顏色,動作會被改亂嗎?
A:這輪沒有。DataCamp 把紅彈珠改成藍,位置、外觀和事件時間基本保留。代價是原片本身的連續性錯誤也一起留著——它對齊的是原片,不是把原片修對。
Q:這篇裡 Omni 和 Veo 3.1 是同條件對比嗎?
A:不是。Omni 的結果來自第三方公開實測,Veo 3.1 是我自己透過 Crazyrouter 跑的一條,任務和參數都不一樣。放一起是因為物理連續性這層它們撞到同一個問題,不是比名次。
Q:驗收這類生成影片,最該先查哪一項?
A:物體數量和碰撞連續性。我這條 Veo 到第7秒多出一顆彈珠,Omni 官方也把複雜物理列進待改進。別只看開場格,逐段看到最後。
參考來源
- Google,2026年11月5日發布公告:《Gemini Omni 1.2 Flash: Fast and cost-effective with longer clips》。
- Treza Labs,Alex Daro,2026年11月10日:《One Character, Four Angles: Gemini Omni 1.2 Flash With Reference Images》。Treza 同時提供模型服務,文中案例按其公開測試歸因。
- DataCamp,Khalid Abdelaty,2026年11月6日:《Gemini Omni 1.2 Flash: New 15-Second Clips and Lower Pricing》。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

