

👋 前言
我在 RAG 的各個位置插入 Jev,實測看看哪裡會怎麼變化!
🎯 目標讀者
- 老實說,你是不是也在想「Jev 真的能用在 RAG 檢索嗎?」
- 熱愛 RAG 檢索的人
⚡ Jev 是什麼?
Jev 是 TypeSafe AI 於 2026 年 9 月 15 日公開的模型。
相關解說文章已經很多了,這裡就簡單介紹。簡單來說,它是個不會生成文字的 AI 模型。只要把「狀態」和「有型別的問題」丟給它,它就會一次回傳帶有機率的答案。不寫文章。
項目內容回應時間約 70~500ms費用輸入 $0.042/100 萬 token,輸出免費問題類型選項、是/否、階段式評分(分數)特色可將多個問題在 1 次請求中平行處理提供狀態 early access🗺️ 驗證了什麼?
RAG 檢索的流程是「問題 → 向量檢索 → 重新排序 → LLM 回答」對吧。
這當中看起來能插入 Jev 的地方有 3 個:「搜尋之前/重新排序/呼叫 LLM 之前」。我分別把 Jev 放進去,驗證速度與成本是否能改善。
#驗證想確認的事插入位置1重新排序在排序精度上,能否追上專用 reranker重新排序2判斷「無法回答」當答案不在 chunk 裡時,能否在呼叫 LLM 前先停下來LLM 之前31 和 2 能不能合併成 1 次請求而不掉精度。能變多快、多便宜重新排序4把非目標問題擋在門外能不能在不做檢索的情況下擋下「今天晚餐吃什麼?」之類的問題搜尋之前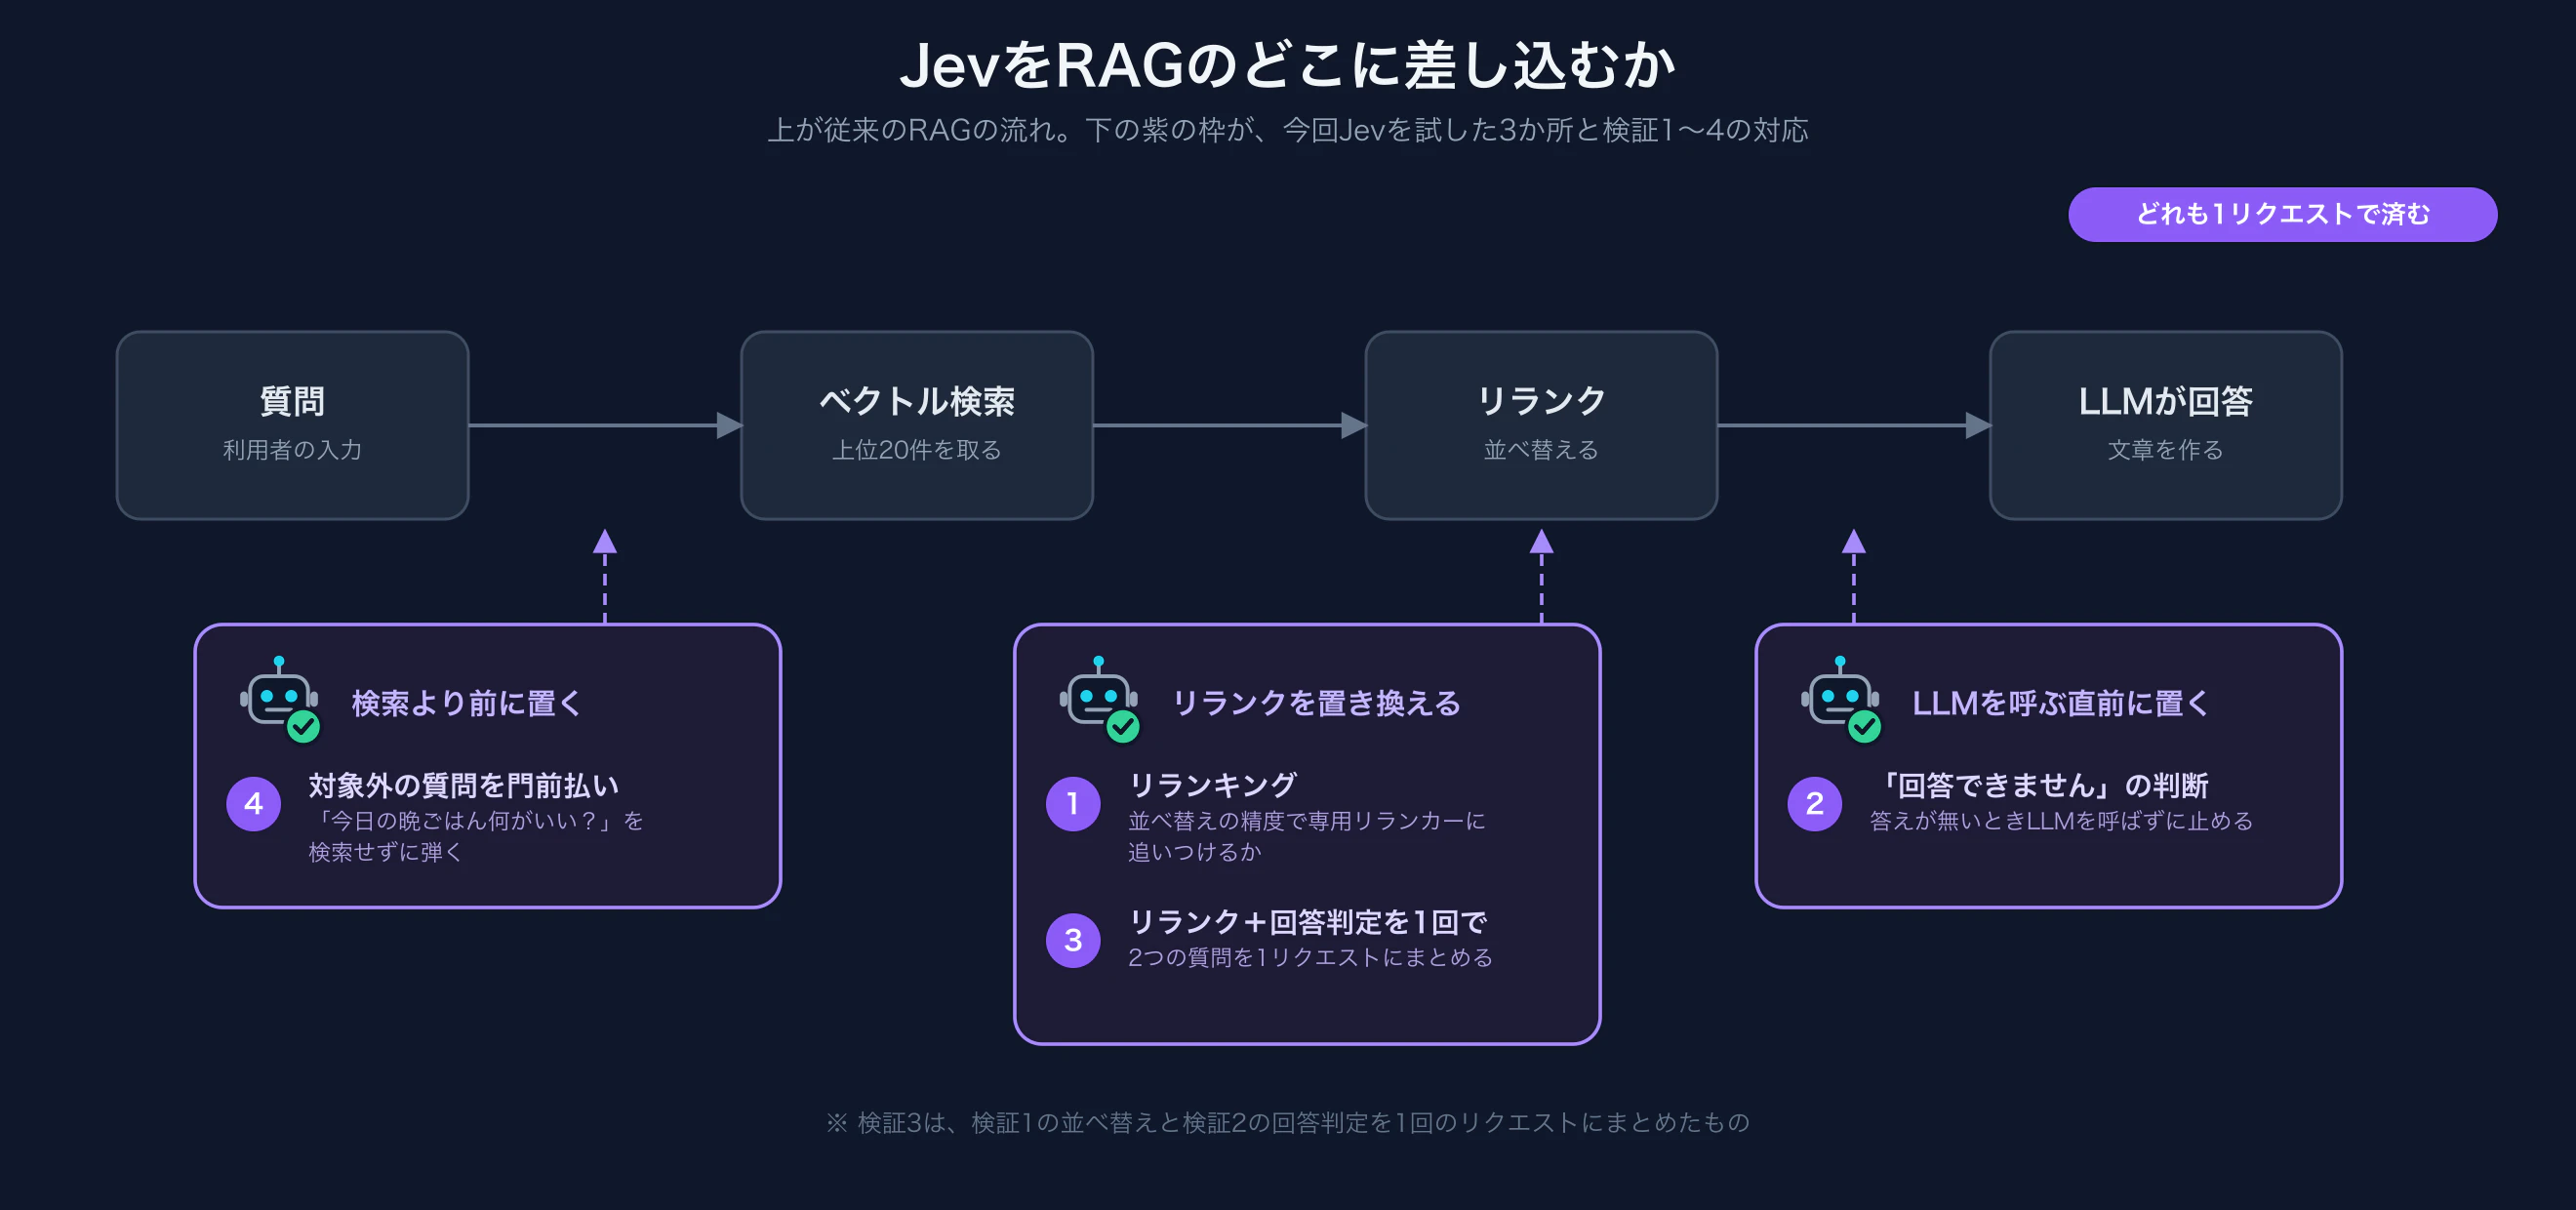
我實際跑這些流程,並比較速度與成本。
🧪 驗證準備
🗂️ 資料集
首先需要正解資料,也就是「這個問題的答案寫在這個 chunk 裡」。以虛構公司的內規與作業流程為素材,涵蓋人事、會計、總務、IT、安全衛生 5 個領域 × 8 份文件 × 10 個 chunk,共 40 份文件、400 個 chunk。寫作時會記錄每個事實寫在哪個 chunk,也會記錄哪些事實刻意不寫。因此正解標籤會根據這些記錄機械式決定。針對每個問題,取向量檢索前 20 筆並標註 2 種標籤。
標籤內容相關度 0:無關 / 1:同一領域 / 2:同一規程中的其他事項 / 3:正是這個答案是否包含答案這個 chunk 是否足以回答問題(是 / 否)不過,如果記錄有漏標,就會直接變成錯誤的正解資料。所以我用兩種方式做雙重確認。
- 人工檢查:針對 14 個接近命中的問題,逐一閱讀所有排在前面的 chunk
- 另一個 AI:不告訴它記錄,讓 Claude Opus 5 判定
結果幾乎一致,和人與人之間互相標註時的差異程度相當,因此判定可作為正解資料使用。
問題類型問題搜尋排到第一名的 chunk 能回答嗎?件數可回答「交通費請領的截止日是?」交通費請領需於每月 25 日前申請。○ 25 日60 件接近命中「育嬰留停中的社會保險費減免,最晚要什麼時候申請?」育嬰留職停薪期間的社會保險費,得依本人申請予以減免。手續由人事部辦理。× 沒寫期限40 件完全無關「今天晚餐吃什麼好?」員工餐廳營業時間為 11 點至 14 點。× 根本答非所問20 件所謂接近命中,是指話題完全對上,但關鍵答案沒有寫在 chunk 裡的情況
🖥️ 驗證環境
項目內容區域東京(ap-northeast-1)呼叫端日本本地電腦搜尋 DynamoDB(向量檢索,取得前 20 筆)Embedding Amazon Titan Text Embeddings V2(1024 維)重新排序器 Cohere Rerank 3.5 / Amazon Rerank 1.0(Bedrock)比較用 LLM Claude Haiku 4.5回答生成 LLM Claude Haiku 4.5Jevjev-1.13.0(直接 API,Python SDK typesafe-sdk 0.7.0)※數值為驗證當下(2026/09)的內容。
🔀 驗證 1:重新排序
🔧 重新排序的方法
Cohere Rerank 3.5 / Amazon Rerank 1.0:將問題與 20 個 chunk 丟給 Bedrock 的重新排序功能進行排序。
Claude Haiku 4.5:將 20 個 chunk 編號後送入,請它「依相關度由高到低排列編號」。
Jev:針對 20 個 chunk 各自建立一個「與這個問題的相關度如何?」的階段式評分問題,合併成 20 題一次送出
{
  "model": "jev-1.13.0",
  "state": {
    "query": "交通費精算的截止日是?",
    "items": [
      { "id": "item_0", "title": "旅費交通費規程", "text": "交通費精算は毎月25日までに申請すること。" },
      { "id": "item_1", "title": "旅費交通費規程", "text": "交通費精算の申請は、経費精算システムに利用日、利用区間、用務先および目的を入力して行う…" }
      // … item_19まで
    ]
  },
  "questions": {
    "rel_0": {
      "type": "score",
      "instructions": "item_0 の text は、query にどれくらい関連しているか。",
      "criteria": [
        "0 - 無關。query と完全無關",
        "1 - 與同一領域有些關聯",
        "2 - 同一對象,但處理的是 query 所問的不同事項",
        "3 - 與 query 所問的是同一對象、同一事項。是否寫有答案不列入考量"
      ]
    }
    // … rel_19まで、チャンクごとに1問ずつ
  }
}
階段式評分的 criteria 是從 0 分開始排列的說明文字陣列。為了讓相關度不混入答案有沒有寫這件事,我在 3 分的說明中加入了「是否寫有答案不列入考量」。排序則依回傳的 score 由高到低。
📏 怎麼量測
先說明 3 個指標,再看結果。
指標看什麼滿分 Recall@1有答案的 chunk 排在第 1 名的比例1.000Recall@5有答案的 chunk 進入前 5 名的比例1.000nDCG@5前 5 名的排列是否接近相關度由高到低的理想順序1.000### 📊 結果
方法Recall@1Recall@5nDCG@5速度1,000 查詢成本不重新排序0.8001.0000.814――Cohere Rerank 3.50.9501.0000.884198ms$2.00Amazon Rerank 1.00.8500.9670.819337ms$1.00Claude Haiku 4.51.0001.0000.960981ms$2.73Jev0.9831.0000.965290ms$0.25先說 Haiku 幾乎不行(不只要接近 1 秒,價格還最高),為了只是排序就呼叫 LLM 再排除它,看起來沒什麼好處。然後,兩種 reranker 和 Jev 的精度與速度都沒有明顯差異。差別出在價格,Jev 只有八分之一。看起來 Jev 很棒!!不過這個精度其實不太可靠。不重新排序的 Recall@5 竟然是 1.000,表示在向量檢索那一步,答案就已經進到前 5 名了。也就是說,reranker 根本沒有派上用場。
400 個 chunk 的規模太小了。若要正確比較精度,必須用更大的語料重新測一次。
🙅 驗證 2:能不能判斷「無法回答」
就算 chunk 找到了,如果裡面沒有答案也沒有意義。若能把接近命中的問題判成「無法回答」,就能在呼叫 LLM 前先停下來,回傳「找不到該資訊」,達到節省成本的效果。
🔧 判斷方法
重新排序分數閾值:若 reranker 回傳的最高分低於閾值,就判定無法回答。這是 RAG 長久以來常見的方法。閾值是在打開測試集之前的 40 題先決定的。Cohere 是 0.672,Amazon 是 0.0006。因為不同方法的分數尺度不同,所以必須分開決定。
Claude Haiku 4.5:將問題與前 5 個 chunk 一起送出,讓它用 yes/no 判斷「只靠這些資訊能不能回答」。
Jev:把前 5 個 chunk 和 yes/no 問題一起送出。
送出的 5 個 chunk,三種方法都用 Cohere Rerank 3.5 排序後的前 5 名。
{
  "model": "jev-1.13.0",
  "state": {
    "query": "育嬰留停中的社會保險費減免,最晚要什麼時候申請?",
    "items": [
      { "id": "item_0", "title": "育児・介護休業規程", "text": "育児休業期間中の社会保険料は、本人の申出により免除される。手続きは人事部にて行う。" }
      // … item_4まで
    ]
  },
  "questions": {
    "can_answer": {
      "type": "noul",
      "instructions": "items の text は、query に答える根拠を含んでいるか。",
      "criteria": {
        "true": "items 之中任一項,直接說明了問題所需的值、條件、方法或窗口,僅靠 items 就能回答",
        "false": "items 雖然提到與問題相同的話題,但沒有寫出問題在問的事項本身;或只給出參照先(如「另行規定」「請向負責部門確認」);或是針對不同對象、不同事項的規定。要回答還需要未寫出的資訊"
      }
    }
  }
}
📊 結果
方法正確率接近命中的漏判率可回答的誤攔率額外時間額外成本Cohere Rerank 3.5 的閾值65.0%25.0%53.3%+0ms+$0Amazon Rerank 1.0 的閾值65.8%95.0%3.3%+0ms+$0Claude Haiku 4.598.3%2.5%1.7%+584ms+$1.04Jev99.2%0.0%1.7%+263ms+$0.05Cohere 會把四分之一的接近命中放過,卻把一半其實可以回答的問題擋掉。相反地,Amazon 誤攔雖然少,但有 95% 的接近命中直接放行。實際發生的就是這兩題。
問題答案是?搜尋第 1 名的 chunkCohereJev防災用備在那裡的儲糧,會在保存期限還剩多久時換成新的?沒寫「儲備的食物與飲水,在保存期限到期前更換成新的。儲備品的更換時期由總務部訂定」(防災備蓄品管理規程)0.8306 → 放行0.09 → 擋下要放長假了。大概要多久沒有登入系統,自己的 ID 會被停用?有寫「資訊系統部會停用連續 45 天沒有登入紀錄的帳號」(帳號・密碼管理規程)0.3305 → 擋下0.95 → 放行Cohere 的訓練資料規格寫著「所有問題至少需要 1 個正例」,因此對於預設答案一定存在的模型來說,要判斷沒有答案的問題也許本來就不容易。相對地,Haiku 和 Jev 都幾乎沒有漏判。Jev 的辨識能力高達 0.983,而且速度是 Jev 的 2 倍、價格只有 1/20。
💸 表面上看不到的巨大效果
其實,只要「無法回答」判定正確,後面的 LLM 呼叫就整個省掉了。這種省下來的成本不會出現在上表裡。讓 Haiku 4.5 生成回答時,每次大約要 1.5 秒,1,000 次要 $1.37。若拿一題無法回答的問題來比,會變成這樣。
判定回答生成合計Jev 不用―1,459ms1,459msJev 有263ms不呼叫263ms少於 1/5。就不必為了回一句「找不到資料」而讓使用者等 1.5 秒了。
成本更誇張。Jev 的判定在 1,000 個查詢只要 $0.05,而回答生成每次要 $0.00137。只要在 1,000 題中擋下 37 題,Jev 的費用就回本了。當然,可回答的問題會多出 263ms 延遲,但每擋掉 1 題的回報很大,所以如果有幾 % 的無法回答問題混在裡面,還是很值得導入。
🧩 驗證 3:重新排序和回答判定,能不能一起做?
講到這裡就會開始貪心了 既然 Jev 能平行處理問題,那是不是可以把重新排序與回答判定合併成 1 次請求?於是我對每個 chunk 同時送出 2 個問題。
{
  "model": "jev-1.13.0",
  "state": {
    "query": "育嬰留停中的社會保險費減免,最晚要什麼時候申請?",
    "items": [
      { "id": "item_0", "title": "育児・介護休業規程", "text": "育児休業期間中の社会保険料は、本人の申出により免除される。手続きは人事部にて行う。" }
      // … item_19まで
    ]
  },
  "questions": {
    "rel_0": {
      "type": "score",
      "instructions": "item_0 の text は、query にどれくらい関連しているか。",
      "criteria": ["0 - 無關。…", "1 - 與同一領域有些關聯…", "2 - 同一對象,但不同事項…", "3 - 同一對象、同一事項…"]
    },
    "ans_0": {
      "type": "noul",
      "instructions": "item_0 の text は、query に答える根拠を含んでいるか。",
      "criteria": {
        "true": "該 item 的 text 直接說明了問題所需的規則、條件、數值、程序或負責人",
        "false": "該 item 的 text 雖然提到與問題相同的話題,但沒有說明問題所需的規則、條件、數值、程序或負責人;或是別的話題"
      }
    }
    // … item_19まで、チャンクごとに2問ずつ(計40問)
  }
}
如此一來,就能在重新排序的同時,若 noul 最高分的 chunk 連 0.755 都不到,就判定無法回答。增加的只有 yes/no 問題,請求次數仍然只有 1 次。
我比較了 3 種架構。
架構nDCG@5回答判定正確率速度1,000 查詢成本① 重新排序器 → 重新排序分數閾值0.88465.0%198ms$2.00② 重新排序器 → 用 Jev 判斷是否可回答0.88499.2%468ms$2.05③ 只用 Jev 一次完成重新排序+回答判定0.96099.2%292ms$0.34③ 的回答判定與② 完全一致,排序也比①②更好。速度是② 的 6 成,價格是 1/6。因為把 reranker 的呼叫整個省掉了,效果很明顯。
🚪 驗證 4:把非目標問題擋在門外
在 RAG 檢索裡,像「今天晚餐吃什麼好?」或「sdfghjk」這種無關或毫無意義的問題,其實根本不需要去搜尋。
所以我在搜尋前先用 Jev 問「這題是否屬於目標範圍?」若判定為非目標,就把 Embedding、搜尋、重新排序、LLM 全部跳過。
{
  "model": "jev-1.13.0",
  "state": { "query": "今天晚餐吃什麼好?" },
  "questions": {
    "gate": {
      "type": "choice",
      "instructions": "使用者的問題屬於哪個分類。",
      "criteria": {
        "in_scope": "關於在這家公司工作的事,員工會問公司內部 help desk 的問題。help desk 處理的內容是… ← 把會處理的規程全部寫出來(見下方 note)",
        "out_of_scope": "與在這家公司工作明顯無關。閒聊、一般知識、娛樂、料理、私人生活、公司內部 help desk 不受理的操作指南類問題",
        "unclear": "沒有意義的輸入,或單看無法判斷在問什麼的發言"
      }
    }
  }
}
回傳的是所選標籤及各標籤的機率。通過條件是「機率最高的標籤是 in_scope」,不使用閾值。
{ "gate": { "type": "choice", "choice": "out_of_scope", "confidence": 1.0,
            "probabilities": { "out_of_scope": 1.0, "unclear": 0.0, "in_scope": 0.0 } } }
criteria 就是各標籤的說明文字。目標範圍不是從語料去猜,而是直接用文字寫清楚這個系統是用來回答什麼的。
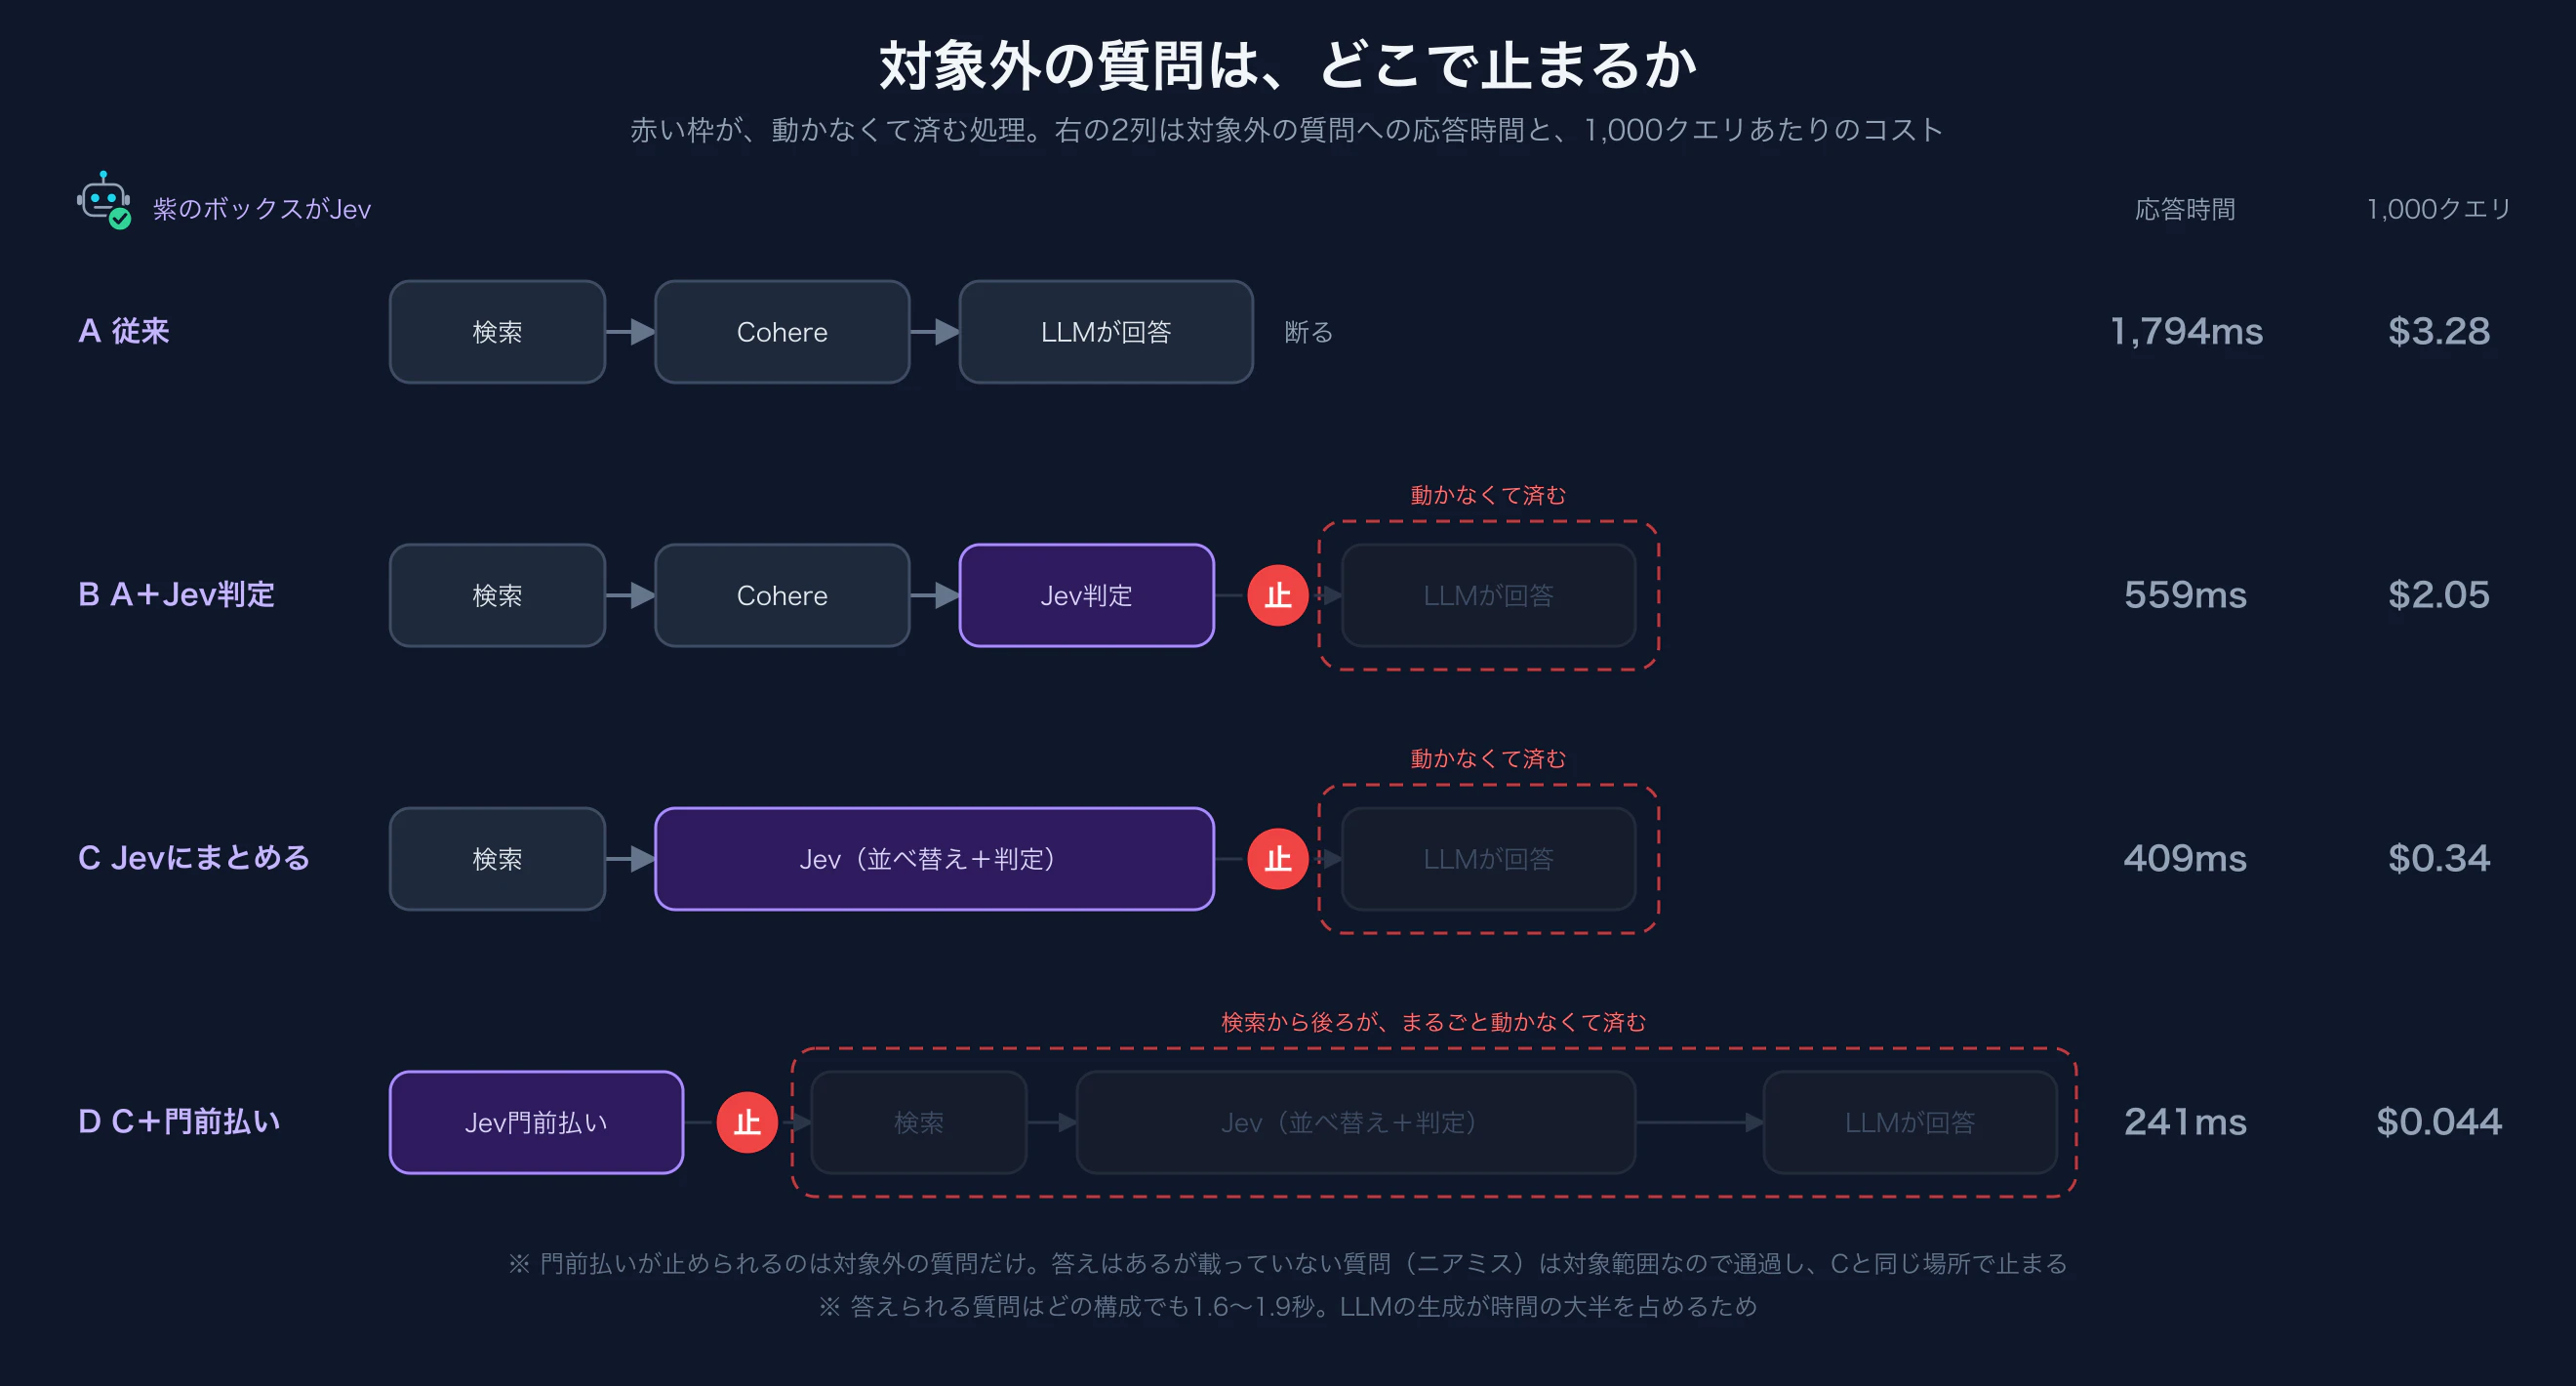
架構非目標問題的回應時間1,000 筆成本不先擋下(搜尋→重新排序→LLM 拒答)1,794ms$3.28Jev 先擋下241ms$0.044只需要問 1 題,所以很快就回來了。因為不必流向搜尋與 LLM,價格變成 1/75。
精度方面,在 100 題目標範圍問題中,誤擋了 2 題。20 題無關問題中,擋下了 19 題。沒擋住的 1 題是
「請寫一個用 Python 每晚備份照片資料夾的腳本」
似乎被我在目標範圍中寫的「資料備份」影響到了。
10 題沒有意義的輸入全部被判為 unclear。不過像「請詳細說明」這種續接式發話也有 5 題全都判成 unclear。是否為首次提問或延續對話,應用端本來就知道,所以在續接時建議把對話歷史一起送入,或者直接跳過門前攔截。
目標範圍的寫法會明顯影響成績。最初只寫「人事、會計、總務、IT、安全衛生」5 個詞,結果 34 題中有 5 題被誤擋。像「得了流感後幾天不能去公司?」這種沒有出現公司或規程字樣的問題就被擋掉了。
改成把會處理的規程全部寫出來之後,就變成 0 題誤擋。實際使用的 in_scope 如下:
關於在這家公司工作的事,員工會問公司內部 help desk 的問題。help desk 處理的內容包括:休假與出勤、育嬰留職停薪與介護留職停薪、喪假與慰問金、人事評價、招募與試用期、留職停薪、離職。通勤費與出差費、費用報銷、預支款與零用金、發票與付款、文具與設備採購、公司卡、預算。員工福利、識別證等借用品、會議室與公務車、郵件與宅配、來訪者、出入館、災害備品。資訊安全、帳號與密碼、借用筆電、軟體、遠端連線、電子郵件與聊天工具、系統故障與資安事件、資料備份。健康檢查、壓力檢測、產業醫師、長工時、職災與通勤職災、傳染病、避難訓練、辦公室環境。即使措辭很口語,即使沒有出現公司或規程這些字,即使規程裡沒有直接寫答案,只要屬於這裡也算
不是靠語料讓模型自己猜,而是直接把系統要回答什麼用文字說清楚。只有 5 個詞不夠。
💰 總結:速度與成本
把 Jev 放進去的 3 個位置,分別列出導入前後的變化。
Jev 放置位置要做的事速度1,000 筆成本重新排序取代 Cohere198ms → 290ms$2.00 → $0.25(1/8)判定無法回答在呼叫 LLM 前停下1,459ms → 263ms(快 5.6 倍)$1.37 → $0.05(1/27)門前攔截在搜尋前停下1,794ms → 241ms(快 7.4 倍)$3.28 → $0.044(1/75)第 1 行是所有查詢,第 2 行是沒有答案的問題,第 3 行是非目標問題,皆以每 1,000 筆計算
重新排序是替換式,所以比較對象是 Cohere。速度反而稍微輸了,真正有感的是價格,但即使如此也能變成 1/8。剩下兩項則是加法,拿來比較的是「沒有導入 Jev 時」:
- 判定無法回答:在搜尋與重新排序都完成後,只阻止 LLM → 1/27
- 門前攔截:連搜尋都不做就阻止 → 1/75
擋得越前面,效果越大。
判定本身也要花錢。1,000 個查詢要 $0.05。不過只要每擋下 1 次 LLM,就省下 $0.00137,因此 1,000 題中只要擋下 37 題(3.7%),判定成本就打平了。若有更多無法回答的問題混在裡面,剩下的就是整體賺。
🍜 結語
看來用 Jev 來改善 RAG 速度、降低成本是可行的。體感上會覺得特別快的,大概只會出現在非目標、範圍外的問題上。(畢竟一旦進了 LLM,還是得等)
把以前交給 LLM 判斷的部分改由 Jev 處理,延遲與成本都會下降。另外,若能在搜尋前先擋掉,就不只是讓判斷更快,而是連後面的流程都整個不必跑,效果更大。把無法回答的問題在前面攔下來,搜尋、重新排序、LLM 都不會動。
不過,如果把不該擋的問題擋掉,會有信任上的問題。這裡必須謹慎設定閾值。另外,對於正確問題也會帶來一些延遲/成本,因此最好先根據實際數據分析「無法回答」問題大概有多少,再決定是否導入。
至於重新排序的精度,這次的資料無法下定論。因為手工製作的小型語料差異沒有完全拉開,所以若要判斷是否導入,還是必須用實際資料仔細測量。
雖然這次還沒驗證,但像下面這些用法也很有趣,之後我還想繼續測看看。
[LLM 的模型選擇]
如果在重新排序時採用 Jev,能刪掉不必要的 chunk,留下更純、更可能導向答案的 chunk;如此一來,原本用 Sonnet 才能處理的工作,也可能用 Haiku 就足夠。延伸應用上,也許可以根據回答判定的信心分數,將 Sonnet/Haiku 等模型分流,做出最佳模型選擇。
[護欄判定]
這次的門前攔截偏向白名單式用途,但也可以想成黑名單式的護欄用途。這部分看起來也可用 Amazon Bedrock Guardrails 代替,因此應該也很值得做比較驗證。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

