
接deepseek v4.1flash之前,有一件事比「新模型強不強」更容易被忽略:deepseek-flash這個別名從10月17日起指向新版,呼叫方式和單價都沒變,也不會回報任何提示。舊程式碼照跑,用的已經是1017。
如果程式裡有寫thinking,那升級是可控的;如果沒有,那從10月17日起,你的請求一律預設開啟思考模式。本篇把接入時會碰到的設定整理成一份可以直接對照的筆記:預設值、強度映射、不生效的參數、多輪工具調用要回傳什麼,最後附上幾個容易踩的坑。
底下標「實測」的數字,來自2026年11月19日我在Crazyrouter上以deepseek-v4.1-flash呼叫的結果;標明出處的,則是公開資料,我沒有逐條重跑。
一、先記住預設值
官方《思考模式》文件寫明:
| 項目 | 預設 | 說明 |
|---|---|---|
| 思考模式 | 開啟 | 不傳thinking就是開著 |
| 思考強度 | high | 用reasoning_effort調整 |
| 可選強度 | low / high / max | 三檔 |
| 關閉思考 | {"thinking":{"type":"disabled"}} |
low不等於關閉 |
reasoning_effort傳入其他名稱時會映射,不會報錯:
minimal、low→ lowmedium、high、xhigh→ highmax、ultra→ max
也就是說,把medium和high當成兩套不同預算來做對照,實驗結果會失準,它們走的是同一檔。
實測:在Crazyrouter上不傳thinking連發18次,17次回應帶reasoning_content,和預設開啟一致;low、high、max三個值都能正常回傳;傳入不存在的值,回傳400。
二、思考模式下不生效的參數
這一節是接入時最常被忽略的部分。官方文件寫得很清楚:
temperature、presence_penalty、frequency_penalty在思考模式下無效。為了相容舊軟體,設定不會報錯,但也不會生效。top_p只有在思考模式下才生效,有效範圍0.95–1.0;低於0.95會按0.95處理。非思考模式下top_p固定為1.0,傳入值被忽略。
如果你的流程依賴temperature=0保證格式或輸出穩定,接1017之前要先改掉這個假設,改用輸出側校驗或重試。
三、多輪工具調用要回傳的內容
帶tools的請求,規則和一般多輪對話不同:
- 請求帶
tools:歷史輪次的reasoning_content都要完整回傳,會被拼接進上下文。 - 請求不帶
tools:reasoning_content不用回傳,傳了也會被忽略。
官方文件在工具調用一節的原話是,帶了tools的請求,後續所有請求都必須完整回傳reasoning_content,沒回傳API會回傳400。
實作上最省事的做法是直接把整條assistant訊息追加進messages,不要只挑content和tool_calls傳。用OpenAI SDK的話,response.choices[0].message本身就帶著content、reasoning_content、tool_calls三個欄位,原樣append就好。
實測:在Crazyrouter上刻意不回傳reasoning_content,第二輪沒有報錯,正常回答了。這和官方說的400不一樣,中轉的行為可能不同。所以照官方寫法回傳,是唯一在兩邊都不會出事的做法。
四、思考開著,多花多少
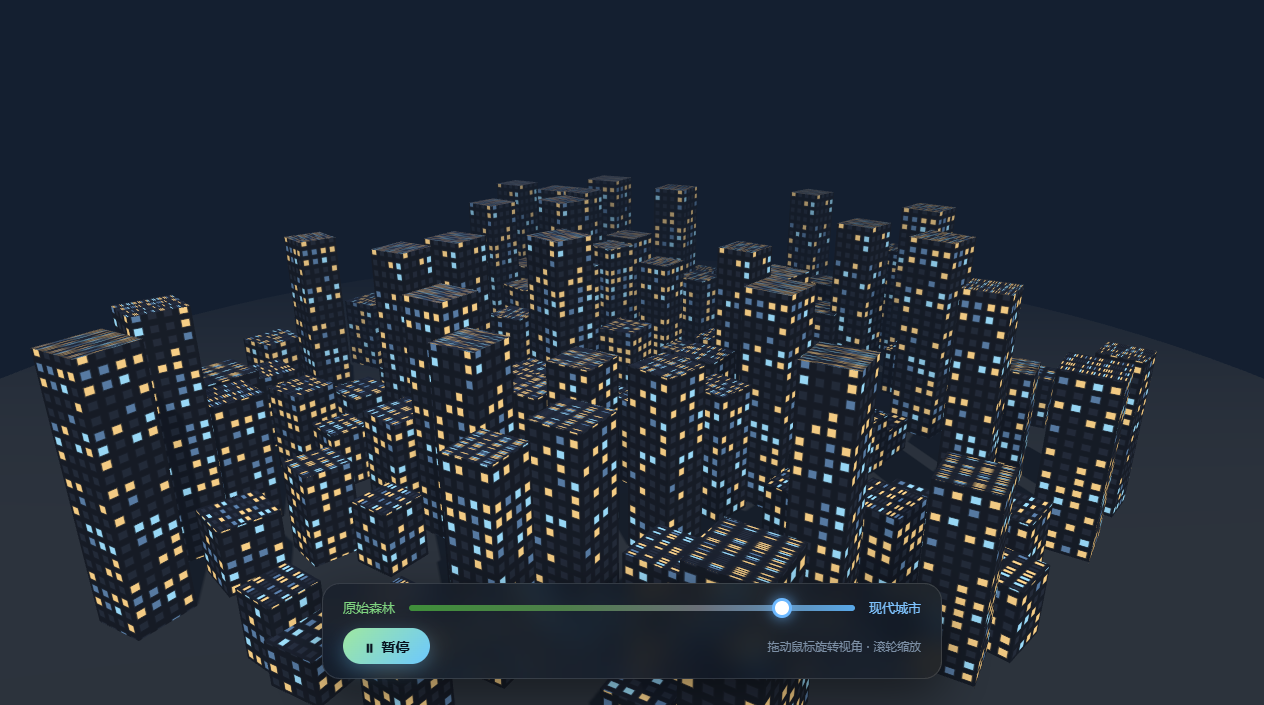
時間和輸出量都會上去。實測讓同一句話生成單檔網頁,各跑關閉與開啟:
| 頁面 | 關閉思考 | 開啟思考 |
|---|---|---|
| 網頁賽車 | 7704 token,39.6秒 | 21155 token,100.2秒,首字48.8秒 |
| 咖啡儀表板 | 6514 token,28.1秒 | 27050 token,163.8秒,首字127.8秒 |
| 森林到城市3D | 6599 token,31.2秒 | 20554 token,137.1秒,首字116.2秒 |
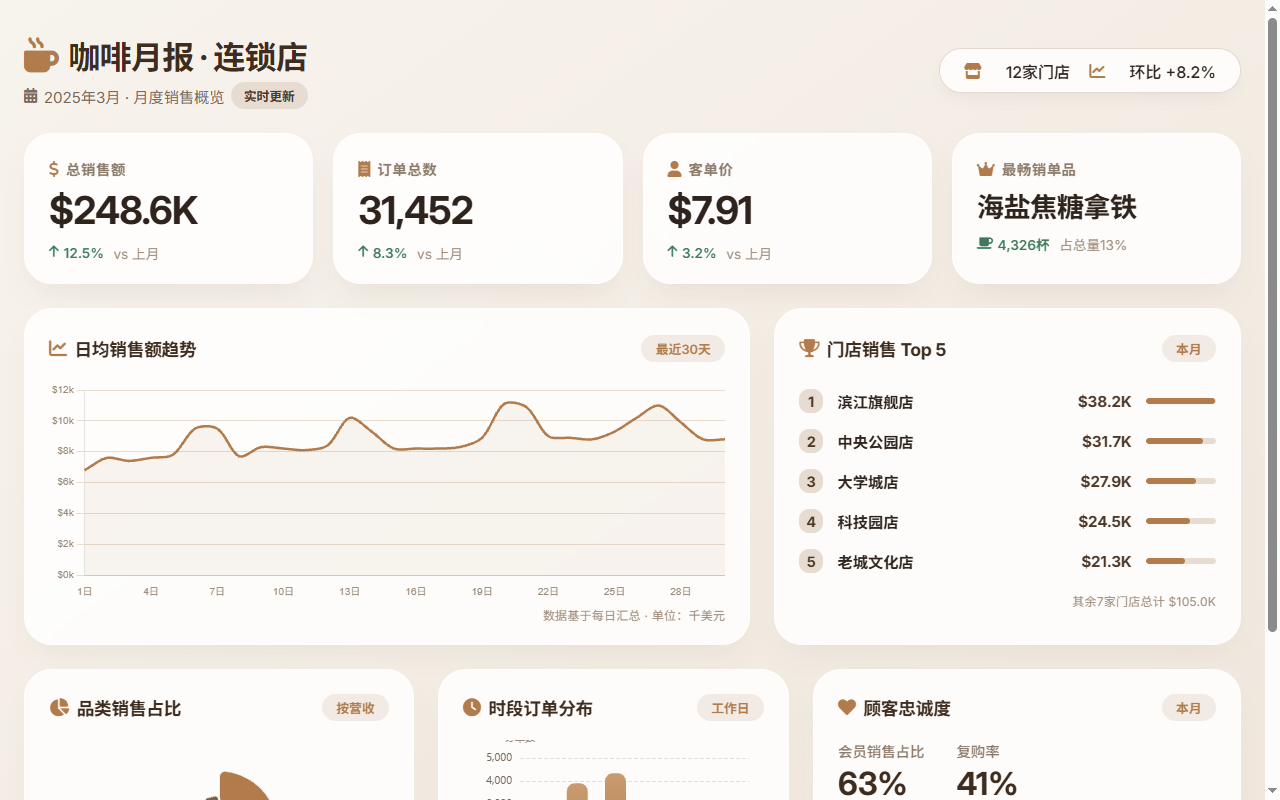
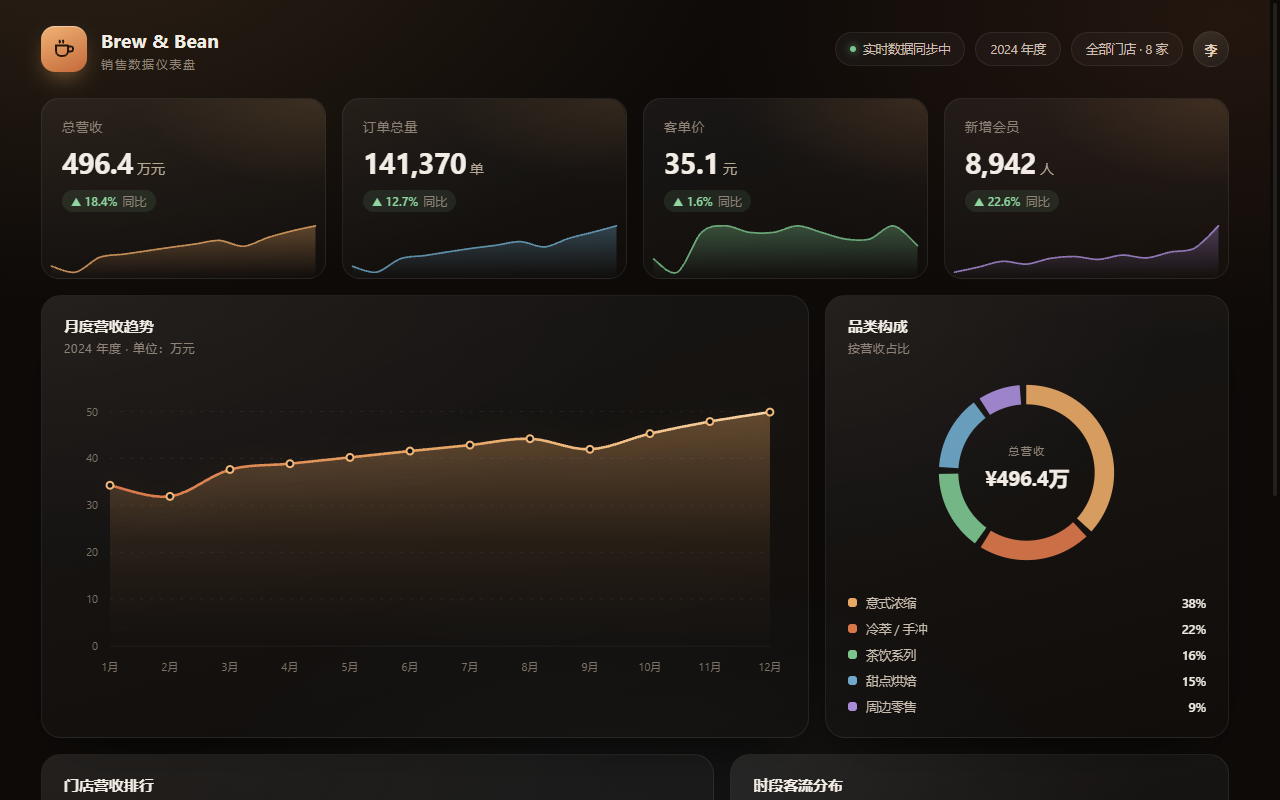
輸出量是關閉時的2.7到4.2倍,首字要等一到兩分鐘。代價換來的是完成度:儀表板從依賴四項外部資源、以美元計價,變成純內聯SVG、單位改成萬元,指標卡還帶迷你曲線;賽車從俯視三車道變成偽3D公路。
五、強度拉到max,值不值
這題我沒有自己跑大樣本。公開的Bug Hunt Bench有1017配Claude Code的三檔結果:在兩個真實程式庫埋105個bug,一輪內找出並修好,按隱藏答案盲評。以下經peng轉引,帳單我以low為1換算:
| 強度 | 修好數(共105個) | 相對帳單 |
|---|---|---|
| low | 34.4 | 1 |
| high | 36.4 | 約1.15 |
| max | 39.1 | 約1.42 |
max比low多修4.7個,帳單多四成多。但這組數據有個提醒:作者最早三次跑max,分別是34、37、45,單次波動比檔位差距還大。同一個任務至少跑三次再下結論。
另外,官方9月版的發布說明寫明,Code Agent類基準使用max檔、top_p=0.95、temperature=1.0;1017的更新日誌沒有再寫檔位。拿預設的high去對照官方榜單分數,可能對不上。
六、換框架、換工具,結果都會變
同一個1017,套不同外殼,分數和帳單差得比想像的大。Bug Hunt Bench公開的結果(max檔,每格跑5到7次取平均,經peng轉引),帳單以Claude Code為1:
| 框架 | 修好數(共105個) | 相對帳單 | 耗時 |
|---|---|---|---|
| DeepSeek Harness | 42.7 | 約1.8 | 62分鐘 |
| Pi | 42.2 | 約0.8 | 54分鐘 |
| Claude Code | 39.1 | 1 | 58分鐘 |
| OpenCode | 37.6 | 約0.95 | 56分鐘 |
| 上一版V4.1 Flash + Claude Code | 21.7 | 約0.77 | 56分鐘 |
同一框架下,上一版21.7、1017是39.1,升版本本身就有明顯提升。框架對榜單分數的影響同樣直接:同樣是1017的Terminal-Bench 4.0,官方在Claude Code裡測出42.3,Vals AI用只有bash的mini-swe-agent測出31.82,差10分。
還有一個容易被忽略的行為變化。karminski在10月24日的實測提到,新版做事有代價時傾向於不做,和上一版差別明顯,把flash接進自己Agent框架的人應該單獨做適配。他推測是為DSH調整的,具體表現在他的影片裡,我只看到貼文原文。
七、接入檢查清單
按這個順序過一遍,能避開大部分問題:
- 確認預設值。不傳
thinking就是開啟、high。要快,顯式傳{"type":"disabled"}。 - 固定參數重跑一次。別人的分數、別人的建議都只是起點。
- 清掉對
temperature的依賴。思考模式下它不生效,格式靠輸出側校驗。 - 工具調用原樣回傳assistant訊息。不要把
reasoning_content濾掉。 - 用真實任務核算帳單。官方說「輸出更短」是按任務完成口徑,不是按單次請求。什麼值得買的綜述轉述:同一個專案用一字不差的提示詞重跑,新版輸出45.6萬token,舊版22.7萬,原因是新版更頻繁截圖自檢、一輪一輪改。這是轉述,我沒核對原帖。
- 直連官方用Claude Code,模型變數要設全。peng引用官方文件:只改
ANTHROPIC_BASE_URL和Key,Opus系列模型名會映射到deepseek-v4-pro並按Pro計費。去用量明細看扣費模型是不是deepseek-flash。
八、這次測試的邊界
我用的是Crazyrouter的OpenAI相容格式,Base URL:
https://api.crazyrouter.com/v1模型名填deepseek-v4.1-flash。帳號能不能調到這個型號,可以先在Crazyrouter模型目錄核對是否在列;其他接入資訊見 Crazyrouter模型目錄。
要說清楚的邊界:
- Crazyrouter的
deepseek-v4.1-flash沒有標注對應哪一版權重,我無法證明它服務的是1017。文中我自己的數據,只描述「在這個模型名下的表現」。 - 樣本很小,多數項目各跑一次,沒有做統計顯著性。
- 第三方數據(Bug Hunt Bench、Terminal-Bench的差異、格式約束的補測)都是轉引,出處見下。
九、結論
- 先看預設值。思考預設開啟、強度預設high是這次升級最容易踩的坑。
- 強度按任務選。簡單活關著或用low,日常用high,複雜任務再上max。max相對low多修四成多,帳單多四成多,單次波動還比這個差距大。
- 要成品感再開思考。我的對比裡成品更完整,代價是多等一兩分鐘、輸出量多兩到四倍。
- 接自己的Agent先重測。別名已換版本;工具調用要回傳
reasoning_content;temperature不生效;格式約束加校驗。 - 放手的範圍。抽欄位、讀圖取數、有測試可驗證的小儲存庫修復,這幾次都沒有出岔子。框架一換分數會變,比較要在同一個測試裡做。
資料來源
- DeepSeek官方,《更新日誌》,2026年10月17日條目
- DeepSeek官方,《DeepSeek-V4.1-Flash-1017發布》,2026年10月17日
- DeepSeek官方,API文件《思考模式》,2026年11月19日查閱
- peng,《DeepSeek V4.1 Flash 1017接入Claude Code:配置、價格與4個省錢設定》,2026年10月26日,文中轉引Paweł Huryn的Bug Hunt Bench公開結果
- karminski,X平台 @karminski3關於DeepSeek-V4.1-Flash-1017實測的貼文,2026年10月24日
- 什麼值得買,《DeepSeek V4.1 Flash-1017版本更新避坑:提示詞適配與相容性提醒》,2026年10月19日,綜述自知乎等平台文章
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

