
Claude Opus 4.8是Anthropic在2026年5月推出的模型;GPT-5.6 Sol屬於OpenAI的GPT-5.6系列。兩家公司都提到寫程式這項用途。如果你只是想請AI做一支處理Excel表格的小工具,面對這兩款模型,很難從名稱判斷哪一個比較適合自己。我也想知道:它們寫出的工具能不能接進日常工作,出錯時會不會讓人誤用舊資料?模型背景可以分別看Anthropic的發布說明與OpenAI的系列介紹。
我讓兩款模型各寫一支小程式:把商品表格轉成另一支程式可讀的檔案。兩款的第一版都曾在輸入和輸出指向同一檔案時蓋掉原表格;把問題回饋給它們後,修訂版都能擋下這種操作。如果你正在挑模型,這次的結論不是誰全面勝出,而是兩款都能幫你做出小工具,仍須用自己的資料試跑,尤其要看失敗後留下什麼。
GPT-5.6 Sol與Claude Opus 4.8要幫你轉的是什麼?
假設你從Excel匯出商品清單,第一列是「商品編號、商品名稱、價格、庫存」。匯出的CSV還是一張表,只是欄位用逗號分開。下一支程式要讀的JSON則像一份有標籤的商品資料:每件商品有編號、名稱、以整數「分」表示的價格,以及庫存。例如0.29元要寫成29分;庫存0代表售完,不能當成空白刪掉。
兩款模型都能依需求產生可在自己電腦執行的Node.js程式。Node.js是執行這份程式所需的軟體,你可以把程式存為import-products.cjs,以後每次換一張同格式的新表格,再執行一次。初版處理正常商品資料與引號內逗號、換行都能得到預期結果;遇到檔案安全問題回饋修改後,兩份修訂程式各用23種檔案情形檢查,結果符合原先約定。這些是同一項小工具的多種輸入,不能當作23次獨立模型挑戰。
GPT-5.6 Sol與Claude Opus 4.8出錯時,舊檔案為什麼還在?
想像每天跑一次轉檔。今天的表格把價格填成12.3,但工具要求兩位小數,應寫成12.30。為了不破壞先前的結果,工具報錯後會留下原本的JSON。這樣保護舊檔是合理的;如果下一支程式只看到「JSON檔案還在」就繼續讀,卻可能把舊商品當成今天的新資料。
我在本機先放了一份模擬上次成功輸出的有效JSON,裡面是編號OLD的商品,再把錯誤價格交給兩款修訂工具。它們都回報失敗,預置JSON也都沒變。這是用合成資料模擬的情境,不是實際執行過每日排程。
要避免誤讀,可以在命令列把兩步接起來。&&的意思是「左邊成功,才執行右邊」:
node import-products.cjs products.csv products.json && node consume-products.cjs products.json我用錯誤價格實際跑過這個串接,第一步失敗後,第二步沒有啟動。consume-products.cjs是我另外補寫的簡單讀取程式,用來列出庫存為零的商品編號:
const fs = require('node:fs');
const products = JSON.parse(fs.readFileSync(process.argv[2], 'utf8'));
if (!Array.isArray(products)) throw new Error('預期讀到商品陣列');
console.log(products.filter(product => product.stock === 0).map(product => product.sku));正常輸入兩件商品,其中A02庫存為零時,它印出[ 'A02' ]。這只示範「成功轉檔才往下讀」,不是完整的資料庫匯入;真正接入系統還要核對欄位與資料寫入結果。
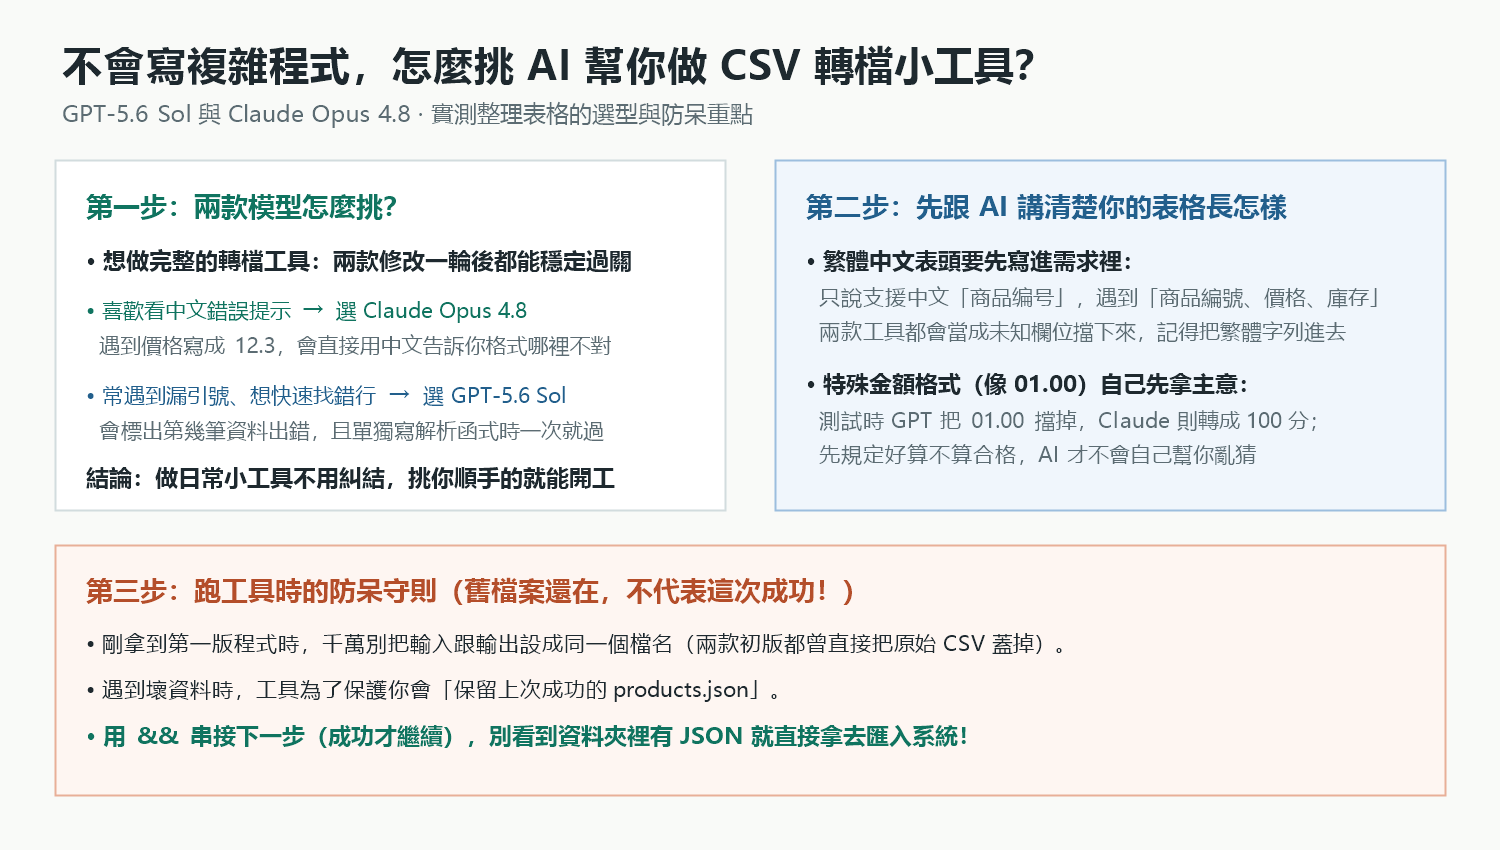
圖:本次小工具的選擇線索,以及避免蓋掉原表格、誤讀舊結果的做法。
GPT-5.6 Sol與Claude Opus 4.8遇到繁體表頭,該怎麼選?
還有一件事比模型名稱更直接:你的表格實際長什麼樣。當時給模型的中文需求列的是簡體欄名,例如「商品编号、商品名称、价格、库存」。我再拿下列繁體欄名測試修訂程式:
商品編號,商品名稱,價格,庫存
A01,馬克杯,12.30,7兩款都回報不認得欄名,舊輸出沒有改動。問題在表頭允許清單沒寫繁體字,並不是商品名稱「馬克杯」不能存。若平常拿到的是繁體表格,就要把「商品編號、商品名稱、價格、庫存」明寫進需求,請模型修改後再拿原表試一次;我沒有測過那份尚未產生的修改版。
價格格式也值得先說定。我拿01.00測試:GPT-5.6 Sol寫的工具拒絕,Claude Opus 4.8寫的工具接受並轉成100分。兩款算出的金額沒有衝突,差別是原需求沒規定整數部分可不可以多一個0。這種規則最好由使用資料的人決定,不能讓模型替會計或結帳流程猜。
若你重視錯誤訊息的可讀性,本次Claude程式對錯誤價格給了中文說明,但用的是簡體字;若你常要在長表格中定位漏掉的引號,本次GPT程式的英文訊息附了出錯記錄號。這只是這兩份生成程式的表現,兩邊都可以再要求改進。選模型之前,先拿備份表格各試一次,看看哪一份輸出和提示符合你的工作方式。
2026年11月3日,我透過Crazyrouter的https://api.crazyrouter.com/v1/chat/completions呼叫gpt-5.6-sol與claude-opus-4-8;兩款各收到一次相同的簡體中文初始需求,以及一次針對首版問題的修改要求。生成的程式未經人工改寫,本機使用Node.js v24.21.0。這次沒有測試大型檔案、正式排程、資料庫交易或繁體提示詞生成能力。
要自己重跑,可以從程式設計模型目錄核對型號,再看API串接文件。先準備一份沒有敏感資料的備份表格,寫清楚欄名、金額格式,以及「轉檔失敗時不能動哪些檔案」。這些條件會比只問「哪個模型比較強」更直接影響工具能不能用。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

