
工程師常遇到一種落差:在聊天視窗裡拿到一段合理的程式碼,貼回專案後卻發現型別、既有介面或測試都對不上。問題不一定是那段回答「不會寫」,而是任務需要的脈絡在整個儲存庫裡。這時選ChatGPT或Codex,可以先問自己:我要一個可討論的答案,還是一份能在專案中檢查的實際修改?
ChatGPT與Codex各自擅長什麼?一張對照先對齊目標
兩者的能力範圍確實有重疊,但實際動手時關注點不同。先用一張表把常見任務攤開來看:
| 任務類型 | 先用ChatGPT | 先用Codex |
|---|---|---|
| 釐清問題 | 解釋概念、比較方案、整理資料 | 進入專案追蹤呼叫鏈、定位實際實作 |
| 產出內容 | 起草郵件、報告、整理表格結論 | 在儲存庫裡修改文件、設定或程式碼並檢查diff |
| 處理程式 | 解釋錯誤訊息、給示範片段 | 在獲授權的專案裡修改檔案、執行命令與測試 |
| 驗收重點 | 核對事實、來源與數字 | 核對檔案差異、測試輸出與未驗證範圍 |
舉例來說,只有一段報錯訊息、還沒拉下來的專案時,ChatGPT能幫你排可能的原因與下一步要收集的證據;已經有專案、重現步驟與測試命令時,把實作交給Codex處理會更直接。兩種入口都需要你提供足夠脈絡,不會因為按了送出就自動完成驗收。
ChatGPT與Codex:先確認脈絡在哪裡
若你正在釐清需求、解讀錯誤訊息,或比較幾種實作方向,ChatGPT很適合當作討論起點。提供重現條件、相關訊息與已知限制,請它標出推測與證據;取得結論後,再回到原始檔案與文件核對。OpenAI的ChatGPT使用說明涵蓋問答與處理材料等工作,並沒有把它限縮成單純聊天。
若任務已經變成「在這個專案裡完成修改」,Codex比較能承接實作流程:讀取獲准存取的檔案、找出相關呼叫路徑、修改程式碼或設定,接著執行既有檢查並呈現差異。OpenAI的Codex文件介紹了它在開發環境中的使用方式。它能完成哪些步驟,仍取決於你提供的專案、權限與可用工具。
兩者的能力有交集。ChatGPT可以解釋程式碼,Codex也可以討論設計;決定入口的關鍵是交付物與驗收方式,而不是「哪一個比較聰明」。
ChatGPT怎麼用:把問題與材料先整理好
當我希望先把一件事想清楚時,會直接在ChatGPT裡把場景寫出來:
「這段API日誌裡有哪些可能的失敗原因?請先依證據強弱排序,再列出我還需要補的資訊。」
也可以把文件丟給它做摘要、比較、起草或分析。要它交付一份可用檔案時,就把輸入材料、處理規則、輸出格式與檢查標準一次說清楚;拿到結果後,打開檔案核對數字、引用與格式。ChatGPT能不能存取某個檔案、網頁或外部工具,取決於目前入口、帳戶權限與你實際授予的範圍。
它也能討論程式碼、甚至寫出一段示範。但「給我一段看起來能用的程式碼」與「在我的專案裡改完並通過測試」是兩件事。前者可以在聊天視窗裡完成,後者需要真正的專案脈絡與執行結果。
Codex怎麼用:把改動落到檔案與測試
Codex適合目標明確、要在開發環境執行的任務。例如:
「登入API在空白使用者名稱時回傳500。請先找到重現路徑,保留現有回應格式,修正後補上相關測試並執行;最後列出修改檔案與未驗證的部分。」
這類描述把行為、範圍、限制與驗收方式一次寫清楚。Codex可以在獲准存取的專案環境中讀取檔案、修改程式碼、執行既有工具,再把diff與測試結果交給你審查。OpenAI也提供桌面應用、命令列與IDE等Codex入口,實際使用方式以你的帳戶與環境為準。
不寫程式碼也可能用到Codex。文件、設定放在儲存庫裡,改完要通過build check,它的檔案差異與命令執行就有價值。但要分清楚:diff出現了不代表已經正確。測試通過、測試未執行、尚未人工檢查的部分要分別記錄,再決定是否合入主幹。
把ChatGPT與Codex用在同一個修正流程
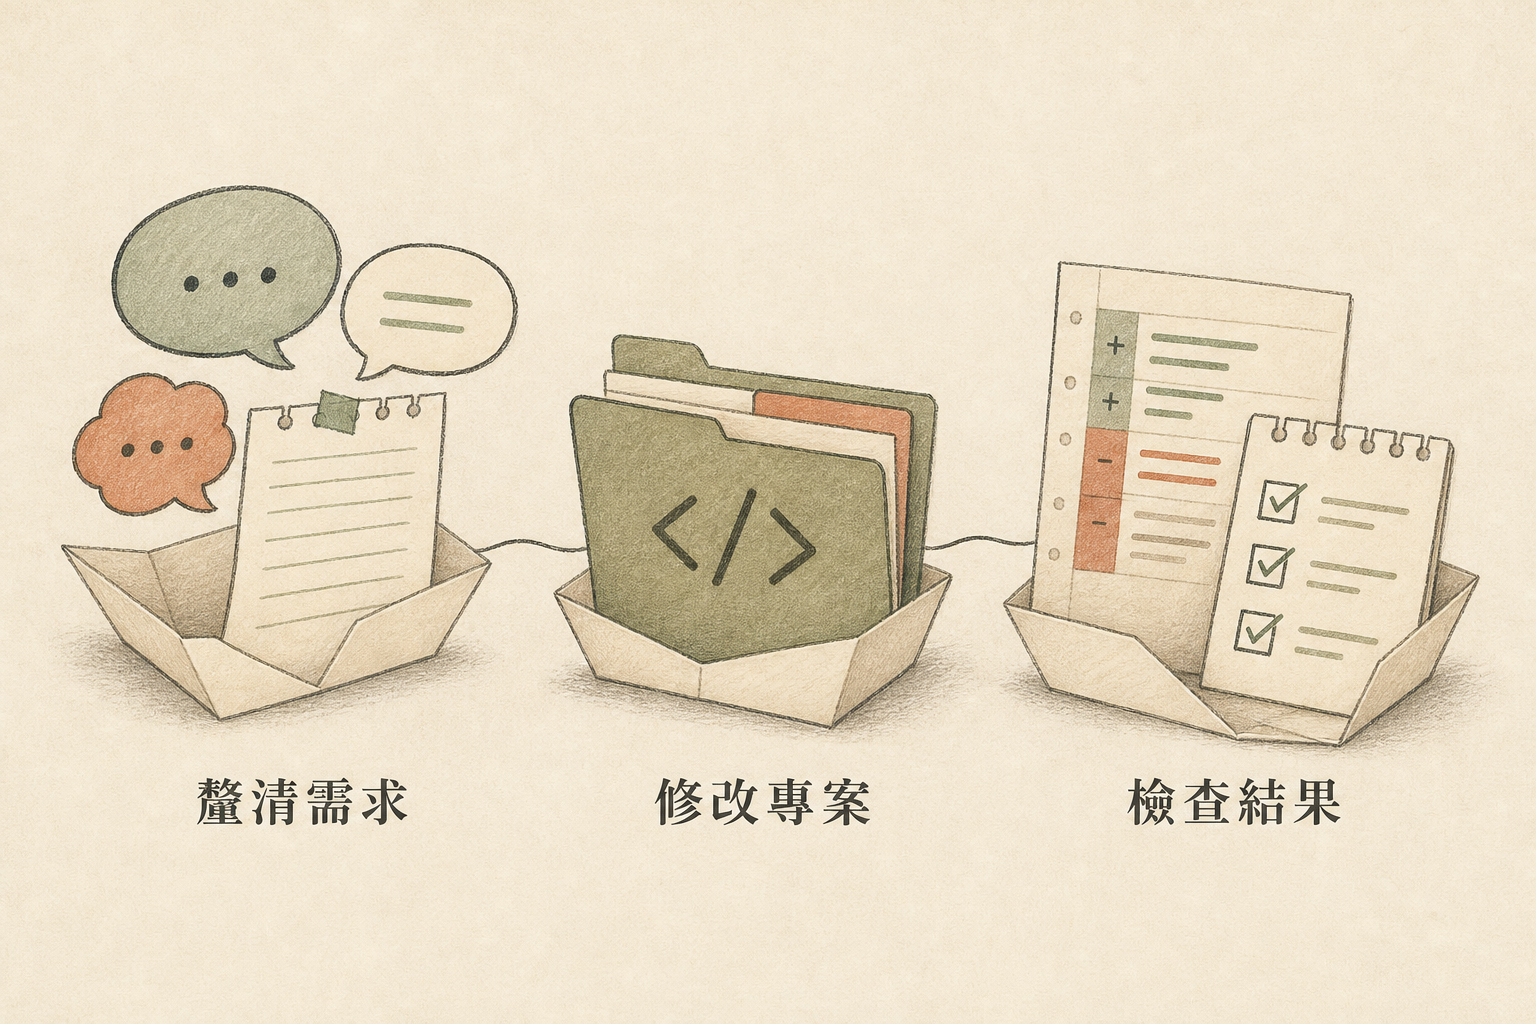
假設登入API遇到空白使用者名稱時回傳500。先釐清預期狀態碼、既有回應格式與可重現步驟;這些事可以在ChatGPT中討論,也可以直接從專案規格確認。接著把範圍交代給Codex:
目標:修正空白使用者名稱造成的500回應。
範圍:登入端點、驗證邏輯與相關測試。
限制:保留現有回應格式,不修改無關模組。
驗收:先加入能重現問題的測試,執行相關測試,列出修改檔案、執行命令與未驗證範圍。這個要求比「幫我修bug」多了可操作的邊界。你仍要看diff:測試是否在修正前能重現、錯誤分支是否真的改對、其他輸入是否受到影響。若測試沒有執行,請把它當成未完成的驗收項,而不是把模型的文字說明當作執行紀錄。OpenAI的提示指南可作為描述目標與限制的參考。
ChatGPT與Codex可以互相替代嗎?
能力有交集,但要替代時可以用三個問題過濾:
- 材料在哪裡?只有一段文字或上傳的檔案,聊天入口通常就夠;任務依賴整個專案的檔案關係,交給Codex更順。
- 交付物在哪裡?結果是一段解釋或一份報告,先看ChatGPT;要改儲存庫、提交前審查diff,先看Codex。
- 怎樣確認完成?文字任務核對事實、數字與來源;開發任務還要看命令、測試、diff與剩餘風險。
桌面應用裡的Codex突出開發細節(命令、Git差異、審查視圖),它不是「更進階的聊天框」,ChatGPT也不是「只能聊天」。選擇時以任務需要為準,不預設一個名字更高級。
ChatGPT、Codex與模型API不是同一層
開發者還會遇到另一個混淆:聊天產品、專案工具與模型API都可能出現同一個模型名稱,但一次API呼叫成功,只代表該請求得到了回應,不代表專案已經完成修改與驗收。
我在2026年10月29日透過Crazyrouter的https://api.crazyrouter.com/v1/chat/completions送出一次中文摘要請求,指定gpt-4o-mini。結果是HTTP200,回應模型gpt-4o-mini-2024-07-18,finish_reason為stop;輸入53 tokens、輸出15 tokens。不過要求是20個漢字以內,實際輸出有22個漢字。這筆紀錄只能證明當次API有回應,但字數限制未通過;它沒有測試ChatGPT或Codex,更不是兩者的效能比較。Crazyrouter的Chat Completion文件可查請求欄位與回應格式。
尚未安裝Codex的話,先從OpenAI的Codex官網選擇適合的入口,以一個小型、可重現的專案問題試跑。等到真的需要替Codex CLI設定第三方API,再依Crazyrouter的Codex CLI串接教學處理;第三方API的設定與OpenAI產品帳戶的權限、用量應分開確認。
第一次使用ChatGPT與Codex,可以這樣描述任務
給ChatGPT的材料分析任務:
目標:比較三份報價,給出採購建議。
輸入:使用我上傳的三份報價單。
規則:統一幣別與稅費口徑;缺失項單獨列出,不猜測。
交付:一張對照表與300字以內的建議。
驗收:每個關鍵數字註明來自哪份報價單。
給Codex的專案任務:
目標:修正登入API在空白使用者名稱時回傳500的問題。
範圍:檢查端點、驗證邏輯與相關測試。
限制:保留現有回應格式,不修改無關模組。
驗收:補能重現問題的測試,執行相關測試,說明修改與剩餘風險。兩個模板共用的要點是目標、材料、限制與驗收方式。Codex任務還要盡量指出專案路徑、重現步驟或相關檔案;否則它仍得先花時間找脈絡。
實務上,我會讓ChatGPT協助把問題說清楚,讓Codex在獲授權的專案內處理有邊界的修改,最後自己審查diff與測試輸出。若只有問答或材料整理,第一步就可能已經足夠;若交付物是程式碼變更,少了最後的檢查就還不能算完成。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

