
模型刚接进项目,下一版就发布了。GPT-6 Sol在2026年9月22日推出,GPT-6.1 Sol在9月29日跟上。对开发者来说,问题不是改一个model字段要多久,而是原来的提示词、测试和超时处理要不要重新验。
9月30日,我通过Crazyrouter的https://api.crazyrouter.com/v1/chat/completions给两款模型送了相同的英文任务,保存了代码、文本结果与请求记录。11月3日,我又把保存的生成代码拿到本地重跑检查;当天没有重新请求模型。下面的判断来自这组有限任务,适合拿来设计自己的对照试验,不能直接当成现网稳定性结论。
GPT-6.1 Sol与GPT-6 Sol写业务函数:先锁住处理顺序
我选了一个账单函数,因为它容易写出“能运行但算错钱”的代码。规则要求先按事件ID保留最早记录,再筛时间窗口,接着排除测试账号,最后汇总扣款与退款。若先筛时间,区间外的首条记录会被删掉,区间内同ID的后续记录就可能被误当作首次事件。
更直观的边界例子是:ID为a的首条记录时间为-1,第二条在5,金额90,统计区间为[0,10)。先去重会保留-1那条,之后两条都不会计入窗口;先筛时间则可能把90错算进去。
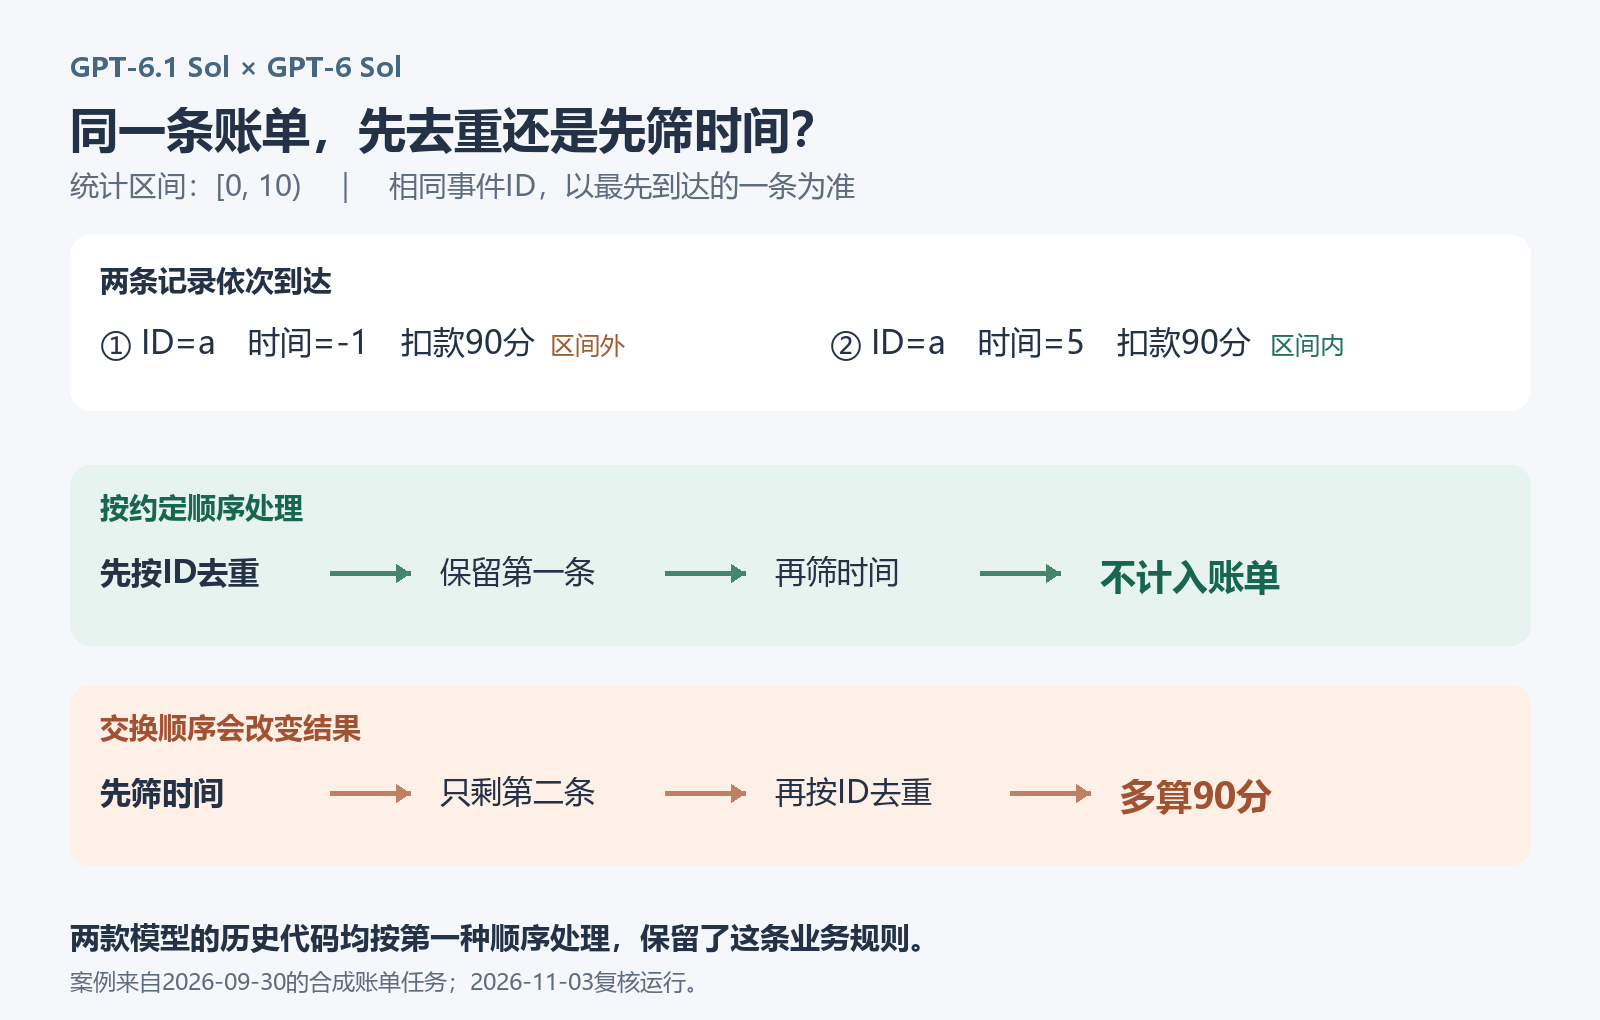
两款模型在保存的回答里都写对了这个顺序。每款模型的两份账单函数,我分别用122项本地检查重跑,四份都通过。另一个区间处理函数也通过了对应检查。这能说明在规则明确、范围较小的函数任务里,旧版并没有因为新版发布就失去使用价值;它不能证明两者在陌生代码库、多文件修改上同样可靠。
把这条经验用到自己的项目时,我会先把“顺序不能互换”写进任务说明,再留一个跨越时间窗口的重复ID用例。之后无论切到哪款模型,测试都能拦住这种静默回归。若你现有的GPT-6 Sol流程已经稳定通过这些用例,暂时没有必要为了版本号重构。
GPT-6.1 Sol与GPT-6 Sol读规则:让程序核算最后的数
第二类任务是从长材料中得到精确数字。我准备了一份合成的360条规则文本,让两款模型找出符合条件的数量,并判断一条指定的优先规则是否存在。独立核算的数量为72,指定规则实际不存在。
9月30日保存的两轮结果中,GPT-6 Sol两次都给出72;GPT-6.1 Sol一次给出72,另一次给出71。两款模型都正确指出指定规则不存在。一次少算不代表新版整体更差,却足以提醒我:解释条款和给出最终计数,应该是两个可分别检查的步骤。
在真实报表或规则库里,我更愿意让模型列出命中的规则ID和简短依据,再由脚本按ID去重、计数。出现72和71的分歧时,回看具体记录就能定位问题;直接拿模型给的总数入库,则连错在哪一条都不知道。金额、日期和资格判断也应采用类似方式:保留原始依据,让确定性程序完成最后计算。
GPT-6.1 Sol与GPT-6 Sol接入任务:超时和答错要分开看
模型返回得快不快,取决于你让它做什么。9月30日的事件提取任务里,GPT-6.1 Sol两次完整回答约耗时19.25秒、12.62秒,GPT-6 Sol约22.83秒、20.62秒;换到其他代码任务,快慢没有保持同一个方向。
整组记录是每款模型8个独立任务、每题两轮,使用reasoning_effort: "high"和8192 token输出上限,原始请求存在并发。GPT-6 Sol完成16/16次,GPT-6.1 Sol完成14/16次;新版有两次规则检索请求达到客户端约240秒超时。这里的16次是请求数,不是16个不同问题,更不能写成生产环境可用率。
如果是在后台生成草稿,超时后排队重试可能可接受;如果用户正等着页面返回,240秒已经远超多数交互流程的容忍范围。落地时要分别记录“没拿到回答”“拿到但内容错误”,设置合理截止时间,并确认重试不会重复执行写入动作。模型本身的表现、客户端超时设置和调用链路都可能影响这组观察,不能仅凭它判断超时的根因。
在Crazyrouter比较GPT-6.1 Sol与GPT-6 Sol,先做小范围切换
我用的是OpenAI兼容聊天接口。已有客户端可从Crazyrouter接入说明核对配置:Base URL为https://api.crazyrouter.com/v1,本次请求的完整地址为https://api.crazyrouter.com/v1/chat/completions。请求里的精确模型ID分别是gpt-6-sol和gpt-6.1-sol,新版ID中的小数点不要写成网页路径里的连字符。
先确认账号里可见两个ID,再用同一份真实任务各跑一遍。提示词、输入、推理档、输出上限和检查方法尽量固定,保存实际输出与超时记录。模型列表可见不代表推理调用已经成功;网关能让连接方式一致,也不能替你证明自动回退、重试或切流已经配置完成。
我会保留已经能通过回归测试的GPT-6 Sol短函数流程,把GPT-6.1 Sol先放到反复需要人工修补的复杂任务里比较。哪一段真能减少返工,再迁移哪一段。对于精确计数和影响用户体验的等待时间,无论选哪款模型,都要由自己的程序和监测把关。

1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式
