
對會把模型接進工作流程的開發者來說,這次更新最直接的兩個變化是:官方指定基準的成績提高,API標準費率下降。但這並不等於把原本的GPT-6 Astra換成GPT-6.2 Astra,所有任務都會更準。公開的資料分析測試恰好出現新版較便宜、答對題數卻較少的案例。
以下以截至2026年11月18日可查的官方文件、第三方測試及X上的早期回饋整理。各來源的測試條件不同,數字不跨來源相加。
先定義比較邊界:兩代 Astra 的規格與費率
接入前先看沒有改變的部分。兩代模型的上下文視窗同為1,050,000 Token,最大輸出同為128,000 Token;都接受文字、圖片輸入,輸出文字,也都支援Fast模式。這次不能寫成「上下文變長」、「首次支援看圖」或「首次推出Fast」。新版模型文件列有Ultrafast,但現有對照不足以證明它是6.2首發。
真正有明確差異的是API標準單價。單位為每百萬Token:
| 計費項目 | GPT-6 Astra | GPT-6.2 Astra | 差額 |
|---|---|---|---|
| 輸入Token | $10 | $8 | 降20% |
| 快取輸入Token | $1 | $0.40 | 降60% |
| 輸出Token | $50 | $40 | 降20% |
如果流程會反覆帶入大段上下文,快取命中率和輸出長度都會影響實際帳單。超過272,000輸入Token的請求,以及Fast、Ultrafast等處理檔位,另有計費規則;上表不能直接換算成每項工作的節省比例。其他模型更新與使用情境可延伸閱讀Crazyrouter中文部落格。
一個反例:資料分析題目裡,新版更省卻少對兩題
Plotly的資料分析基準做了43題單次測試。GPT-6.2 Astra答對41題,GPT-6 Astra答對43題;差距出現在尋找隱藏資訊的「hidden needles」題型。整輪成本則是新版$4.11、初代$19.97。
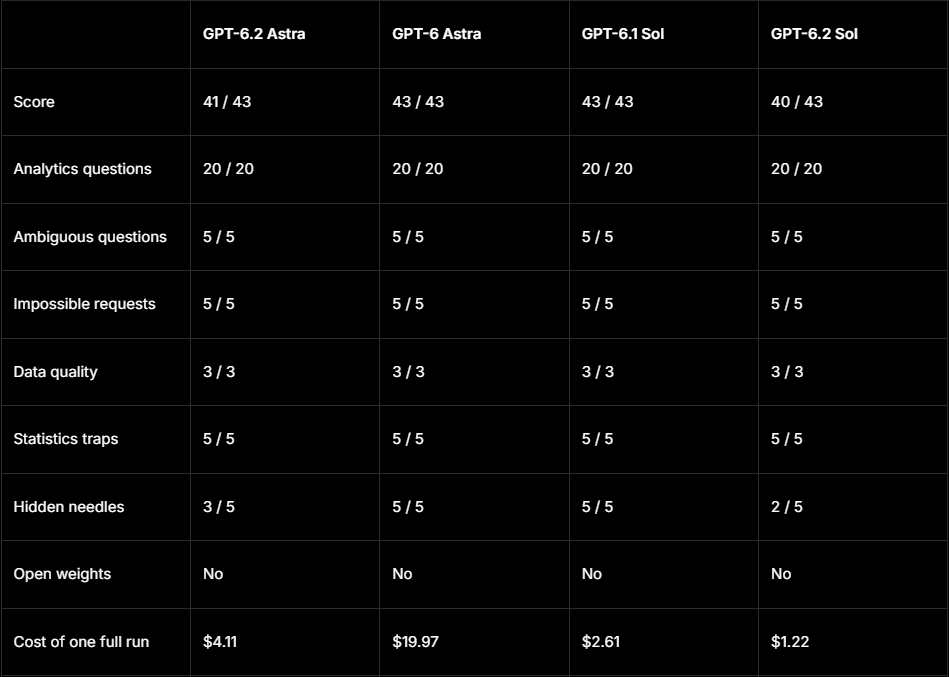
這個結果適合拿來提醒自己區分單次成本和答案正確性:在這一輪裡,新版省錢,卻沒有贏得正確題數。它不能證明所有資料分析任務都應選初代,也不能被其他排行榜的高分抹掉。若工作常要從大量資料找出少量關鍵事實,這類錯題比抽象的「整體更強」更值得追問。
科研題目的另一面:把準確率、時間與成本一起看
Vals Science Index提供另一組第三方對照。GPT-6.2 Astra的準確率為68.44% ± 2.13,初代為65.09% ± 2.26;每題成本是$4.76對$8.03,用時是22分15秒對40分37秒。
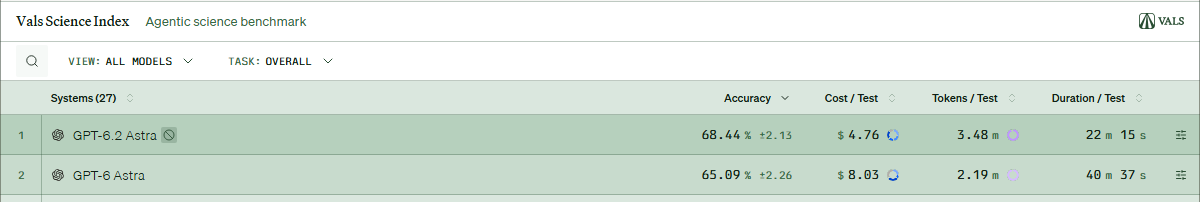
在這套科學題目的條件下,新版準確率的點估計較高,費用與耗時也較低。不過兩個準確率都有誤差範圍,不能把3.35個百分點的點估計差距直接宣稱為所有科研任務的穩定優勢。Vals與Plotly的任務也不同,沒有合理方式把兩份數字算成一個「綜合提升率」。
官方增量落在哪裡?看工作類型,不只看排行榜
OpenAI公布的對照集中在三種工作。GDPval v2裡,GPT-6.2 Astra比初代高6.2個百分點,同時輸出Token少22%;Agents’ Last Exam高5.2分;Terminal-Bench-Science 0.1高9分。
| 公開基準 | 對應工作 | 解讀時的界線 |
|---|---|---|
| GDPval v2 | 諮詢、金融、設計等長期專案交付 | 輸出Token少22%只屬於該評測,不能當成每份文件的固定節省 |
| Agents’ Last Exam | 規定條件下的多步驟Agent任務 | 高5.2分不等於長流程必定跑完 |
| Terminal-Bench-Science 0.1 | 科學終端任務 | 高9分不代表所有科研問題都更準 |
這組成績對需要格式、步驟和工具協作的工作很有參考價值,但它測的是設定好的任務與評分標準。實際專案還有需求是否被保留、遇到例外是否繼續,以及產物是否符合驗收條件。初代本來就能處理文檔、程式與工具任務;6.2是在這條能力線上迭代。
X 上的早期回饋,指向流程裡的哪個風險?
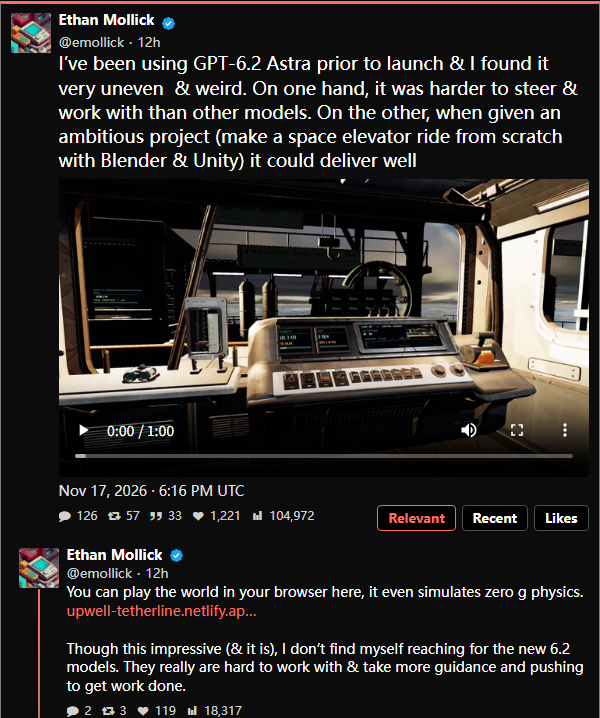
Ethan Mollick描述的使用感受有兩面:新版有時較難引導,卻也能完成用Blender與Unity製作太空電梯體驗的複雜專案。他後續仍提到,要讓模型繼續把工作做完,需要更多指引。
Dan Shipper與團隊則提到,文字有時過短、端到端程式任務可能過早停下;預設設計有亮點,但樣式變化不足。
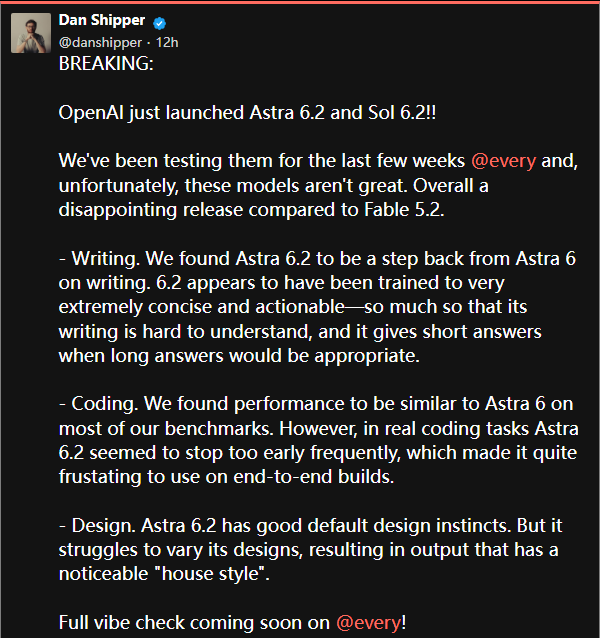
這些是個別使用者的早期觀察,不是故障率統計,也不否定官方基準。對長流程而言,它們提出了更具體的檢查點:模型會不會過早結束、簡潔輸出是否漏掉必要說明,以及最後成果能不能獨立驗收。
總結:GPT-6.2 Astra 什麼情況下值得優先比較?
如果工作重點是專業交付、科學分步任務,或對API標準費率敏感,GPT-6.2 Astra有清楚的公開數據值得納入比較。若工作依賴從長資料裡找隱蔽資訊,Plotly的反例要保留在評估裡;若目標是讓Agent少干預地跑完長工程流程,就要同時檢查中途停止、漏項與產物驗收。
這次更新的可靠結論是指定基準的成績提高、標準費率下降,並非每一類任務都已證明優於初代。規格相近時,版本選擇更應回到自己的任務類型、正確性要求與成本口徑。
資料
- OpenAI,《Introducing GPT-6.2 Astra and Sol》,2026年11月17日。
- OpenAI API,《GPT-6 Astra Model》《GPT-6.2 Astra Model》,2026年11月18日查閱。
- Vals AI,《Vals Science Index》,2026年11月18日查閱。
- Plotly,《GPT-6.2 Astra: Plotly Data Analytics Bench》,2026年11月18日查閱。
- Ethan Mollick、Dan Shipper,X原帖,2026年11月17日。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

