
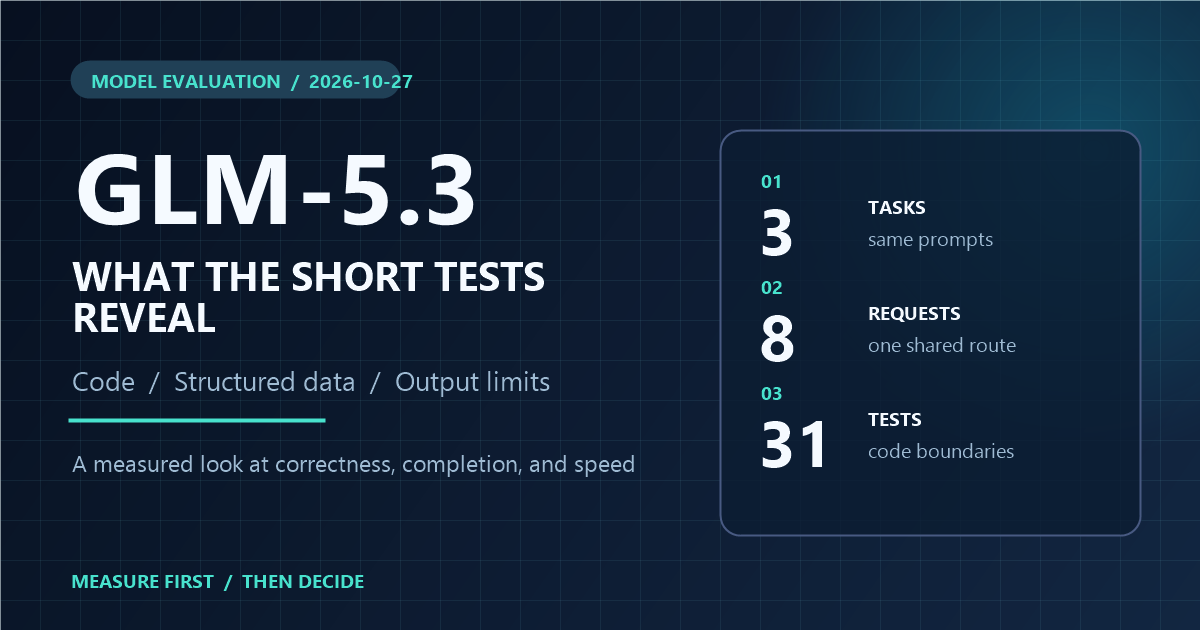
GLM-5.3是否適合接進資料整理或小腳本流程,先看兩件事:輸出是否符合規則,以及請求結束時是否真的拿到完整結果。這次與豆包的短測試,剛好分別碰到了這兩個問題。
資料提取題兩邊都答對,GLM-5.3這次較快;程式碼題則不能只看通過幾組測試,因為GLM首輪正文為空,提高輸出上限後才取得完整程式碼。選型時,這些條件需要和結果一起看。
先看實測:答案正確,還要確認輸出完整
針對資料整理與小腳本需求,GLM-5.3和豆包 Seed 2.1 Turbo 接受了相同的三道短題,以結果能否直接使用作為檢查重點:
| 日常任務 | GLM-5.3 實際表現 | 豆包實際表現 |
|---|---|---|
| 把維護資訊改成客戶通知 | 要點完整,有標題和分段;26.46秒返回 | 要點完整,表達更緊湊;28.11秒返回 |
| 提取訂單資料、計算收入 | 全部正確;11.53秒返回 | 全部正確;16.98秒返回 |
| 按業務規則生成小函式 | 補測獲得完整程式碼,31組測試全部通過 | 首輪和補測程式碼均通過31組測試 |
本次最直觀的差別,是 GLM 在資料提取題中做對了同樣的事,少等了約5秒。 它正確算出淨收入3300元、轉化率6.00%,也沒有編造材料未提供的退款原因。小函式則通過了31組實際執行測試,覆蓋無效金額、不同訂單狀態等邊界情況。
對讀者來說,選擇 GLM 的理由可以很具體:把自己常做的一項資料整理或腳本任務交給它,看能否在結果正確的前提下減少等待和手動操作。這次結果值得一試,但尚不足以證明它在所有任務上都比豆包強;只偶爾聊天、改幾句話,繼續用順手的工具也可以。
這是一次小樣本API測試,不代表網頁、App體驗或長期速度排名。
對照任務需求:文字、程式碼與多模態
適合的任務是長程程式開發、長文件與中文處理;基礎版不直接處理圖片。
可交給它處理的任務:
- 從零寫一個小程式 / 網頁 / 腳本(一句話描述需求,它出完整程式碼)
- 讀幾十頁 PDF、幾百頁程式碼庫,做總結、找 bug、寫改動方案
- 複雜工程排錯、程式碼重構、跨檔案修改
- 中文長文寫作、翻譯、研究資料梳理
選擇前需要確認的限制:
- 基礎版 GLM-5.3 是純文本模型,不能直接"看"圖片;要看圖得用同系列的 GLM-5.3-Flash(首個原生多模態版本)
- 知識截止約 2025 年底,最新時事要靠它聯網補
- 重度視覺設計(UI 審美)偏弱,生成介面"能用但不好看"
中文任務。 智譜是國產模型,中文語感、本地表達、國內場景適配都明顯優於很多海外模型。寫公文、改周報、讀中文研報、做本土業務分析,它比英文模型順手。
定位偏向工程任務、開源可控與成本優勢;多模態和互動功能相對較弱。
| 維度 | GLM-5.3 | ChatGPT / 豆包 類閉源 |
|---|---|---|
| 程式碼 / 長程任務 | 開源第一梯隊,比肩 Claude Opus 4.8 | 頂級,但貴 |
| 價格 | 幾十分之一 | 高 |
| 資料可控 | 可完全本地部署 | 依賴雲端 |
| 多模態 | 基礎版純文本,Flash 版才行 | 原生強 |
| 中文 / 本土 | 主場 | 還行 |
接入前確認:入口與計費權益各自對應
使用入口分為網頁、App、程式開發工具與API,可依操作方式選擇。
- Z.ai 網頁端:chat.z.ai(最推薦,免費額度、可調思考強度)
- 智譜清言:chatglm.cn + 手機 App(國內訪問穩)
- ZCode:zcode.z.ai(專為寫程式碼優化的工具)
- API(開發者):智譜 BigModel 開放平台 / Z.ai 直連,也可走 Crazyrouter 的 OpenAI 相容入口
https://api.crazyrouter.com/v1(模型頁:https://crazyrouter.com/zh/models/zhipu/glm-5.3) - 第三方程式開發平台:Trae、WorkBuddy、Qoder、OpenCode 等已陸續接入
輕度使用可先從免費額度開始;重度使用則適合比較訂閱方案與按量計費。
- 網頁/App 端(Z.ai、智譜清言)有免費體驗額度,日常對話、寫文案、讀文件基本不花錢;
- 走 API 按量付費:GLM-5.3 約 輸入 8 元 / 輸出 28 元(每百萬 token);
- 重度寫程式碼推薦 GLM Coding Plan 訂閱(Lite / Pro / Max 檔),比單次 API 劃算得多,還能接 Claude Code、Trae 等程式開發工具;
- 預算敏感可以選同系列的 GLM-5.3-Flash:原生多模態、智慧接近 Opus 4.8,價格只有它的約 1/40。
付費前先分清三種用途:網頁/App 會員主要面向聊天產品內的權益,Coding Plan 面向方案支援的程式開發工具,API 餘額用於程式呼叫。不要預設“買了一個,其他入口也能用”。下單前確認方案支援哪些模型、能在哪些工具裡使用、額度如何計算,以及會員、訂閱和 API 餘額是否互通,具體以購買頁面說明為準。第一次用,先確認能選到目標模型,再按自己的使用量決定是否付費。
部署與執行條件:資料位置、模式與查證
本機部署與雲端使用
資料控制的重點在部署方式。 MIT開源讓這個模型具備高度可控性,你可以把 GLM-5.3 部署在自己伺服器上,敏感資料、程式碼全程不出本地,不依賴任何第三方黑箱。
注意邊界:用網頁/App/雲端 API 時,內容還是走智譜的雲;企業版預設不拿你的程式碼和對話去訓練。另外 5.3 強化了"白盒漏洞審計"能力——能幫安全團隊找程式碼裡的隱患,這是它區別於普通模型的一大賣點(敏感安全能力需受信訪問)。
模式與回應速度
品質高、速度偏慢,是這類開源模型常見的取捨;選擇模式時需一併考慮等待時間。
- 標準/高速模式約 70 token/s,日常夠用;
- 深度思考(Max)模式約 17–19 token/s,慢但更準;
- 高峰期 API 可能限流,長任務建議錯峰。
長上下文與知識截止
即使幻覺表現優於不少海外模型,重要結論仍需查證。
第三方幻覺測試裡,同代 GLM 系列幻覺率明顯低於 GPT-5.5 一檔(有評測顯示差距達數倍)。實際使用仍要留意兩個問題:
- 長上下文偶發"漂移":餵得越長,越可能前面說的後面忘,超長任務建議分段餵料;
- 知識有截止:它不知道訓練之後的事,重要事實讓它"聯網核實"或你自己查證。
可複製 prompt:「下面這段結論,請只依據我給的資料回答,不要編造外部資訊;如果資料裡沒有,直接說'資料未提及'。」
先做最小操作,再換成實際需求
使用網頁或App不需要程式設計基礎,直接在聊天框輸入需求即可。程式設計是它的強項:不會寫程式碼時可以請它協助產生,已有基礎則可用它加快撰寫。
先從網頁聊天開始,不必一上來就研究 API。
- 打開入口。進入 Z.ai,如頁面提示切換中國站點,按提示進入;需要登入時,完成頁面上的登入流程。
- 確認模型。查看輸入框附近的模型名稱和可選列表,若帳號可選 GLM-5.3,再切換到它。注意 GLM-5.3-Flash 是另一個型號,不要把預設模型當作GLM-5.3。如果列表中沒有 GLM-5.3,先查看當前帳號的開放範圍與方案說明,不要為了找模型直接儲值。
- 複製下面的提示詞,發出第一條訊息。先用短文本體驗,容易檢查結果,也不用準備檔案。
- 核對結果,再換成自己的任務。檢查日期、時段、功能和建議是否保留,有沒有多寫未經承諾的內容。如果答案太長,繼續說:“壓縮到80字以內,保留所有關鍵資訊。”
請把以下資訊寫成一則可直接發給客戶的通知,正文不超過120個漢字,不添加未提供的承諾:11月3日02:00至04:00系統維護,期間無法匯出報表,查詢和支付正常,建議提前匯出所需報表。只輸出通知。
跑通這一條後,再把材料替換成自己的通知、周報或產品介紹。本次訪問網頁時,預設顯示的是 GLM-5.3-Flash;你實際能選到哪些模型,以當前頁面和帳號權限為準。
手機入口。 應用商店搜"智譜清言",升級到最新版即可用 GLM-5.3,上下班路上就能聊。
可延伸的三個練習
- 讀長文:把一份冗長 PDF / 網頁扔進去——「讀一遍這份材料,用 5 句話講清核心結論,再列 3 個我該跟進的點。」
- 寫個小工具:「用 Python 寫一個命令列待辦清單,支援增刪改查,存到 txt 檔案,給我完整可執行程式碼。」
- 改文案:「把這段中文產品介紹,翻譯成地道專業的英文郵件,語氣禮貌但堅定。」
三個都跑通,你就已經超過 80% 的"只會問你好"使用者了。
版本沿革:基座、後訓練與開源定位
智譜(Zhipu AI) 是一家清華系出身的中國 AI 公司,也是港股"全球大模型第一股"(股票代碼 02513.HK)。它從一開始走的就是開源路線——模型權重用最寬鬆的 MIT 協議放出,誰都能免費下載、自己部署、甚至拿去商用。
GLM 是智譜的大模型系列,差不多兩個月迭代一版,節奏很快:
- GLM-5.1(2026-04):第一次能連續工作 8 小時,對齊當時的 Claude Opus 4.6;
- GLM-5.2(2026-06):把上下文拉到 100 萬 token(約等於一次讀完整本長篇小說或整個中型程式碼庫),程式碼和長程任務衝到開源第一;
- GLM-5.3(2026-08-14,當前最新旗艦):複用 5.2 的基座,不堆參數,全靠"後訓練"把智慧往上推。官方口號是 Built to Code. Ready for Cyber Defense.(為寫程式碼而生,為網路安全而備)。
評估這個系列時,可以從版本、費用與部署方式看起:
- 版本定位——是現在能正常用到的國產開源模型天花板;
- 價格定位——同等能力下,價格只有海外閉源旗艦的幾十分之一;
- 本機部署——能完全跑在你自己電腦/伺服器上,資料不出門。
它不是"又一個聊天玩具",而是國內第一個在程式工程 + 網路安全上摸到海外閉源一線水平的開源模型。
選型補充:版本差異與使用限制
Q1:GLM-5.3 和 5.2 什麼關係?
A:5.3 是 5.2 的升級版,複用同一套基座,主要靠後訓練把程式碼和安全能力往上推,程式設計體感提升約 50%。5.2 仍可用,但 5.3 是當前最新。
Q2:我電腦能自己跑嗎?
A:能,但門檻不低——完整版需大顯示記憶體伺服器。普通人體驗直接用 Z.ai / 智譜清言 網頁和 App 最省事。
Q3:它真的不用花錢?
A:網頁/App 有免費額度,輕度用不花錢;大量呼叫或寫程式碼走訂閱/API 才需要付費。
Q4:能幫我寫論文 / 做畢設嗎?
A:能輔助查資料、理結構、改語言,但別直接交——它會有錯漏,且涉及學術誠信,自己把關。
Q5:為什麼有時候答得慢?
A:開了深度思考模式、或正處高峰期限流。日常用預設檔,錯峰跑長任務。
Q6:和 Claude、GPT 比誰強?
A:程式碼/長程任務上 5.3 已接近 Claude Opus 4.8 同級,且便宜可控;多模態、交互精緻度仍落後閉源旗艦。按需求選,不必迷信某一個。
如果你也用GLM-5.3或豆包做過類似測試,歡迎附上模型版本、輸出上限與驗證方式。尤其想比較:換成自己的輸入後,是否仍能取得完整且符合規則的結果?
測試條件與限制
本次對比於北京時間2026年10月27日,透過同一個Crazyrouter API管道進行,型號為glm-5.3與doubao-seed-2-1-turbo-260628。雙方使用相同提示詞、獨立對話與預設推理設定,共八次請求,包含雙方各一次程式碼補測。耗時從送出請求計算至收到完整回應,涵蓋網路傳輸、排隊、推理與生成;不是首字延遲,也不代表長期速度排名或網頁、App體驗。
程式碼題首輪請求的輸出上限為1600 token。GLM觸及長度限制,未返回最終內容;雙方將上限提高至4096後補測,均返回完整程式碼並通過31組測試。因此,GLM通過測試的程式碼來自補測。使用API時,若請求成功卻沒有最終內容,應檢查結束原因與輸出額度。
管道回報的豆包程式碼輸出用量超過請求上限,GLM程式碼補測有部分輸入快取命中,且雙方預設推理策略未必相同,因此不能嚴格比較程式碼題的速度。實際帳單未經核對,不能據此判斷哪一方更便宜;測試也未涵蓋長文件、多模態與複雜工程能力。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

