
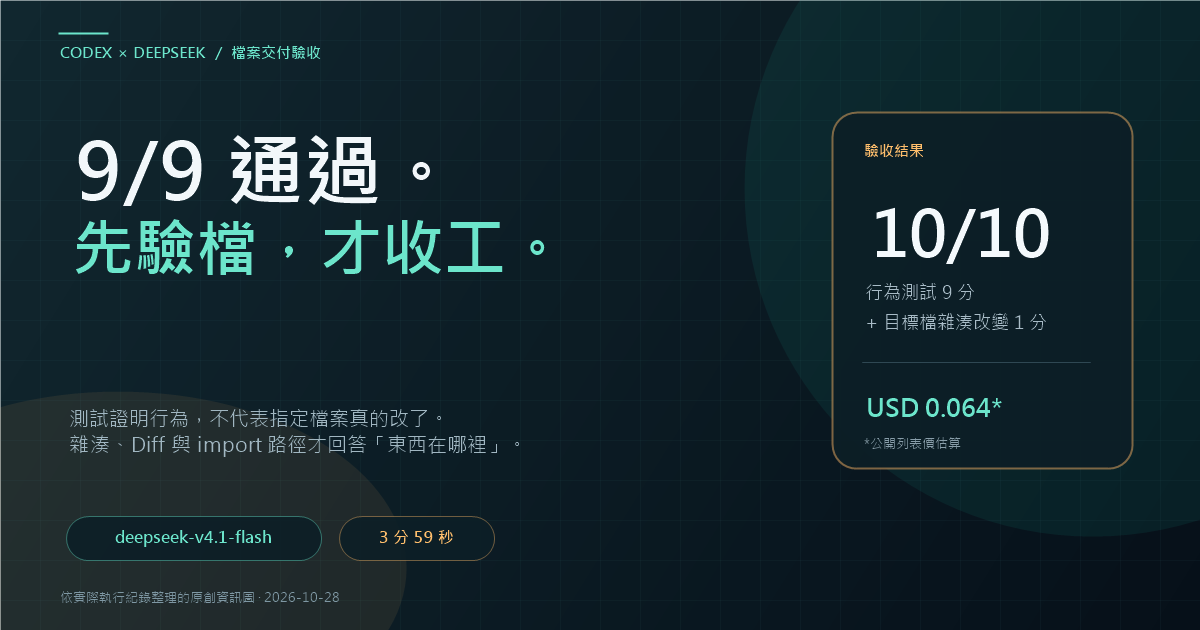
9/9 測試通過,指定檔案的雜湊也改變,才形成一次可交付的修復。
DeepSeek 接進 Codex 後,真正需要驗收的不是「模型有沒有回答完」,而是最後留下什麼。這次執行花了 3 分 59 秒,9 個行為測試全部通過,inventory_service.py 的內容也確實改變;把行為測試的 9 分與目標檔案的 1 分合計,結果是 10/10。
同一個模型換到 DSH 執行時,測試同樣顯示 9/9,指定檔案卻沒有變。差異不在測試數,而在 DSH 建立了一個同名的 Python 套件,測試載入的是新套件,不是原本要求的檔案;行為測試仍是 9 分,目標檔案沒有取得那 1 分,總分是 9/10。這個反例讓驗收問題變得非常具體:測試看見的究竟是哪一份程式?
綠燈只回答了一半
行為測試能回答「某份實作有沒有做到原子扣庫、重複 SKU 合併、非法數量拒絕與快照隔離」。它不能單獨回答「改的是不是指定檔案」,也不能保證執行測試的 Python 程式載入了哪個模組。
當工作目錄同時存在 inventory_service.py 與 inventory_service/,import inventory_service 的結果可能隨搜尋路徑改變。終端機只印出 9 passed,看不到這層差別;測試真的通過了,交付卻可能仍然錯誤。
因此,通關條件要拆成兩個獨立問題:
- 行為是否符合測試?
- 產出的內容是否落在指定檔案,而且測試是否從該檔案載入?
只要其中一個沒有答案,就不能把「測試通過」直接改寫成「工作完成」。
Codex 的價值在把結果帶回工作區
Codex 不是單純把模型產生的程式碼貼到聊天視窗。它能讀取儲存庫、修改檔案、執行命令,再把終端機輸出帶回下一輪。當測試失敗時,traceback 會成為下一次修改的輸入;修改後也能立刻重跑同一組測試。
這個回饋路徑比「提出一個看起來合理的補丁」更接近實際工程。開發者不必反覆複製錯誤訊息,卻仍然要保留最後的人工驗收。工具能縮短嘗試時間,不能替人決定何謂合格交付。
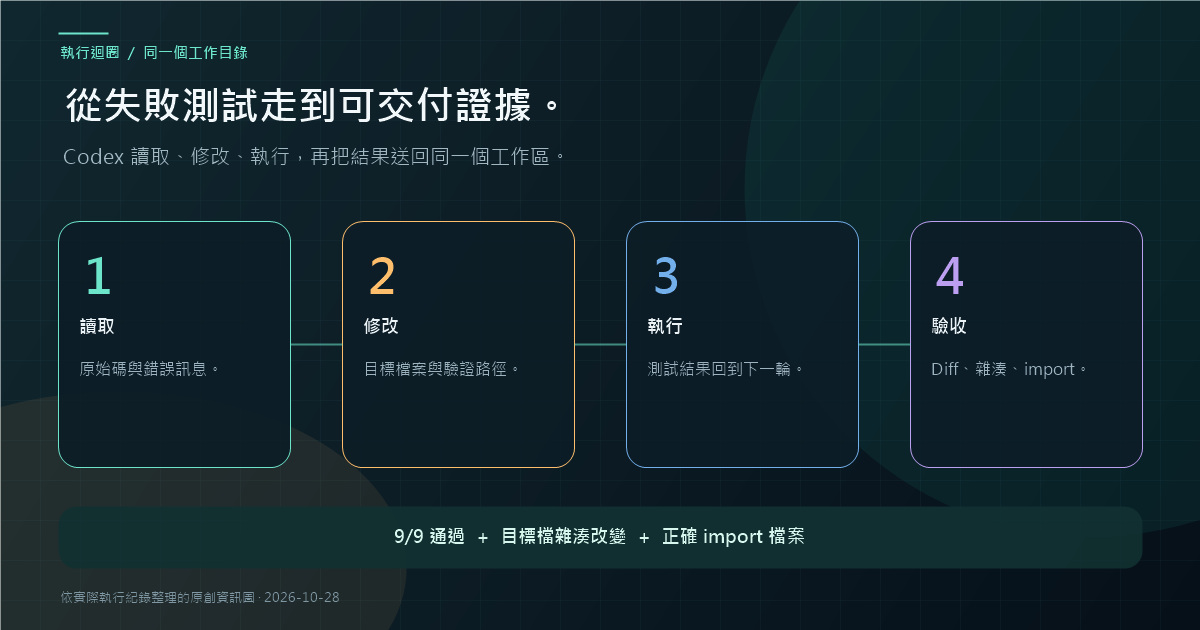
測試結果回到同一個工作目錄,才可能形成下一輪修正。
連線設定只解決第一層
這次使用的設定如下,金鑰透過環境變數提供:
model = "deepseek-v4.1-flash"
model_provider = "crazyrouter"

[model_providers.crazyrouter]
name = "Crazyrouter"
base_url = "https://api.crazyrouter.com/v1"
env_key = "CRAZYROUTER_API_KEY"
wire_api = "responses"
requires_openai_auth = false
設定正確,只代表請求有機會送到正確的模型路由。後續仍要分別確認三件事:環境變數是否被 Codex 讀到、模型 ID 是否能取得回應、Codex 是否真的能在指定工作目錄執行工具。
這三層混在一起排查,很容易把權限或路徑問題誤判成模型品質。先用一個小讀取命令確認工作區可存取,再跑一次短測試確認工具輸出能回來,最後才啟動完整修復,定位成本會低很多。
用四個訊號確認交付
工作結束後,先看測試程式的終止碼,再看 git diff --name-only 是否只包含允許的檔案。第三步檢查目標檔案的 SHA-256,確認內容不是只被格式化或重新寫入。最後一步直接問 Python:目前載入的模組位於哪裡?
$target = (Resolve-Path .\inventory_service.py).Path
$target
(Get-FileHash $target -Algorithm SHA256).Hash
python -c "import inventory_service; print(inventory_service.__file__)"
git diff --name-only
這些命令不是新的模型能力,而是把「完成」拆成可重複的證據。目標檔案的雜湊要從種子版本 5F8FA06F3A9B9ED7022CE2EEC9158D0139DEC6716872FAC8F9D0E86DDC7C88F8 變成 008AF21A36C45CDBB9513961DBF52E2E663791EF5CA5A31FB018871F1F4EF66D;import 印出的路徑也要落在同一個工作目錄。
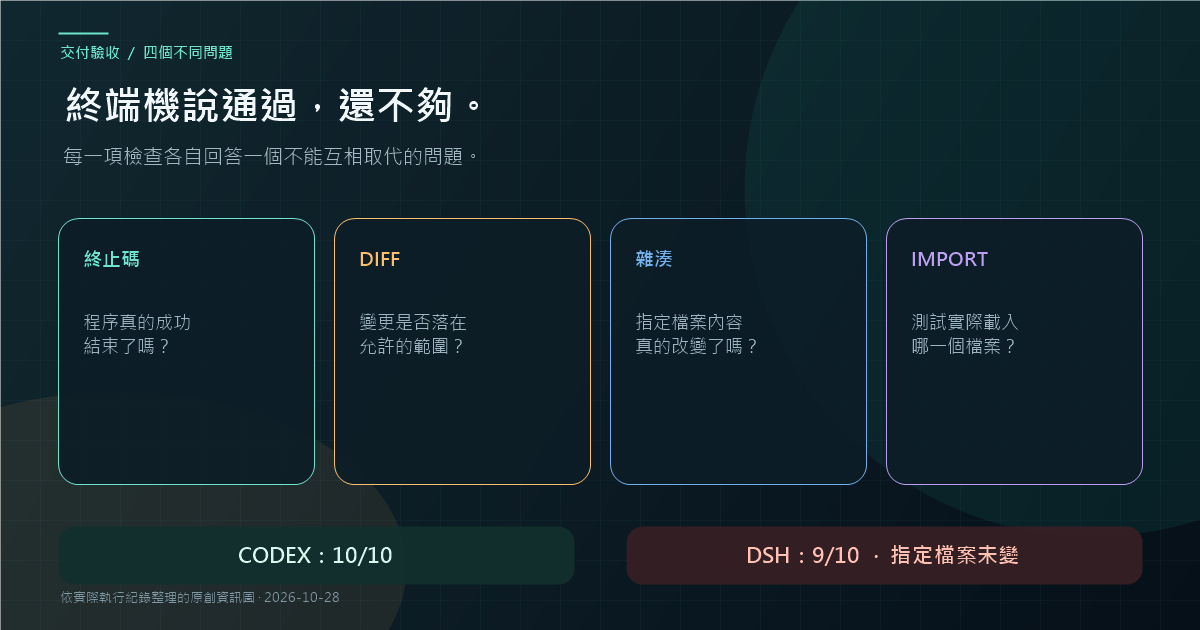
四個訊號同時指向同一個目標檔案,才足以支持交付判斷。
六分錢買到的是多次觀察機會
這次共使用 773,893 個輸入 token,其中 738,432 個來自快取、35,461 個未快取;輸出為 24,869 個 token,包含 8,033 個 reasoning token。依 2026 年 10 月 27 日的公開列表價估算,模型費用約為 0.064 美元。
| 項目 | 數量 | 公開列表價 | 估算 |
|---|---|---|---|
| 未快取輸入 | 35,461 | 每百萬 0.45 美元 | 0.01596 美元 |
| 快取輸入 | 738,432 | 每百萬 0.02 美元 | 0.01477 美元 |
| 輸出 | 24,869 | 每百萬 1.34 美元 | 0.03332 美元 |
| 合計 | 約 0.064 美元 |
相同的 token 組成若套用 GPT-6.1 Sol 的公開列表價,輸入每百萬 2 美元、輸出每百萬 10 美元,估算約為 1.797 美元。這兩個數字都是列表價推算,不是實際帳單;快取命中、重試、路由與任務內容都可能改變最後費用。
低成本真正換來的是可接受的再試次數。當一次失敗只要幾分錢,多讀一個錯誤訊息、多跑一輪測試就不再那麼沉重。但省下的是模型費,不是驗收責任。測試綠燈與錯誤檔案同時存在時,低價只會讓錯誤更快被重複。
什麼工作適合這樣交付
有明確失敗測試、可指定目標檔案、能在本機重跑驗證的小型修復,最適合交給這個組合。Lint、型別錯誤、局部重構與可重現的測試失敗,也能用同一套訊號收尾。
資料遷移、付款、身分驗證、權限與正式環境設定,即使測試全部通過,仍需要人工檢查變更範圍與未覆蓋條件。DeepSeek 在 Codex 裡值得保留的原因,不是它能代替驗收,而是它把「讀取、修改、執行、再看結果」變成一條成本可負擔的工作流。
交付前最後一眼仍應落在檔案上。雜湊、Diff 與 import 路徑都指向同一個目標,才把「9/9 通過」變成「這次真的改對了」。
Codex 的目前連線方式可在 Crazyrouter 核對。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

