TL;DR
我最近又完成了 Udacity 的 Future AWS Agent Engineer Nanodegree Program 其中一個專案,而我是透過 AWS AI & ML Scholarship 才有機會參加這個課程。
這是我第二個與 AI agent 系統合作的專案,但卻是我第一次使用 Amazon Bedrock AgentCore 和 Strands SDK 來打造一個系統。目標是建立一個客服 AI agent,能夠追蹤訂單、處理退款、透過 Knowledge Base 回答產品與政策問題、跨會話記住顧客資訊、使用程式計算忠誠度折扣,並瀏覽即時網站。
字面上看起來,那大概就是六個功能。
但實際上,這代表要把 AgentCore Runtime、AgentCore Gateway、Lambda、API Gateway、Knowledge Base、Memory、Code Interpreter、Browser Tool、IAM、部署,以及 CloudWatch 全部串成一個可運作的系統。
<p align="center">
<img src="https://media.giphy.com/media/l0NwHXQy3kUSfFF60/giphy.gif" alt="Mind blown reaction" width="400">
</p>
我第一次看到這些內容時,真的覺得好多。我知道自己應該要做什麼,但我還不理解這些零件到底該怎麼拼起來。這次,我有足夠的時間好好完成這個專案,而不是匆匆帶過。也因此,我有機會注意到一件我原本可能不會注意到的事:我把整個專案弄得更困難了,因為我試圖一次理解全部。
一旦我不再那樣做,開始改問自己:「下一個我需要理解的是什麼?」,整個專案就變得容易很多。
這不是一步一步的教學。AWS 和 AgentCore 已經有很多很棒的指南了。這篇文章是我建置這個專案的經驗、我在哪些地方感到困惑、一路上出了什麼問題、整體架構最後是怎麼開始變得有意義,以及我在把所有零件組起來後學到了什麼。
而在這一路上,「agent」 這個詞不再只是另一個 AI 流行語。我真的能在一個可運作的系統裡看見它的意義了。
目錄
- 我知道自己要做什麼,只是不知道它會讓人感覺有多龐大
- 那麼,這個 agent 實際上應該做什麼?
- 當我不再用 AWS 名稱來思考時,架構終於有意義了
- 我畫出架構圖,因為我需要把它看見
- 這六項能力其實是六個不同的問題
- 有正確的程式,不代表就能存取它
- 部署不是終點
- 六個測試比一個巨大的「它有沒有用?」更容易
- 只有在全部都運作後才變清楚的部分
- 還有另一層我沒有想得夠多:操作這個系統
- 我也必須學會什麼時候專案才算真的完成
- 這個專案真正教會了我什麼
- 一點小小的感謝
- 我很想聽聽你的想法
- 🤝 讓我們保持聯繫
我知道自己要做什麼,只是不知道它會讓人感覺有多龐大
我想先從這裡說起,因為完成後的專案,看起來遠比實際建置過程簡單。等到全部都正常運作之後,我可以回頭看整體架構,理解每一部分在做什麼。
但在一開始,我看到的是一長串陌生的名稱:Amazon Bedrock AgentCore、Strands SDK、Lambda、API Gateway、AgentCore Gateway、Knowledge Base、Memory、Code Interpreter、Browser Tool、IAM,以及 CloudWatch。 接著還有部署、測試和權限。
單獨看,每一項都不算不可能。放在一起,就讓人覺得很多。
<p align="center">
<img src="https://media.giphy.com/media/8eRwk8BFWMnauLdPFF/giphy.gif" alt="Confused reaction" width="400">
</p>
我想,這大概是學習雲端和 AI 系統最困難的地方之一。你可以各自理解每一個名詞,卻仍然完全不知道它們應該怎麼連在一起。
一開始,我想先理解整個架構,再開始動手做。但這樣效果並不好。我越是想一次搞懂全部,就越覺得被壓垮。
所以我改變了我問自己的問題。
我不再問:
「我要怎麼理解整個專案?」
而是改問:
「我下一個需要理解的是什麼?」
這變成了一種更可行的做法。
而且最後,這些零件真的開始串起來了。
那麼,這個 agent 實際上應該做什麼?
這個專案是一個虛構的客服系統。顧客可以提出問題,而 AI agent 必須理解需求並使用適當的能力來回應。
這六項能力是:
- 訂單追蹤
- 退款處理
- 產品與政策問題
- 跨會話的顧客記憶
- 忠誠度折扣計算
- 即時網站瀏覽
也就是說,這不只是一個會產生回應的聊天機器人。這個 agent वास्तव上可以依照顧客需要,與系統中的其他部分互動。
簡化後的流程大致如下:
顧客
   ↓
AI agent
   ↓
顧客需要什麼?
   ↓
使用適當的能力
   ↓
取得結果
   ↓
AI agent
   ↓
最終回應
   ↓
顧客
一開始看起來很直接,但在這個流程底下,每項能力都需要不同的基礎架構,這就是專案開始變得有趣的地方。
當我不再用 AWS 名稱來思考時,架構終於有意義了
我思考方式最大的轉變,是我不再把這個專案看成一堆 AWS 服務的清單。相反地,我開始看的是每一個部分各自負責什麼工作。
AI 模型負責理解顧客的請求,並根據指令與可用工具決定要做什麼。在這個專案裡,我是透過 Amazon Bedrock 使用 Amazon Nova 2 Lite。
Strands SDK 則提供了我建構 agent 的框架,並把它的行為與所需的工具和能力連接起來。
接著是那些幫助 agent 真正完成事情的基礎設施。AgentCore Runtime 是已部署 agent 的執行環境,而 AgentCore Gateway 則負責 agent 與後端工具之間的連線。API Gateway 透過 API 暴露訂單相關的後端操作,而 AWS Lambda 則負責執行那些後端操作。
其他能力也各自有對應的零件。Knowledge Base 提供產品與政策資訊讓 agent 可以檢索;AgentCore Memory 讓有用的顧客資訊能跨會話被取用;Code Interpreter 負責用真正的程式執行計算;Browser Tool 讓 agent 能與即時網頁互動。最後,CloudWatch 幫助我監控已部署的執行環境。
當我不再只看名稱,而是看它們各自的工作內容時,整個架構就沒那麼可怕了。
我不是在試著背 AWS。我要回答的是:
「我的應用程式需要做什麼,而哪一個零件負責完成它?」
這個問題對我幫助大很多。
我畫出架構圖,因為我需要把它看見
我最後用 Excalidraw 畫了一張架構圖。我想讓它呈現的是一次請求的故事,而不只是把所有 AWS 服務都放在同一頁上。
概念很簡單:顧客提出問題,agent 判斷顧客需要什麼,使用適當的能力,然後結果回到 agent。接著 agent 會用這個結果回應顧客。底下支援這些能力的 AWS 服務,則位於需要它們的功能之下。
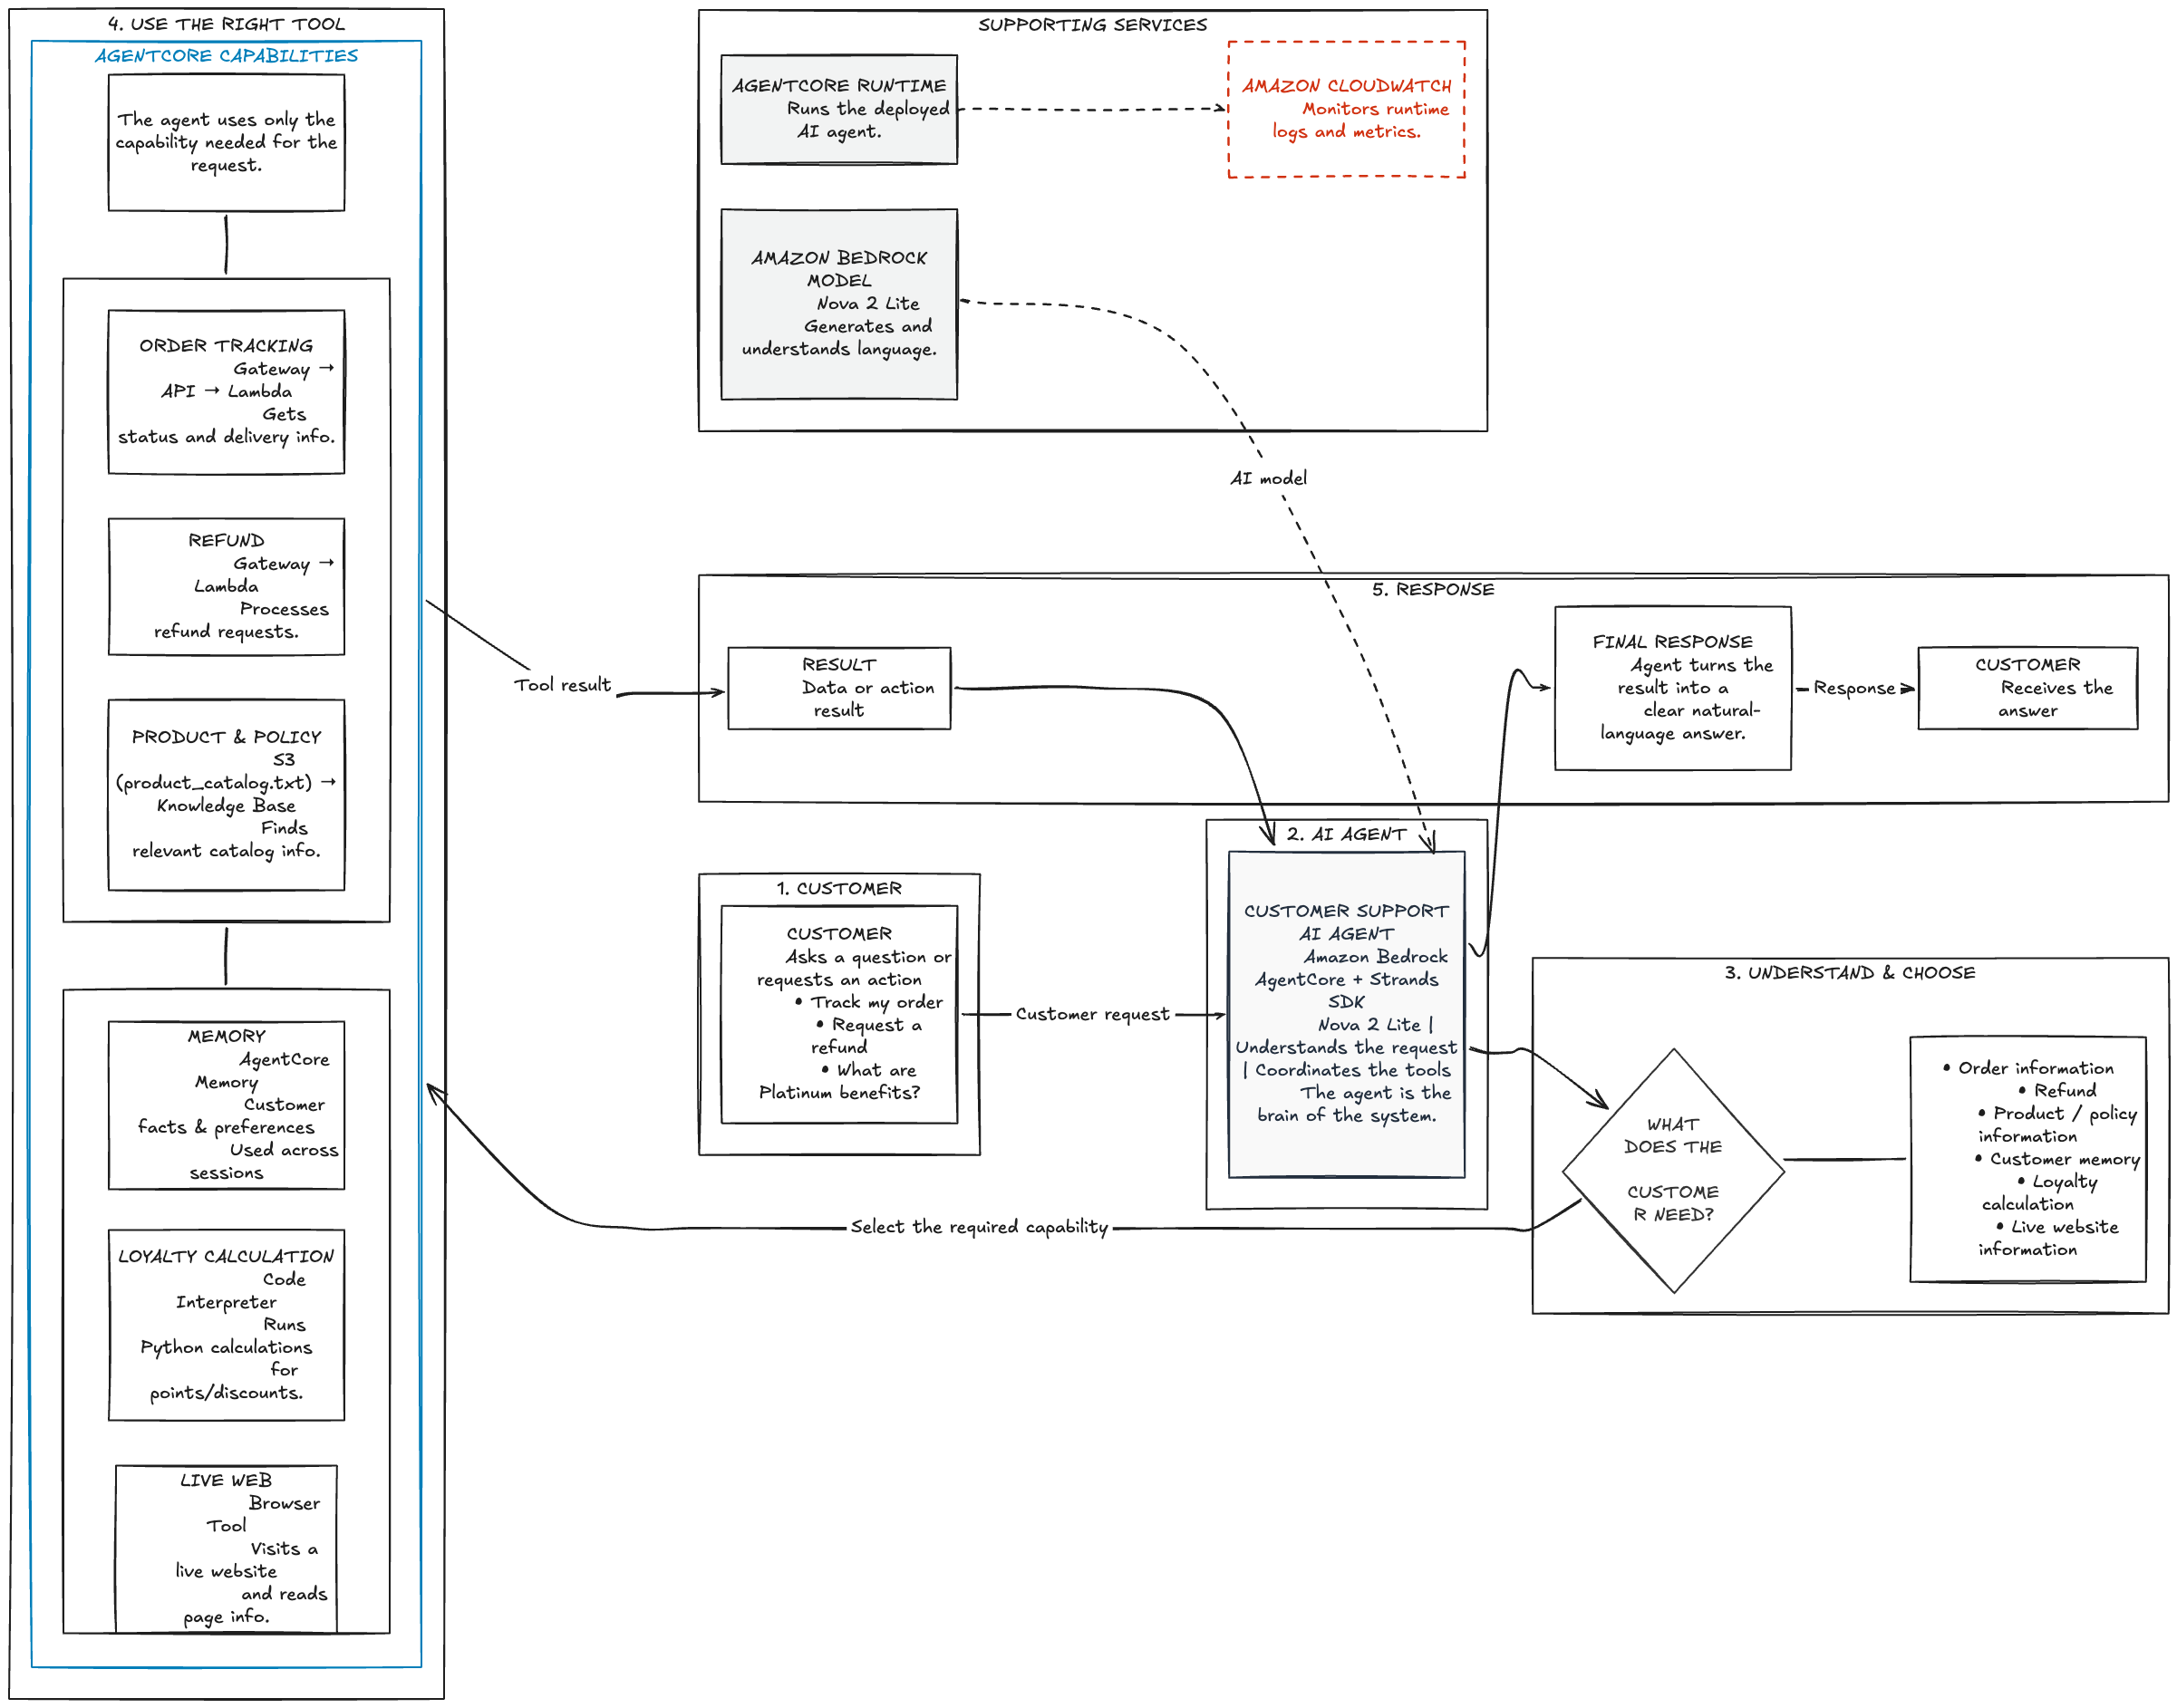
這就是我為這個專案畫的架構。用這種方式畫圖,幫助我把系統看成一條流程,而不是一堆服務的集合。
現在看這張完成的圖,我會覺得它很直觀。但我想那是因為我已經先把裡面的零件做出來了。這張圖之所以比較容易理解,是因為我先理解了每個方塊在解決什麼問題。
這六項能力其實是六個不同的問題
當整體架構弄懂之後,我就可以把每一項能力拆開來看。這讓專案一下子變得容易管理很多,因為我不再試圖同時理解六件不同的事。
1. 訂單追蹤:把真實資料帶回給顧客
如果顧客問:
「我的訂單到哪了?」
agent 需要的不只是一句生成出來的回答,它需要的是實際的訂單資訊。
我建立了一個訂單追蹤用的 Lambda,並透過 API Gateway 暴露所需的操作。接著由 AgentCore Gateway 負責把 agent 與那些後端操作連接起來。
所以流程大致是:
顧客
   ↓
Agent
   ↓
AgentCore Gateway
   ↓
API Gateway
   ↓
Lambda
   ↓
訂單資訊
   ↓
Agent
   ↓
顧客
這是我第一次真正更清楚地體會到,聊天機器人和 agent 工作流程的差別。模型不是在編造訂單狀態,而是在向系統的另一部分查詢資訊。
2. 退款:當 agent 需要執行一個動作時
退款處理很類似,但概念上稍微不同。agent 不只是取回資訊,它還需要觸發一個操作。
我透過 AgentCore Gateway 把退款功能連到一個 Lambda 函式。這讓一件很重要的事在我腦中變得清楚:模型說某件事發生了,和系統真的執行那個動作,是兩回事。
如果 agent 告訴顧客:
「您的退款已處理完成。」
那背後應該真的有一個實際的操作。這個操作需要成功,結果需要回傳,而 agent 應該根據那個結果來回應,而不是只是自己假設它成功了。
跟單純的問答聊天機器人相比,這是完全不同的 AI 應用思考方式。
3. Knowledge Base:模型知道,和應用程式知道,並不是同一件事
對於產品與政策問題,我使用了 Amazon Bedrock Knowledge Base。這也是我第一次對 RAG 有了更實際的理解。
假設顧客問:
「退貨政策是什麼?」
我不希望模型只是生成一段「聽起來像」退貨政策的內容。我想要它檢索出屬於這個應用程式的正確資訊。
基本流程會變成:
顧客問題
       ↓
檢索相關資訊
       ↓
把資訊交給 agent
       ↓
產生回應這讓我意識到一件很重要的事:模型可以知道很多事,但還是不一定知道我的應用程式的資訊。
Knowledge Base 讓 agent 有一個可檢索的資訊來源。這遠比只是希望模型剛好知道正確答案來得更有用。
4. 記憶:當新的對話其實不是從零開始
我也加入了 AgentCore Memory。目標是讓 agent 能跨會話記住有用的顧客資訊。
我用一個簡單的例子測試它。在一個 session 裡,我告訴 agent 某位顧客的名字和回覆偏好。接著我開啟另一個獨立的 session,請它從前一次對話中取回那些資訊。
它做到了。
這件事很有意思,因為第二個 session 並不是單純延續第一段對話。系統必須從儲存的顧客情境中把資料取回來。
這讓我理解到以下兩者的差別:
「模型可以看到前面的訊息。」
以及:
「應用程式有機制可以檢索相關的顧客情境。」
這也讓我開始思考記憶所伴隨的責任。在真實的客服應用中,你必須非常仔細地思考:儲存哪些資訊、保存多久、誰可以存取,以及如何保護顧客資訊。
讓記憶功能運作,只是問題的一部分。
5. Code Interpreter:讓模型決定,讓程式負責計算
忠誠度折扣是其中比較有趣的一部分,因為我在這裡真的犯了錯。
agent 需要根據顧客的忠誠等級、可用點數和訂單總額來計算折扣。我的第一版計算邏輯是錯的,因為我把忠誠點數和金額的概念混在一起了。
問題不是模型。是我的計算邏輯。
我修正了計算方式,並重新部署 agent。
這教會我一件在使用 AI 時很容易忘記的事:AI 應用程式裡仍然存在一般軟體工程問題。
你一樣可能會有錯誤的公式、錯誤的假設、邊界條件、設定問題和 bug。使用模型並不會讓這些問題消失。
這也幫助我理解為什麼 Code Interpreter 很有用。模型可以判斷「這裡需要做計算」,而程式可以真正執行計算。對精確算術而言,這種分工比要模型自己處理全部事情合理得多。
6. Browser Tool:當資訊不在你的應用程式裡
最後一項能力是即時網頁瀏覽。我使用了 AgentCore Browser Tool,並測試讓 agent 前往 Udacity 網站並回傳頁面標題。
這和 Knowledge Base 不同,因為資訊不是存在我的應用程式裡。agent 必須直接與即時網頁互動。
這讓我看到工具的另一面:工具不一定只是回傳資料的函式。 它也可以讓 agent 與模型當下上下文以外的東西互動。
有正確的程式,不代表就能存取它
這大概是這個專案最實用的一課之一。有些時候,架構看起來合理,程式碼也都在,但某件事就是不會動。原因往往是權限。
AgentCore runtime 需要正確的權限才能存取像是 Memory 和 Knowledge Base 這些資源。Browser Tool 在能啟動瀏覽器 session 之前,也需要適當的權限。
這改變了我除錯時的思考方式。在這個專案之前,我可能會立刻開始找程式問題。但在這個專案中,我開始問自己另一組問題:資源存在嗎?它在正確的區域嗎?runtime 有權限存取它嗎?IAM role 正確嗎?特定動作被允許嗎?工具設定正確嗎?
這是更好的除錯心態,因為有時候問題不是:
「我的程式不能用。」
而是:
「我的程式想使用某個它沒有權限使用的東西。」
Browser Tool 就給了我很好的例子。我已經把瀏覽能力設定好了,但 runtime 無法啟動瀏覽器 session。很容易會以為是 Browser Tool 本身壞了。
真正的問題是 runtime 少了必要的權限。我加上那個權限再測一次,這次就成功了。
這是個小修正,但它讓我理解到雲端應用程式的一件事:程式碼之外的東西很多。 應用程式還有身分、權限、資源、設定,以及服務之間的連線。這些部分都要彼此一致,功能才真的能運作。
部署不是終點
等到各個部分都正常運作後,我就透過 AgentCore 的部署流程把 agent 部署上去。這又是另一個讓我改變對部署看法的地方。
成功部署,不代表應用程式就一定成功。runtime 可以部署成功,但某個工具仍然可能存在設定或權限問題。
所以我把部署視為測試的開始,而不是開發的結束。我依照每項能力逐一測試已部署的 agent,這讓我比只看到「部署成功」訊息更有信心。
六個測試比一個巨大的「它有沒有用?」更容易
我沒有問自己:「我的 AI agent 有沒有用?」 而是把這個問題拆小。
它能追蹤訂單嗎?能處理退款嗎?能從 Knowledge Base 回答嗎?能跨會話記住資訊嗎?能正確計算忠誠度折扣嗎?能瀏覽即時網站嗎?
每一項都變成一個獨立測試。
我為這些測試都留下了證據,這樣我就有六個具體專案可以驗證,而不是一個龐大到讓人壓力很大的通過/失敗問題。
最後,六項都成功了。
<p align="center">
<img src="https://media.giphy.com/media/OSfbPHluvC96Coc2yx/giphy.gif" alt="Celebration reaction" width="400">
</p>
這種測試專案的方式,壓力小很多。
只有在全部都運作後才變清楚的部分
回頭看,我覺得最大的轉變發生在六項能力都能正常運作之後。在那之前,我只是在想個別服務。之後,我才終於看見那個模式。
模型理解請求,agent 判斷需要什麼,而工具提供相對應的能力。另一個服務執行工作,結果回來後,agent 再用那個結果回應。這個模式在六項能力中一再重複。
實際使用的工具不同,但背後的概念很相似:
訂單追蹤
→ 取得後端資訊

退款
→ 執行後端動作

Knowledge Base
→ 取得應用程式資訊

Memory
→ 取得顧客情境

Code Interpreter
→ 執行運算

Browser
→ 與即時資訊互動那時候,agent 這個詞才真的開始讓我覺得有意義。
<p align="center">
<img src="https://media.giphy.com/media/j6ZNNQ41WtdHzx0swq/giphy.gif" alt="Aha moment reaction" width="400">
</p>
它不只是:
「一個會跟你聊天的 AI 模型。」
而是:
「一個能理解需要發生什麼事,並使用各種能力真正去做事的模型。」
還有另一層我沒有想得夠多:操作這個系統
當 agent 開始正常運作後,我開始思考,如果這是一個真實的客服應用會怎樣。顧客不在乎是哪個服務失敗了,他們只知道自己的請求沒成功。
例如,一個訂單請求可能會經過:
顧客
   ↓
AgentCore Runtime
   ↓
Agent
   ↓
AgentCore Gateway
   ↓
API Gateway
   ↓
Lambda
   ↓
回應
如果這條路徑中的某個地方失敗,工程團隊就需要知道問題出在哪裡。這就是監控重要的原因。
在這個專案中,我使用 CloudWatch 來監控 AgentCore runtime,並建立了 CPU 使用率警示。如果我要把這套系統進一步用到真正的正式環境,我會想監控像是請求失敗、錯誤率、回應時間、工具失敗、資源使用量、服務健康狀態,以及成本等專案。
成本也很重要,因為這個 agent 使用了多個受管服務。小量請求下運作良好的專案,在大規模情況下,成本結構可能會完全不同。
這讓我意識到一件事:
做出能運作的東西,和把東西穩定地運作起來,是兩個不同的問題。
我也必須學會什麼時候專案才算真的完成
當 agent 能運作、專案也已提交之後,我回頭檢查自己建立過的 AWS 資源,並清理掉專案相關的資源。
這不是專案中最刺激的部分,但我認為這是雲端工作很重要的一部分。讓應用程式成功運作,不一定等於把周邊的雲端環境也處理完了。
當你建立雲端資源時,你應該知道自己建立了什麼、哪些還在執行,以及當你不再需要它們時會發生什麼。專案結束後還讓資源持續存在,可能會導致不必要的使用量與費用,尤其是當你使用了多個受管服務時。
對於像我這樣在有限雲端預算下學習的人來說,這一點更重要。我想在結束專案時知道,我已經清理掉那些不再需要的東西。
對我來說,清理本身也成了「真正完成專案」的一部分,而不是和專案分開的事情。
這個專案真正教會了我什麼
如果我能回到一開始,我不會告訴自己:「先把所有東西都學會。」我會告訴自己:
「你不需要在開始前就理解整個架構。」
我第一次看到這個專案時,想一次搞懂 AgentCore、Lambda、API Gateway、IAM、RAG、Memory、Browser Tool、Code Interpreter、部署和監控。那太多了。我知道每個服務叫什麼名字,但那不代表我理解它們應該如何協同運作。
真正有幫助的是把專案拆成更小的問題:這個資源是做什麼的?為什麼 agent 需要它?它會連到哪裡?我測試時應該發生什麼?如果失敗了會怎樣?
這些問題更容易回答,而每一個答案又讓下一個問題更容易理解。
我覺得這對於開始接觸一個看起來太大的東西特別有用。面對一個充滿服務的雲端架構,很容易心裡想:
「這些我一個都不懂。」
但你不需要一次懂全部。先從應用程式本身開始,問問使用者需要什麼事情發生。接著問系統要如何才能做到,然後去學解決那個特定問題的服務。
如果你需要儲存資料,就去學資料庫那一塊。如果你需要執行後端邏輯,就去學運算那一塊。如果 agent 需要檢索資訊,就去學檢索那一塊。如果它需要記住顧客情境,就去學記憶那一塊。如果它需要與外部能力互動,就去學工具或 gateway 那一塊。
你也不必假設每個問題都是 AI 問題。缺少權限可能看起來像功能壞掉。設定問題可能看起來像程式碼有錯。計算錯誤可能看起來像模型有問題。部署成功了,但某個能力仍然設定錯誤。
這也是我學到的重要一課。在這個專案之前,我可能會立刻去找程式問題。但在這個專案中,我變得更能接受先問:資源是否存在、是否在正確的區域、runtime 是否有權限存取、IAM role 是否正確,以及特定動作是否被允許。
我一開始做這個專案時,以為自己主要會學到 Amazon Bedrock AgentCore。我確實學到了,但我也學到它周邊的很多東西。我學到 AI agent 如何使用工具與後端系統互動,Knowledge Base 如何讓 agent 取得應用程式專屬資訊,Memory 如何改變跨會話對話的意義,以及為什麼精確計算有時候應該交給程式,而不是模型的推理。
我也學到 IAM 不是設定一次就可以放著不管的東西,成功部署不代表每個能力都正常,監控即使在一個相對小的專案中也很重要,而雲端開發也包含知道如何清理自己建立的資源。
我覺得這次帶進下一個專案裡最重要的,不是某一個特定 AWS 服務,而是一種面對一開始看起來太大的專案的方法。
現在當我看到一個複雜的架構時,我不會立刻想:
「我需要全部都懂。」
我會想:
「第一個部分是什麼?」
然後從那裡開始。
這不代表專案會突然變簡單。還是會有讓人困惑的時刻、要釐清的權限、要除錯的程式碼,以及要理解的設定。有時候你是讀了之後才理解一個服務;有時候是用過之後才理解;有時候則是它出了問題,你必須透過排查才真的懂。
這三種方式,都是學習。
所以,如果你現在正處於自己的 AI 或雲端旅程起點,而你眼前的專案看起來多到不行,先從一件事開始。理解它應該做什麼。讓那一部分先運作起來。然後再前進到下一個。
你不需要在現實中建置之前,就先在腦中把整個系統完整建好。
而這,大概就是我從這個專案中最珍惜的事。
我學會了如何讓一個複雜的專案變得可管理。
不是把專案變小。
而是把下一個問題變小。
一點小小的感謝
我要感謝 Udacity 以及所有參與 Future AWS Agent Engineer Nanodegree Program 的人,讓我有機會完成這樣一個專案。我也特別感謝 AWS AI & ML Scholarship,讓我得以參與這個課程。
這個專案帶給我的東西,不只是閱讀 AgentCore 文件就能完全理解的。我必須實際把各個部分串起來、除錯、測試。最後,當我回頭看整體架構時,我才發現自己真的看懂了眼前的東西。
我想這大概是對我來說最有價值的部分。
我很想聽聽你的想法
如果你做過 AI agent、用過 AWS,或正在學習雲端工程,我真的很想聽聽你的經驗。
你第一個覺得完全看不懂、但後來終於開始理解的雲端或 AI 概念是什麼? 或者,如果你現在正在做一個很困難的專案,你正在努力理解哪一部分?
歡迎在留言中分享。
有時候,現在對你來說很理所當然的事情,正是別人正在努力理解的內容。
🤝 讓我們保持聯繫
| 地點 | 在這裡找到我 |
|---|---|
| GitHub | 建造一些東西 → hemapriya-kanagala |
| 資源與更新 → hemapriya-kanagala | |
| X | 隨手寫寫開發想法 → @KanagalaHema |
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式