

有一個 API。它會告訴你一些儀表板不會告訴你的寫作資訊。
我從 2017 年 4 月開始在 Dev.to 發文。中間有整整四年幾乎什麼都沒貼,直到 2026 年 3 月才回來,結果在六個月內發了八十六篇文章。
這種形狀後來證明很有用。同一個帳號上的兩段截然不同的作品,中間隔著一段長到平台本身都已經改變的空白。這是一個我本來沒打算做、卻天然成立的實驗。
我想要的很簡單:把追蹤者成長曲線和文章發佈日期疊在一起,看看特定文章是否會推動那條線。結果我得到的,反而是一次相當不舒服的教育,讓我知道自己那些數字到底哪些有意義。
API 讓這一切成為可能,而且看起來幾乎沒什麼人在用。
沒錯,真的有 API
Base URL 是 https://dev.to/api。你可以到 Settings → Extensions → DEV Community API Keys 產生金鑰。大多數讀取你自己資料的端點都需要把這把金鑰放在 api-key 標頭裡。
有一個細節,會悄悄毀掉你整個下午:
headers = {
    "api-key": key,
    # 少了這個就會拿到 v0 回應。沒有錯誤。也沒有警告。
    "accept": "application/vnd.forem.api-v1+json",
    "user-agent": "my-analytics-script/1.0",
}
如果沒有 accept 標頭,你拿到的是舊版 v0 序列化結果。什麼都不會失敗,只是資料結構會安靜地不一樣,然後你會花二十分鐘懷疑為什麼文件裡明明有的欄位不見了。
技巧一:預設頁面大小不是最大值
文件把 followers 端點寫成每頁回傳 80 筆。我有一萬八千多個追蹤者,這代表要來回抓 227 次。
但 v1 的分頁範圍其實可以到 1000。80 只是預設值,不是上限:
batch = client.get(
    f"{API_ROOT}/followers/users",
    params={"page": page, "per_page": 1000},
).json()
19 次請求,而不是 227 次。31 秒,而不是 227 次有禮貌的請求可能要花的時間。
Forem 實例可以透過環境變數把 per_page 上限調低,所以不要把假設寫死。先要求最大值,再從回傳內容判斷真正的步長:
if page == 1 and len(batch) < requested:
    # 不是伺服器把我們上限降了,就是這已經是全部清單。
    # 不管怎樣,這才是實際的頁面大小。
    page_size = len(batch)
速率限制是真的,而且一點都不溫柔。遇到 429 要退避重試、每幾頁之間睡一下,並且把合併後的結果定期 checkpoint 到磁碟。一次很長的抓取如果在第 190 頁失敗,不該把前 189 頁全部丟掉。
技巧二:追蹤者日期能重建你從未記錄過的歷史
這是 API 裡最有用的一件事,而且很容易被忽略。
/api/followers/users 會在每個追蹤者資料裡回傳 created_at:也就是那個人開始追蹤你的日期。你不需要每天快照一次追蹤者數量,然後等六個月去累積時間序列。抓一次,就能回溯重建整條曲線,一路到你的第一個追蹤者。
from collections import Counter
from datetime import date, timedelta

dates = sorted(
    date.fromisoformat(f["created_at"][:10]) for f in followers
)
cumulative = list(range(1, len(dates) + 1))  # 成長曲線,免費的

weekly = Counter(d - timedelta(days=d.weekday()) for d in dates)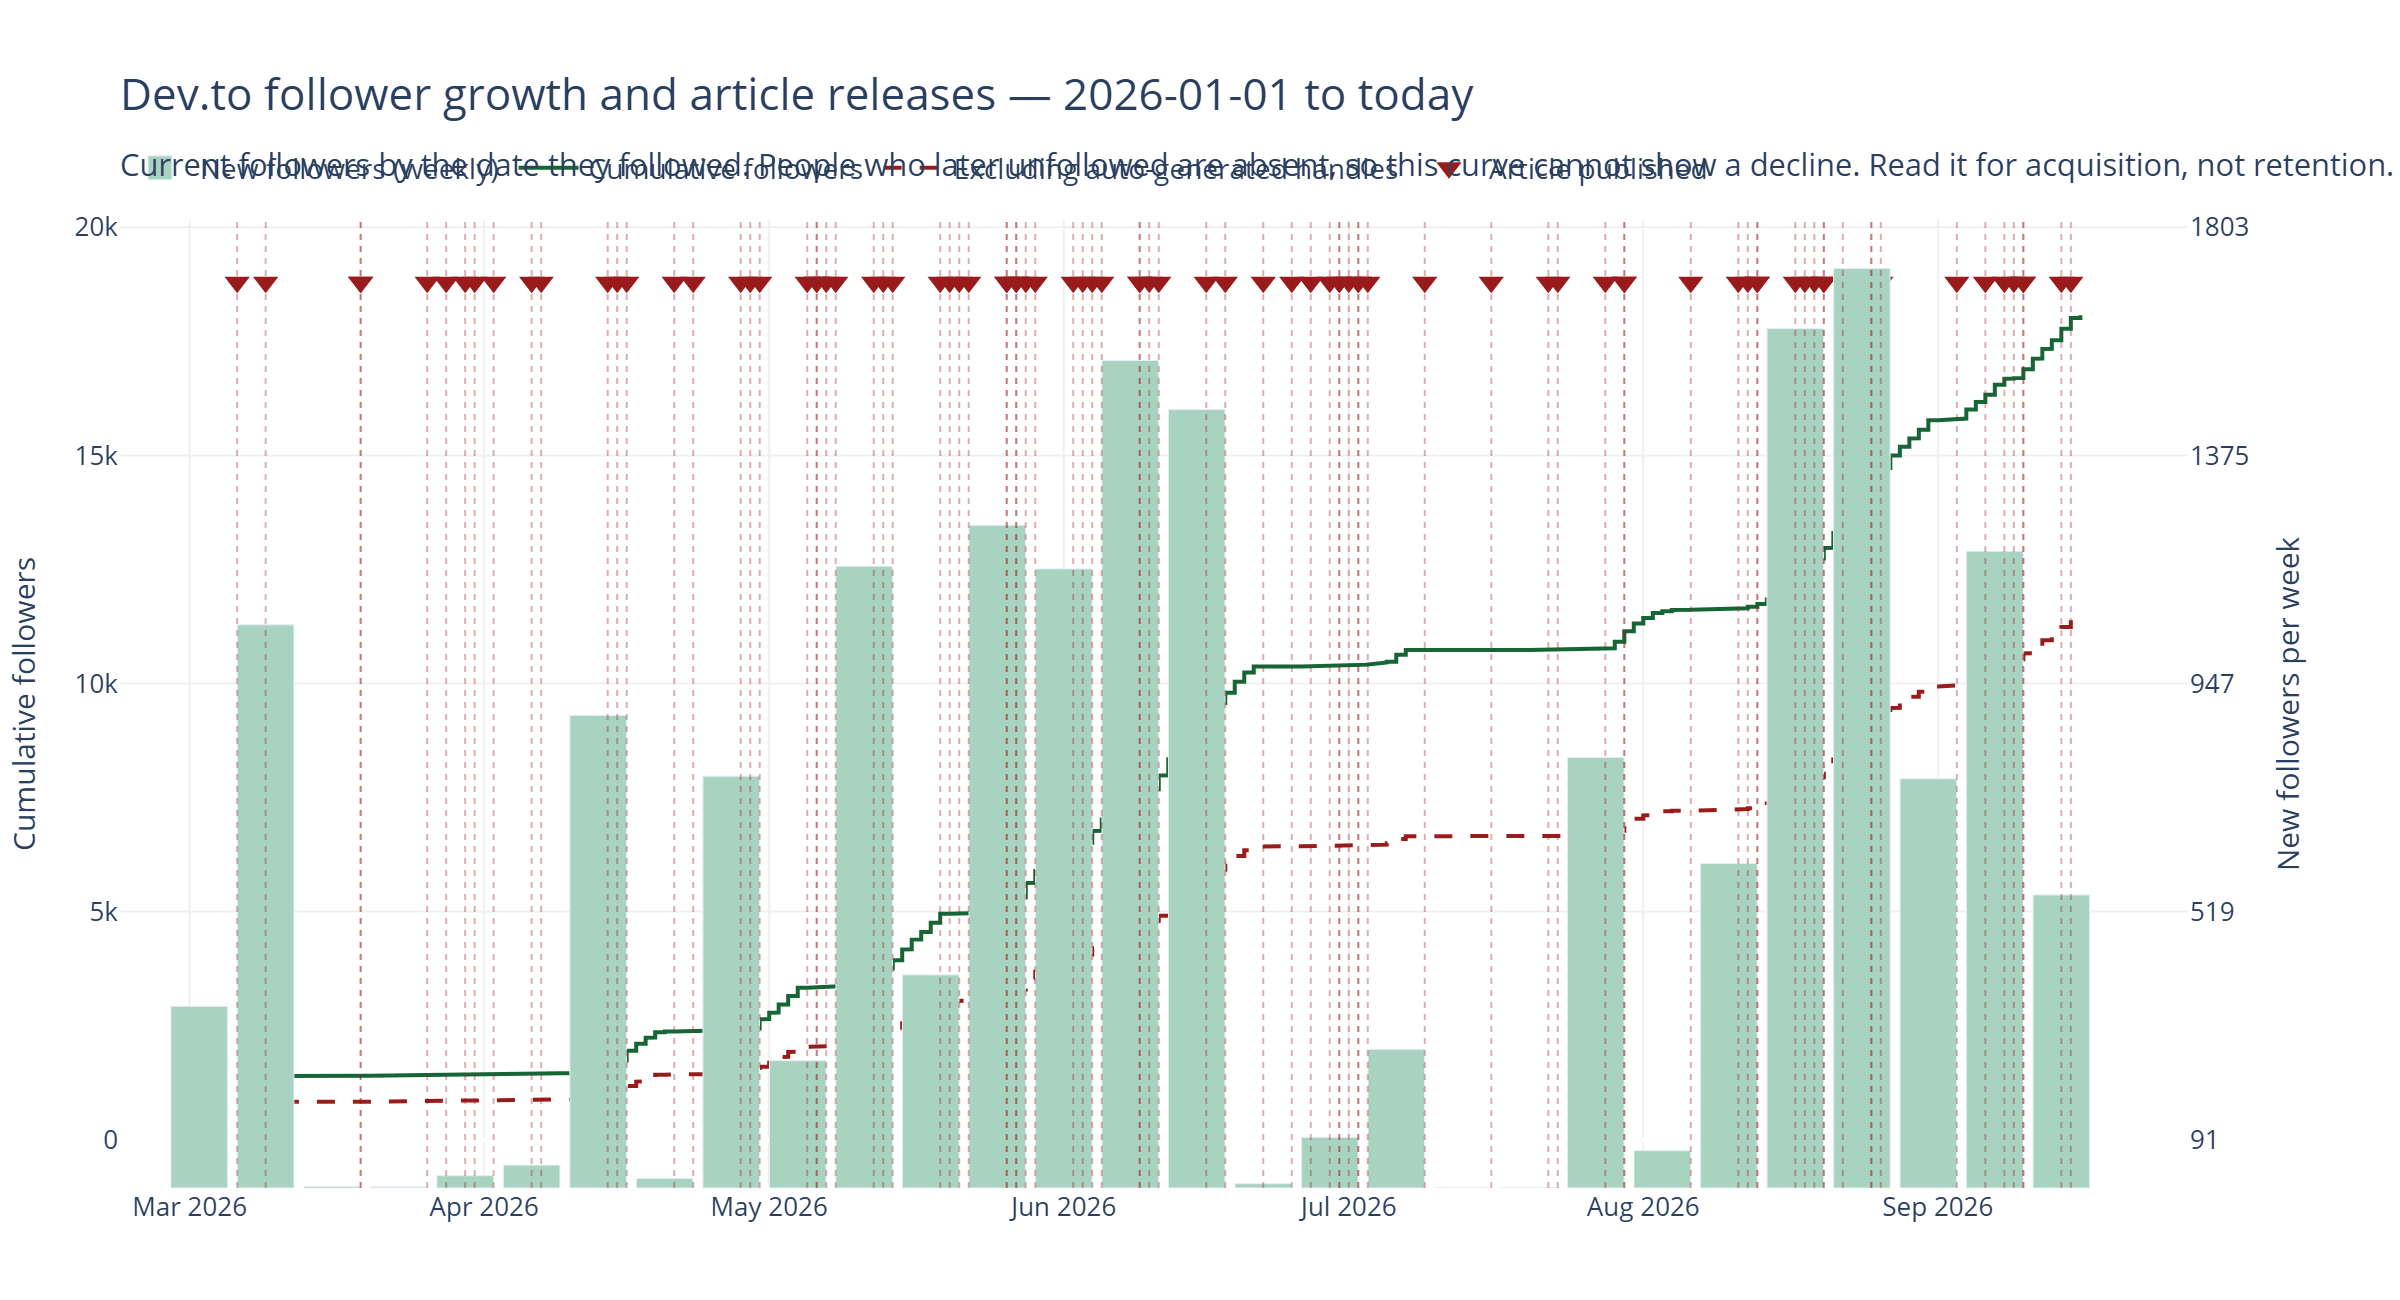
這裡有個值得明講的陷阱,因為我花了一點時間才看出來。你只會拿到那些目前仍然追蹤你的人。曾經追蹤、後來又取消追蹤的人,已經從資料集裡消失了。所以這條曲線其實是「依取得時間排序的現存追蹤者」,不是你在任何一天的實際追蹤者數。它在結構上只會單調上升,因此永遠不可能顯示真實發生過的下降。
如果你是在找出哪些文章帶來新追蹤者,那沒問題。若是要分析留存,這會嚴重誤導。
技巧三:分析端點真的存在,而且幾乎沒有文件
有一整組分析 API,大多數第三方工具都沒在用:
/api/analytics/totals               終身瀏覽、反應、留言
/api/analytics/historical           指定日期區間的每日序列
/api/analytics/past_day             最近 24 小時的每小時資料
/api/analytics/referrers            流量來源
/api/analytics/follower_engagement  追蹤者成長時間序列
/api/analytics/dashboard            總計 + 歷史 + 熱門文章,打包回傳
全部都接受 article_id,可只看單篇文章。有兩件事要知道。
回應是巢狀的,不是平面的整數:
{"page_views": {"total": 246454, "average_read_time_in_seconds": 306}}而且歷史資料會隨著時間往回退化。對我的 2017 年文章來說,這個端點回傳的是週級區間,而不是每日列;總和只涵蓋那些文章整體終身瀏覽量的約 15%。2019 年的文章則涵蓋 95%。2026 年的文章則是 100%。
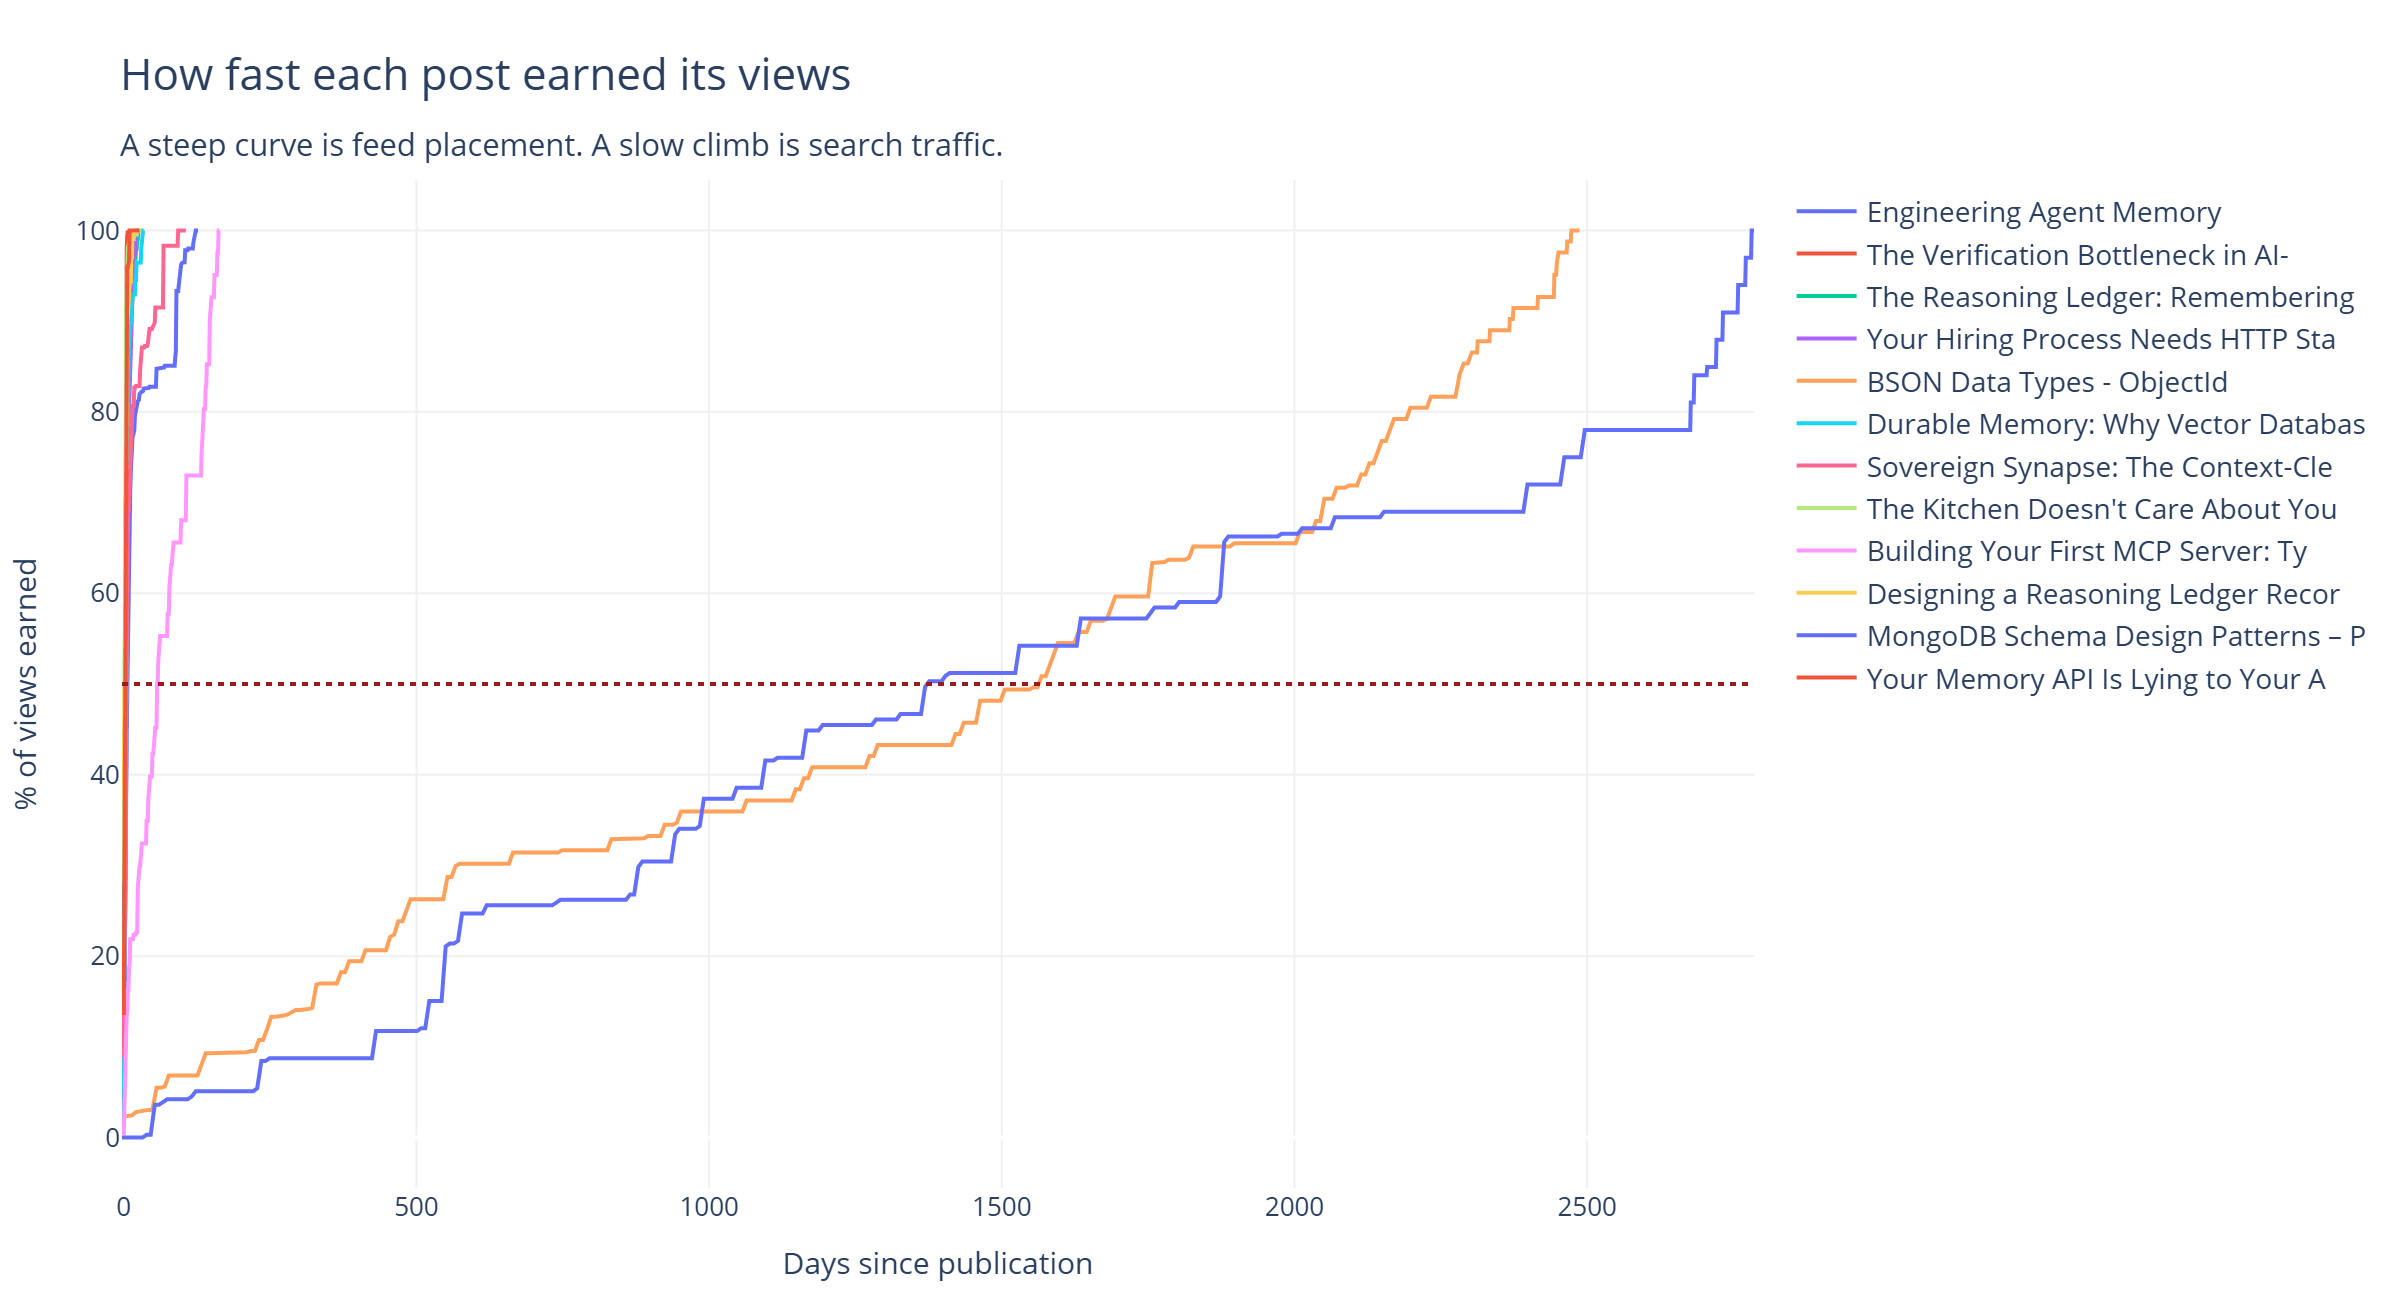
這一點比聽起來更重要。我曾為每篇文章計算一個「半衰期」,也就是從發佈到累積到一半瀏覽量所需的天數。第一次嘗試時,我很有把握地回報幾篇 2017 年文章的半衰期大約有 3,000 天。其實沒有。那個端點只是記不住那些文章真正賺到的大部分流量,而拿記得住的那一小部分去除,會產生一個精確、權威、但毫無意義的數字。
修正方法是設一個覆蓋率門檻:
lifetime = article["page_views_count"]
tracked = sum(daily_series.values())

# 一條只涵蓋文章 15% 瀏覽量的序列,仍然會算出
# 看起來很有把握的半衰期。那會是端點保留下來的結果,
# 而不是文章實際的成長曲線。
if lifetime and tracked < lifetime * 0.8:
    continue
我的 130 篇文章中,有 82 篇通過了這個門檻。它們的中位數半衰期是 4 天。
技巧四:有些中繼資料在 Markdown 裡,不在 JSON 裡
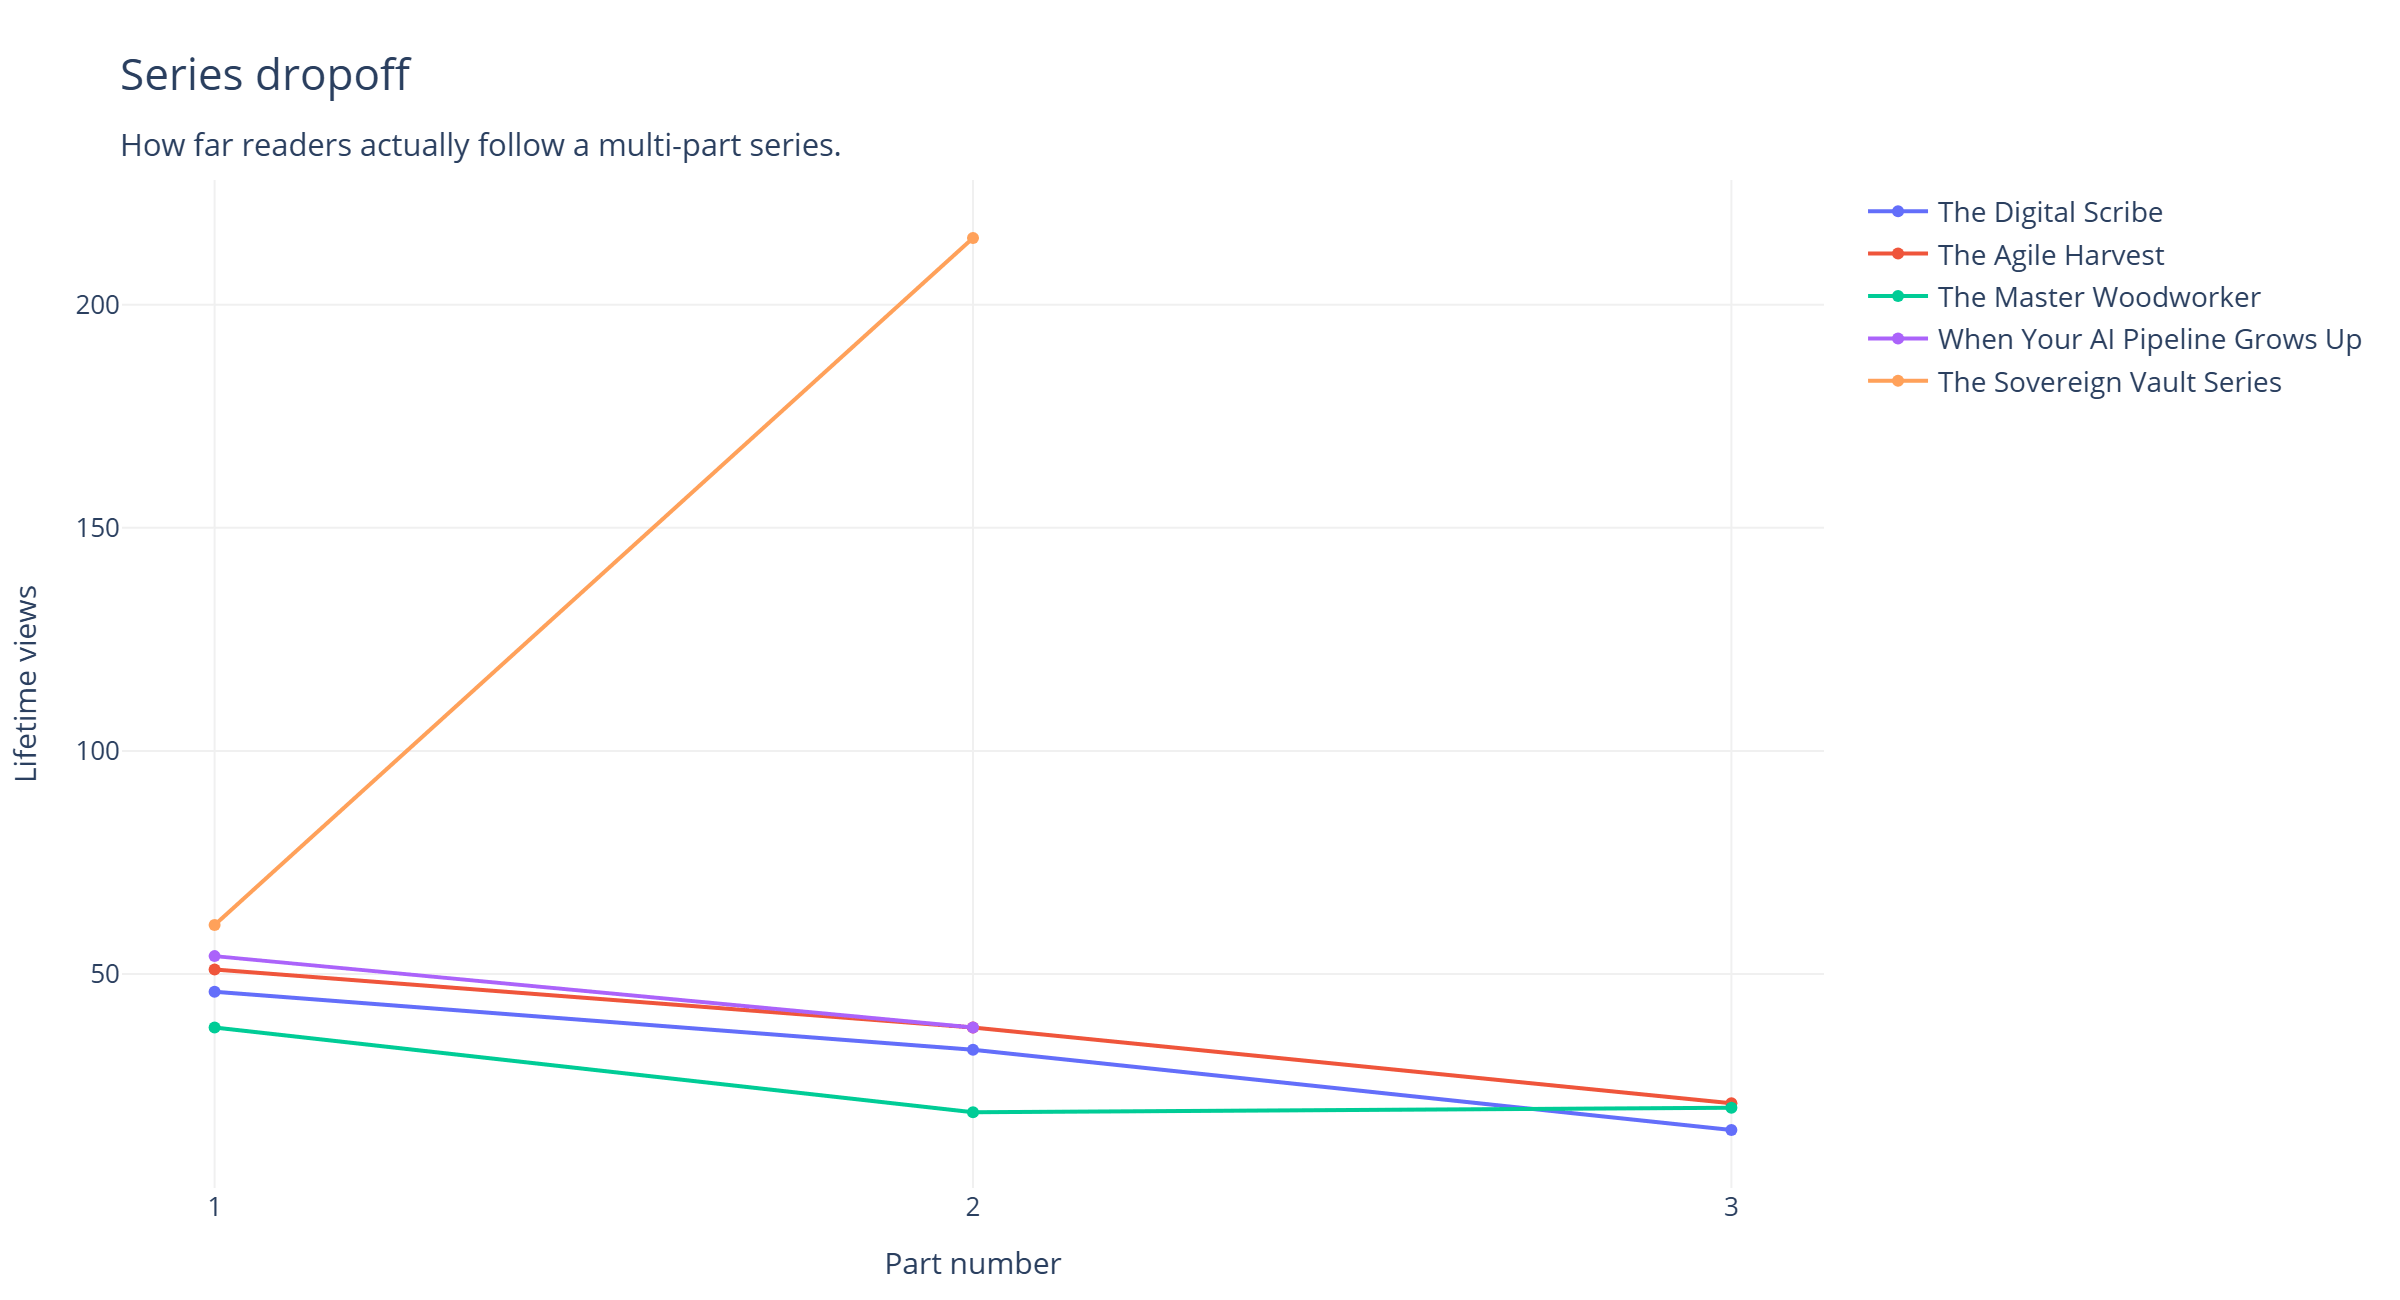
我會寫多篇系列文章。我的文章回傳裡都沒有 collection_id,而這正是你原本會拿來分組的欄位。
系列明明就在 Dev.to 的介面裡。但文章序列化結果就是沒帶這個欄位。
不過 /api/articles/me/published 會回傳 body_markdown,包含 front matter 在內,而系列名稱就躺在那裡:
FRONT_MATTER_SERIES = re.compile(r"^series:\s*(.+?)\s*$", re.M)

def series_name(article):
    body = article.get("body_markdown") or ""
    if not body.lstrip().startswith("---"):
        return None
    parts = body.split("---", 2)
    if len(parts) < 3:
        return None
    match = FRONT_MATTER_SERIES.search(parts[1])
    return match.group(1).strip().strip("\"'") if match else None
一般原則:當你預期的欄位不在 JSON 裡時,先看看原始文件本身有沒有一起回來。很多時候它其實有。
技巧五:留言一開始就是樹狀結構
/api/comments?a_id={id} 會以樹狀方式回傳留言,每則留言的回覆會巢狀放在 children 裡。這個結構本身就已經幫你完成了一部分分析工作,而如果要在保留深度的情況下攤平,大概只要八行:
def flatten(nodes, depth=0):
    out = []
    for node in nodes or []:
        out.append({
            "depth": depth,
            "username": (node.get("user") or {}).get("username"),
            "created_at": node.get("created_at"),
            "text": strip_html(node.get("body_html")),
        })
        out.extend(flatten(node.get("children") or [], depth + 1))
    return out
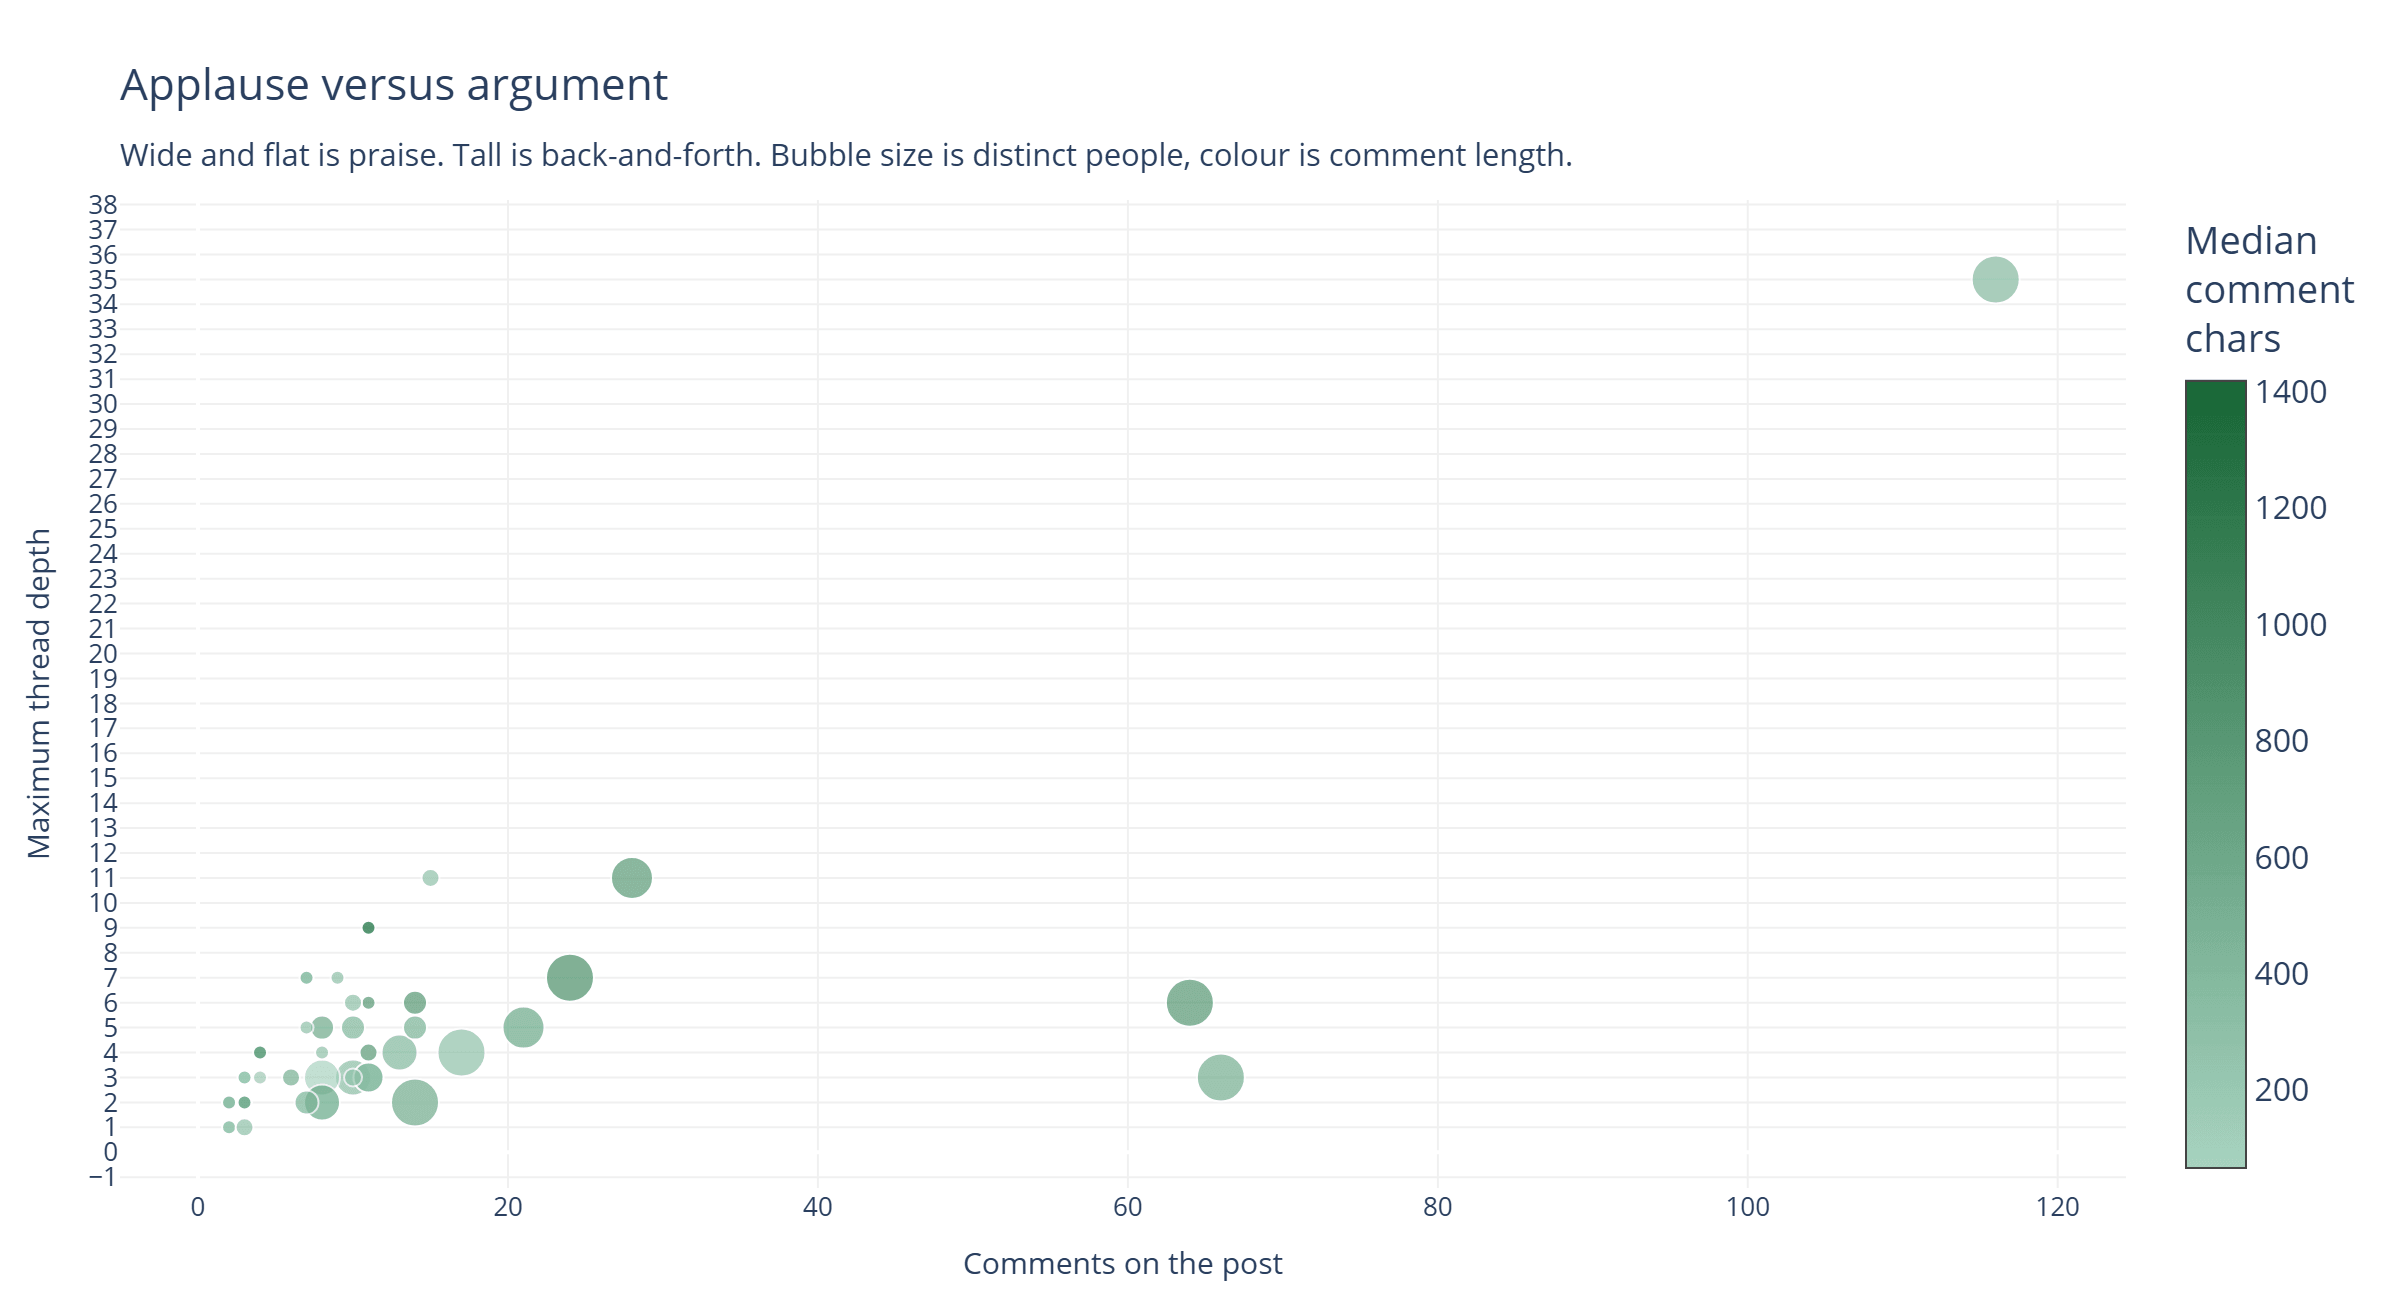
真正重要的是深度。留言「數量」分不出八個人各說一句「好文章」,和兩個人跟你吵四輪的差別。最大串深度可以。一篇我的文章留言串深達 35 層。那不是留言區,那是持續性的爭論,而任何只看數量的指標都不會告訴我這件事有發生。
順帶一提,沒有可用來「建立」留言的端點。回覆仍然必須用瀏覽器。大概是刻意的。
資料實際告訴了我什麼
從這裡開始,整件事就不再只是程式問題了。
我的追蹤者數不等於讀者數。 我在 2026 年大約增加了 18,000 名追蹤者。我的 2026 年文章加總只有 14,300 次瀏覽。你不可能從 14,000 次瀏覽中獲得 18,000 名追蹤者。每日增長中位數是 136,對我有沒有發文沒有明顯反應;而大約 37% 的使用者名稱帶有看起來像自動產生的十六進位或數字尾碼。那是互相追蹤灌水,已經非常普遍,而且跟我沒什麼關係。這也意味著我原本想做的那張圖,根本不可能回答我真正想問的問題。
我最受歡迎的作品已經九年了,而且現在已經沒人讀了。 我 2017 年的內容是 MicroPython、NodeMCU 和 MongoDB 教學。2017 到 2019 年的 44 篇文章帶來了 32,474 次瀏覽。2026 年的 86 篇文章則帶來 14,300 次。但每日序列告訴你另一半真相:我那篇有 5,472 次瀏覽的 NodeMCU 文章,在過去 90 天裡一次瀏覽都沒有。我的 130 篇文章中,有 19 篇這個季度是零瀏覽。終身計數永遠不會下降,這會讓一個早就沒在呼吸的存檔,看起來還活著。
互動資料完全顛倒了。 那些很久以前的大型教學文,每千次瀏覽大約只有 2 次反應。我的 2026 年散文則是 56 到 72 次,其中一篇達到每千次瀏覽 71.6 次反應、63.8 則留言。橫跨兩個時期來看:44 篇舊文章總共只拿到 26 則留言;86 篇新文章則拿到 606 則。
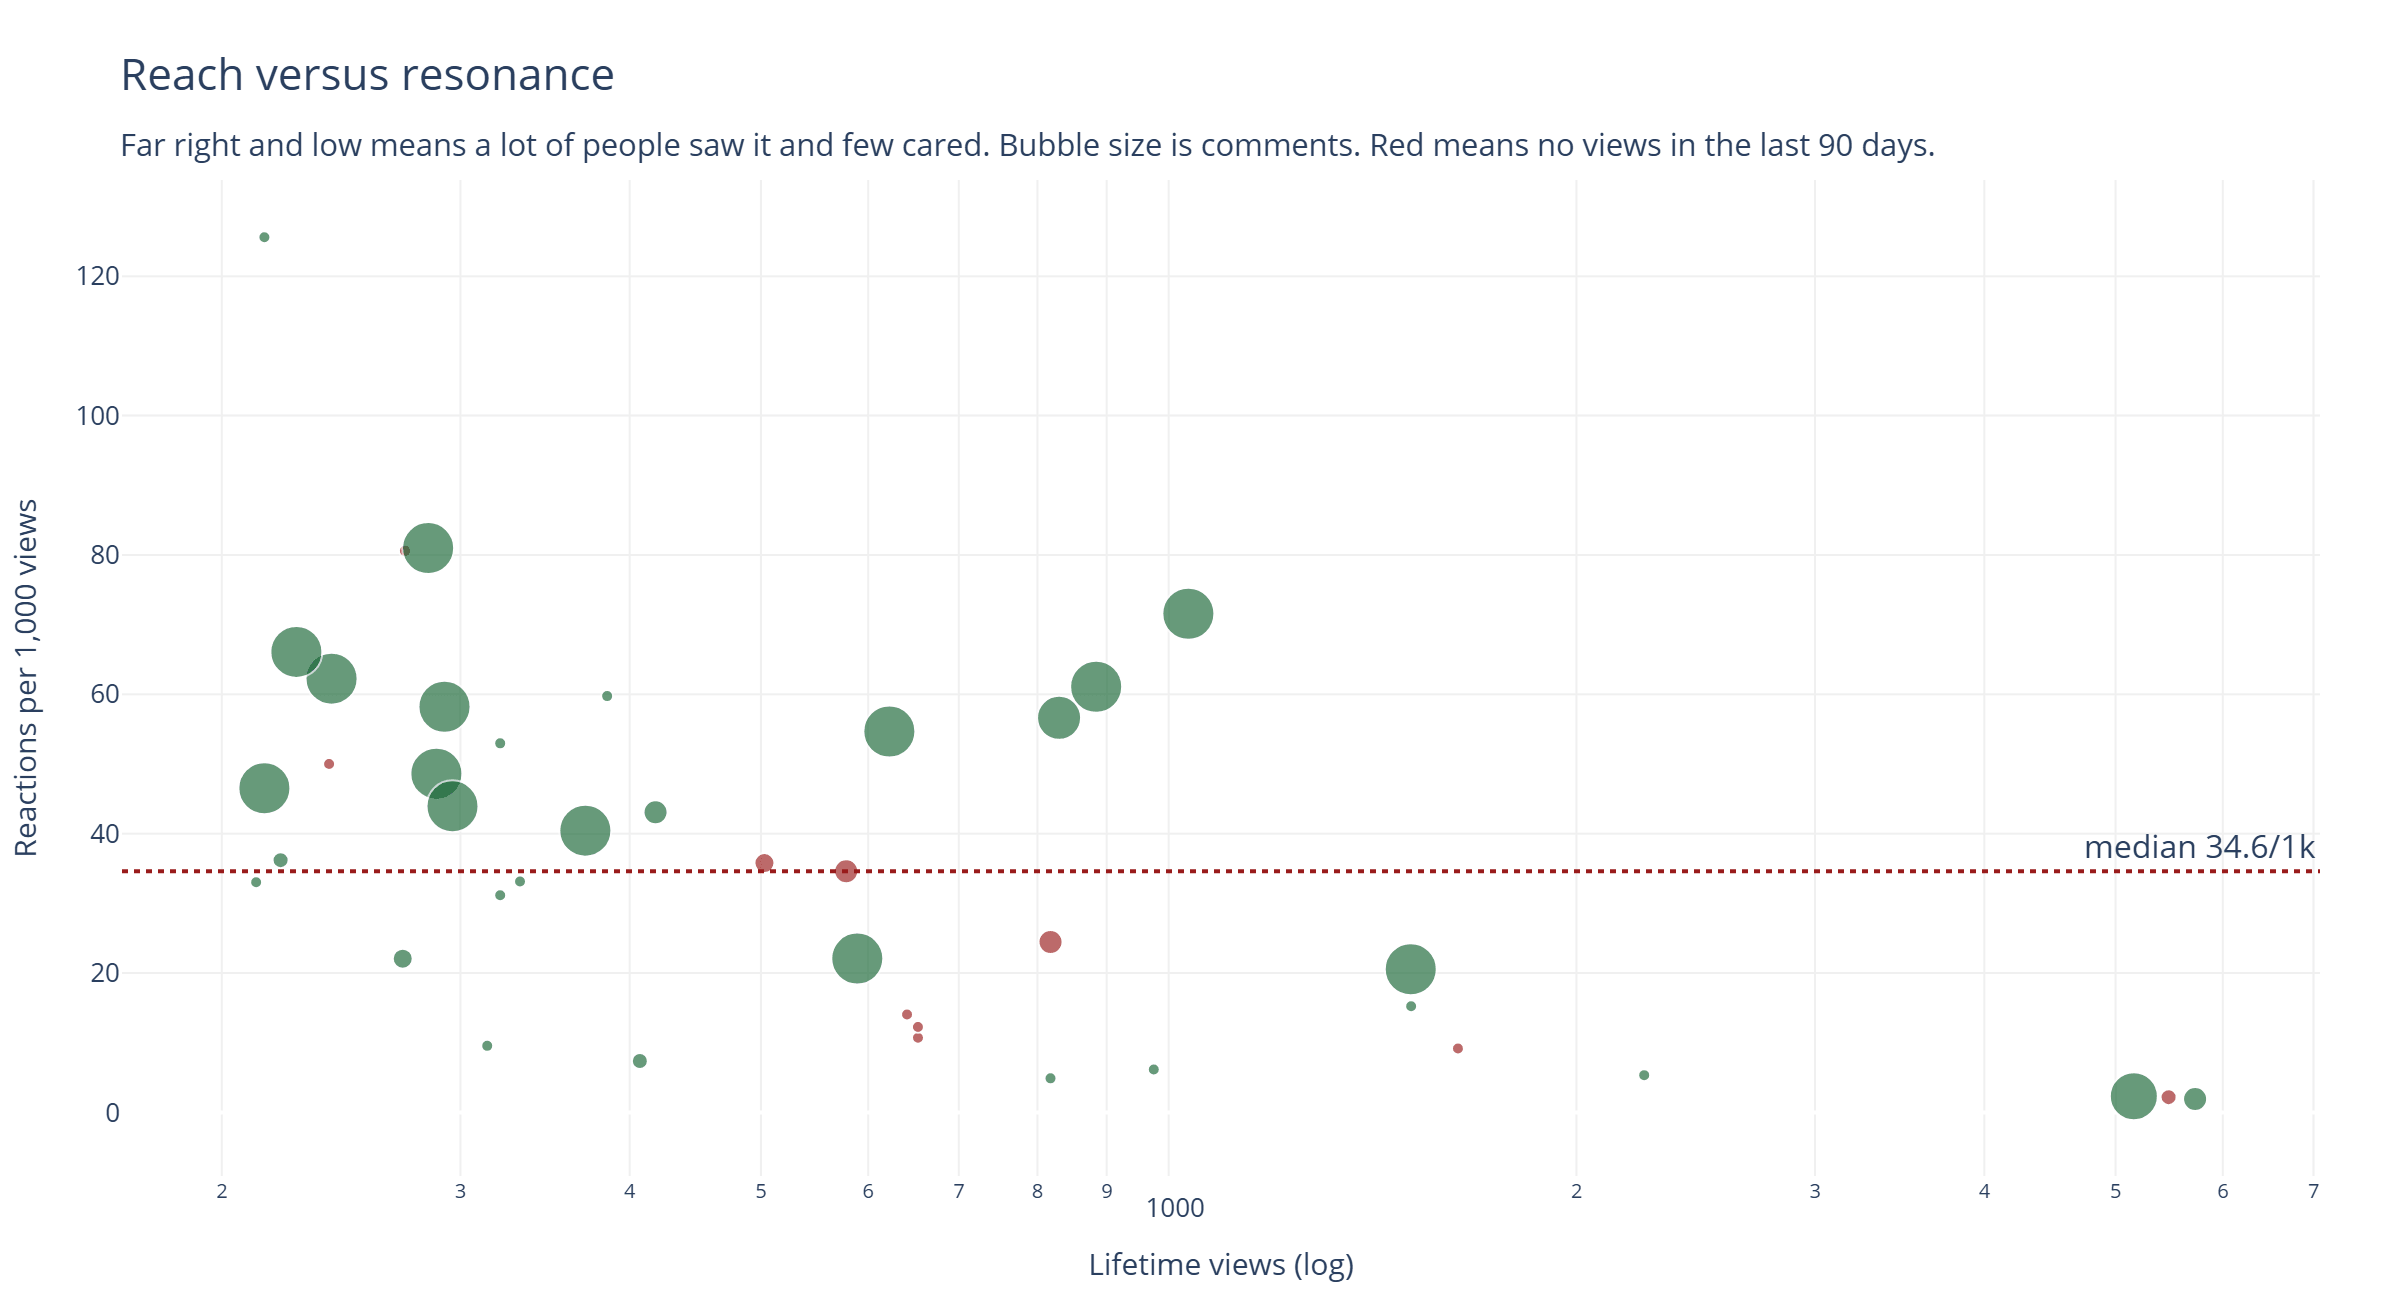
所以,一個作品集是被找到、被略讀;另一個則是被閱讀、被爭論。它們是不同的產品,而我一直用同一個數字在評估兩者。
我流量的 4% 來自 Google。 直接或未知來源是 74.5%。Dev.to 站內流量是 19%。對一個歷史上表現最好的內容是常青參考資料的人來說,這是我最難面對的一個數字。
如果有人要開始做這件事,我會怎麼說
先抓一次 followers 並快取起來,因為日期可以重建你從沒想過要記錄的多年歷史。所有分析計算都要先檢查資料覆蓋率,因為部分序列會給你一個自信但錯誤的答案,而不是報錯。看留言串深度,不要只看留言數。還有,在你判斷某個欄位不存在之前,先看看 body_markdown。
不過最重要的是:把衡量「散布」的指標,和衡量「有沒有人在乎」的指標分開。瀏覽量、追蹤者數、曝光次數屬於前者。留言深度、回覆率,以及同樣四個人一直出現在你的討論串裡,屬於後者。
我花了九年,以為前者就是排行榜。API 用了一個晚上告訴我:不是。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

