
很多團隊接新模型,不是卡在能不能呼叫,而是卡在後面的環節:輸入超出預期怎麼辦、輸出格式不穩怎麼辦、誰來做最後的把關。我把接入gpt-6.1-terra拆成五道關卡,每一關都寫清楚我測過什麼、哪裡需要自己加防護。
關卡一:接口與模型名
GPT-6.1 Terra相容OpenAI介面格式。接入時,替換base_url和model即可。我測試時使用的接口地址是https://api.crazyrouter.com/v1,請求送到/chat/completions,金鑰從環境變數讀取。下面是我實際運行過的呼叫方式:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["CRAZYROUTER_API_KEY"],
    base_url="https://api.crazyrouter.com/v1",
)

resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[
        {"role": "user", "content": "僅根據以下事實,用三句話介紹 GPT-6.1 Terra 的定位。事實:OpenAI 於 2026 年 10 月 26 日發布 GPT-6.1 Terra,API 模型 ID 為 gpt-6.1-terra,定位為快速、低成本,側重視覺理解、電腦操作和寫作,接替 GPT-5.6 Terra。"}
    ],
)
print(resp.choices[0].message.content)
運行結果為HTTP 200,服務端模型版本是gpt-6.1-terra-2026-10-26。我的建議是每次呼叫都記錄usage欄位,分開看輸入、輸出和推理token。推理token常常佔帳單的大頭,不能只按字數估算。
關卡二:截圖輸入的邊界
我用一張深色背景的軌道動畫介面截圖測試了視覺輸入。中央球體、六個標註圓點與顏色、左上角的FPS和速度數值、底部按鈕與滑桿位置,模型描述全部正確。
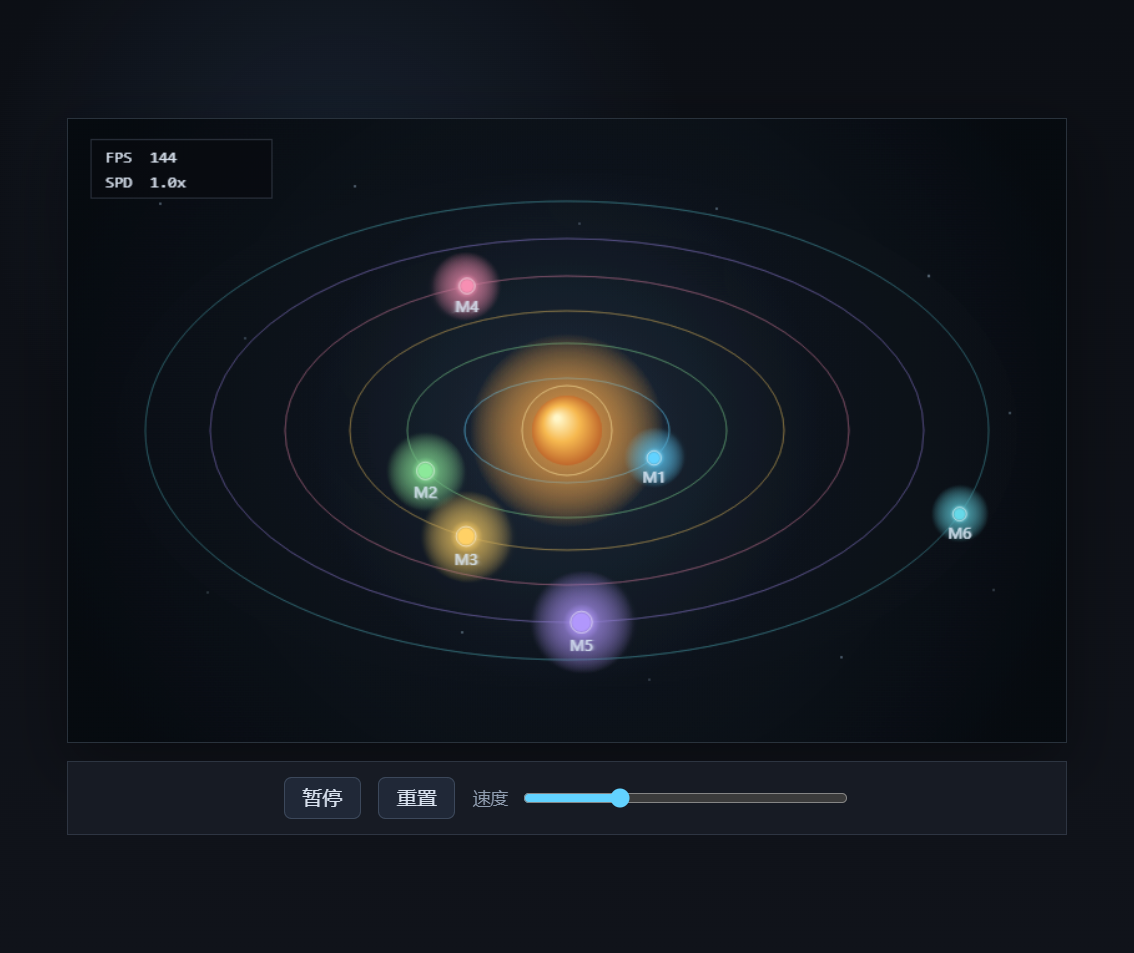
這一關的結論是:介面文字和控制項的定位可靠,可以作為流程中的一個環節。我的防護措施是對關鍵欄位做抽樣比對,並且限制單次輸入的圖片範圍,不要把整屏的所有資訊一次塞進去。
關卡三:操作規劃的邊界
模型只規劃動作,不會執行。我測試了兩個場景。第一個是設定頁打開數據共享開關,模型給出三步:點擊隱私、點擊控件toggle_share、驗證開關已開啟。第二個是檔案覆蓋的彈窗,模型沒有選預設的覆蓋按鈕,而是選擇另存為,並加入確認舊檔未被覆蓋的步驟。
執行器端要做的事:逐步執行而不是一次跑完;每一步之後檢查畫面狀態;覆蓋、刪除、付款這類節點必須人工確認。模型提供的是計畫,安全邊界要由程式來守。
關卡四:JSON輸出與校驗
在提示中要求合法JSON,返回內容可以直接解析。我的測試中,模型把模型ID、發布日期、定位標籤、輸入輸出模態、上下文視窗與最大輸出整理成單一物件,欄位齊全、型別正確。
接入時請加上JSON Schema校驗,解析失敗或欄位缺失時直接重試或進入人工佇列,不要悄悄寫入資料庫。這一關的防護比模型本身更重要。
關卡五:文字產出與人工審核
把發布日期、模型ID和官方定位交給它,它能寫出結構清楚的新聞式導語,適合作為草稿。我的做法是:模型產出後,編輯逐句核對事實,對照來源,再調整語氣。不要把模型輸出直接當成最終稿。
接入前的限制清單
- Terra定位為速度與成本,不以前沿推理為主,困難的長期推理仍應對照Sol或Astra;
- 超長上下文有附加計費,長時間運行的agent循環容易觸發;
- 發布初期不支持微調;
- ChatGPT Chat、免費版與Go版本暫不可用,部分功能有地區限制;
- 輸出只包含文字。
適合與不適合的情況
適合:批次處理截圖、介面文字與圖表;把人工操作說明轉成動作序列,交給執行器逐步完成;從公告或表單中批量抽取固定欄位。
不適合:複雜程式開發與工程級重構;需要無人值守、端到端真實操作桌面,又沒有執行器權限控制的流程。
總結:五關都過,才算接入完成
接入gpt-6.1-terra的關鍵,不在於呼叫成功,而在於五道關卡都有防護:接口正確、截圖抽樣核對、操作由執行器守住邊界、JSON經過校驗、文字經過人工審核。在這之上,建議用自己的真實樣本與Sol做一輪對比,再決定主力模型。
想比較同類模型,可以看對話模型彙總;需要查看Sol的規格,可以看GPT-6.1 Sol模型頁。想直接開始設定,可以參考Crazyrouter接入教學。
參考來源
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

