

title: "AWS 上的 AI Agent 治理:阻擋 Agent、證明符合 EU AI Act"
published: true
description: "我在 Amazon Bedrock 上打造了一個合成的多 Agent 貸款團隊,並讓 Traccia 硬性阻擋失控的 Agent、在每個子 Agent 的軌跡中遮罩申請人的個資,還能匯出 EU AI Act 審計證據。我寫的三條治理政策中有兩條什麼都沒擋住——而且不是我設定錯。原因正是這篇文章最有用的部分。"
series: "AWS 上的多 Agent AI:觀測、治理、證明"
tags: aws, ai, governance, discussion
這裡每個事實都已用實際執行驗證(Amazon Nova Pro us-east-1 隨選、Strands Agents 與 traccia 0.1.29,輸入每 1K 收費 $0.0008、輸出每 1K 收費 $0.0032;EU AI Act 附錄 III 的信用評分義務適用於 2027 年 12 月 2 日)。整個示範系統都刻意設為合成(SYNTHETIC)。
觀測性告訴我,Agent 批准了一筆本該拒絕的貸款。它也顯示了一次執行,把申請人的電子郵件洩漏到日誌裡。然後它什麼也沒做,因為它唯一能做的就是觀察。
本系列第一篇 在多 Agent AWS 團隊下方加上了真正的觀測層,並抓到了一次表面健康、其實默默超支的執行。這一篇要談的是觀測性做不到的兩件事:阻止錯誤的執行,以及在事後把文件交給監管機關。於是我在 Amazon Bedrock 上打造了一個合成的多 Agent 貸款決策團隊,接上 Traccia,並讓四件事在真實基礎設施上發生:提示注入在任何模型呼叫前就被硬性阻擋、申請人個資在每個子 Agent 的軌跡中被遮罩、EU AI Act 證據被蓋章到每個 span、而平台本身以一個真實且可引用的決策拒絕了一個失控的 Agent。
然後它沒照預期運作。我寫的三條政策裡,有兩條沒有擋下任何東西,而且不是我設定錯:這三種政策裡有兩種,在這個團隊結構上根本沒有可匹配的訊號。釐清為什麼,是這篇文章最有價值的部分,因為沒什麼人會把這種事情寫下來。
我如何測試: 這次建置、平台當天下午拒絕阻擋、我修掉的兩個真實 bug,以及文末的檢討,都是我親手做的。畫面上的一切都是真的(真實的 Nova Pro 呼叫、真實的治理決策、真實匯出的證據),團隊刻意設為合成,而且它產生的是證據,而不是合規——這個區別貫穿全文。$0 的 SDK 層不需要帳號。繼第一篇之後,進階平台方案 14 天免費試用(
@govern強制執行與 Governance Hub)讓我有動力深入挖掘,最後整理出對社群真正有用的內容,所以這裡的一切都能免費重現。
這篇是寫給那些已經在 AWS 上跑 Agent(Strands、CrewAI、LangGraph,或你自己在 Bedrock 上寫的迴圈)的人,你們聽「EU AI Act」聽到有點緊張,並且想要在不把應用程式重寫成合規框架的前提下,取得執行期護欄與審計證據。凡是治理詞彙第一次出現時,我都會先定義。
如果你只有兩分鐘,可以直接跳到 平台帶來的收穫,以及一開始為什麼沒成功。前面的鋪陳很重要,但那一段才是重點。
內容
- 為什麼 Agent 治理是不同的問題
- 團隊,以及它為什麼是合成的
- 兩層架構,而只有一層需要金鑰
- 先決條件
- 三個 $0 治理實作
- 平台帶來的收穫,以及一開始為什麼沒成功
- 監管機關會要求的證據
- 即時強制執行 vs 排程式偵測
- 現在做這件事的時機為什麼剛好
- 我對 Traccia 治理的誠實看法
- 誠實的限制
- FAQ
為什麼 Agent 治理是不同的問題
觀測性回答的是「Agent 做了什麼、花了多少錢」。治理要回答更難的兩件事:「我能不能阻止它做錯事,以及我能不能證明發生了什麼事。」這兩者不是同一層,而單靠 trace 只能給你第一層。
對於可決定性的服務,治理多半就是存取控制與輸入驗證。這兩者都很明顯,而且都在任何工作開始前於邊界上被強制執行。AI Agent 打破了這件事。它自己決定控制流程,所以阻擋必須中斷一個已經在執行的推理迴圈。它呼叫工具的順序不是你硬編碼的,所以失控是真實的失敗模式,而不是假設。
而且當它是多 Agent 團隊時,失敗面會擴大三倍。阻擋必須停止的是整個團隊,而不是某個子 Agent。遮罩必須涵蓋樹狀結構中的每一個 span,而不只是入口。真正燒掉預算的 Agent,可能是你包裝的那個 Agent 往下三層委派之後才出現。
現在還有法規直接掛在上面,不只是最佳實務。EU AI Act 把信用評分列為高風險用途(附錄 III,第 5(b) 項),並附帶具體義務:紀錄保存(第 12 條)、向部署者揭露(第 13 條)、人為監督(第 14 條)、事後事故回報(第 72 與 73 條),以及對某些部署者而言還要做基本權利影響評估(第 27 條)。第 50 條的透明度要求,也就是告知使用者正在與 AI 互動,已經可以執行。所以這裡的「治理」是具體的:一份特定監管機關會要求你拿出來看的清單。
先補一個詞彙錨點,因為後面會一直用到。Guardrail(護欄)會檢查輸入、輸出或工具呼叫,並決定是否允許。Policy(政策)是平台在執行時強制執行的規則(例如支出上限、工具呼叫上限、允許的模型清單)。Enforcement(強制執行)是政策命中後發生的事:呼叫被拒絕。Evidence(證據)則是這一切的持久記錄。整篇文章就是把正確的護欄與政策放到正確的 Agent 上,然後把證據讀回來。
團隊,以及它為什麼是合成的
一名主管貸款專員會使用 AWS Strands 的 agents-as-tools 模式,把工作委派給三個專家,每個人都呼叫 Amazon Nova Pro(amazon.nova-pro-v1:0)。
- Intake 會把申請人的自由文字解析成 id 和請求金額。個資會先落到這裡,所以會在這裡測試遮罩(但它同樣覆蓋整棵樹的每個 span)。
- Credit & Risk(
credit-risk)會呼叫一個模擬的credit_score工具,以及一個受區域限制的pull_bureau_report。這個 Agent 會實際發出工具呼叫。請記住它,因為它就是平台阻擋那一段的全部重點。 - Policy 套用一個可解釋、可重現的放款規則(收入對負債比與請求金額對收入比,從不使用受保護屬性),然後回傳 approve、refer 或 decline。
邊界上還有兩個護欄,和注入阻擋放在一起:一個是輸出驗證檢查,會拒絕任何做出絕對批准宣稱的推薦;另一個是公平性檢查,若受保護屬性左右了分數,就會拒絕該決策。公平性在這裡非常重要,因為這正是信用評分在 EU AI Act 下屬於高風險的原因。所以這個團隊會針對評分訊號進行斷言,並在受保護屬性出現時阻擋。
多 Agent 也確實讓它有存在價值。它讓治理在真正重要的地方變得更難,而單一 Agent 的示範會隱藏全部三個問題:阻擋必須停止整個團隊、遮罩必須覆蓋整棵樹、而團隊確實可能失控,所以迴圈上限不是硬湊出來的,而是合理的。
現在先把必須說清楚的誠實話放前面:信用分數是模擬的。 沒有真實徵信機構、沒有真實模型決策、也沒有真實申請人。評分是一個只使用合法財務訊號的確定性啟發式,而且從設計上就完全不碰受保護屬性(有單元測試精確驗證這件事)。真實的高風險信用系統需要法律上的符合性評估;這個專案產出的是那種系統會產生的證據基礎層,不是合規本身。我也因此在畫面上把一切都標成「synthetic」:假裝是真實貸放機構的治理示範,與可信恰好相反。
兩層架構,而只有一層需要金鑰
Traccia 的治理分成兩層,而把這個分割看對,是這篇文章的大部分。
| 層級 | 需要金鑰嗎? | 做什麼 |
|---|---|---|
| SDK / in-process | 不需要($0、離線) | 護欄偵測、明確硬性阻擋、個資遮罩、EU AI Act 蓋章、透明度證據、完整性雜湊。全部都在匯出前,以 OpenTelemetry span processor 形式執行。 |
| 平台 | 需要(TRACCIA_API_KEY) |
@govern 的網路化強制執行(Spend Cap、Model Boundary、Loop Cap),以及 Governance Hub:系統登錄、人為審查、事故、證據包、FRIA。 |
@observe 可以讓你在任何 OTLP 後端上取得觀測性,不需要金鑰。@govern 則增加執行期政策強制執行,需要平台。這裡要講清楚一個很容易混淆、但其實很重要的點:本機的硬性阻擋與 PII 遮罩,不論有沒有金鑰,都在 in-process 內執行。 金鑰不是用來驅動阻擋的。金鑰新增的是網路化強制執行與審計中心。所以誠實的說法應該是「SDK 在本機治理;平台負責強制執行與記錄」,而不是「你得付費才能擋住任何東西」。
關於 SDK 層還有一件要坦白的事,因為我看過原始碼確認過:Traccia 的 guardrail 負責偵測,不是負責強制執行。這個三層引擎會把發現寫進 span。下方 Beat 1 的「阻擋」其實是我自己的程式在 guardrail 結果上 raise,不是 guardrail 引擎真的自己停掉了什麼。把這個差別講清楚,才是正確描述工具,而不是誇大它。
先決條件
只要三樣,而只有第三樣是為了平台那一層。
- Python 3.10+ 與 SDK(
strands-agents、strands-agents-tools、traccia、boto3)。倉庫在requirements.txt中鎖定了測試版本(traccia 0.1.29、strands-agents 1.56.0、boto3 1.43.99)。 - AWS 憑證,且對 Nova Pro 擁有
bedrock:InvokeModel權限。倉庫提供了最小權限政策,放在iam/bedrock-invoke-policy.json,只允許對amazon.nova-pro-v1:0執行 InvokeModel。你也需要先到 Bedrock 主控台的 Model access 啟用 Nova Pro 一次(主控台授權不是 IAM 權限,所以兩者都需要)。「$0 的 Traccia」仍然代表你要真的呼叫 Bedrock,所以要跑這個團隊,這項是必要的。 - Traccia 平台金鑰(
TRACCIA_API_KEY)只用於@govern的強制執行與 Governance Hub。其他一切都不需要它。
安裝、設定、開始跑的步驟如下:
git clone https://github.com/simplynadaf/ai-agent-governance-aws.git
cd ai-agent-governance-aws
ls -a                # 這裡沒有 .env - 只有附帶的 .env,而且金鑰行都被註解掉了
cat .env             # 證明 $0 的那些步驟不需要金鑰
make setup           # 虛擬環境 + 鎖定版相依套件 + git hooks
make test            # 10/10 單元測試:純邏輯、無 AWS、無金鑰
乾淨的 clone 在沒有金鑰的情況下就能跑 $0 的那些步驟。版本控制中的 .env 會把金鑰行註解掉,所以在畫面上 cat .env,就足以證明「$0、不要金鑰」是真的,不是註腳。你真正的金鑰在本機放進同一個檔案;pre-commit hook 會阻止任何含有未註解金鑰的提交。
三個 $0 治理實作
這些只需要安裝好與 AWS 憑證,就能執行,並把 trace 寫到本機的 traces_gov.jsonl 檔案。
實作 1:硬性阻擋提示注入
一個用 @observe(as_type="guardrail") 裝飾的偵測器會回傳布林值,SDK 會自動從中設定 guardrail.triggered。你的程式再依此 raise。團隊在主管呼叫模型之前就會停止。
@observe(as_type="guardrail", attributes={"guardrail.category": "prompt_injection",
                                           "guardrail.enforcement_mode": "block"})
def injection_check(text: str) -> bool:
    return any(kw in text.lower() for kw in INJECTION_KEYWORDS)

# 在團隊入口點:
if injection_check(text):
    raise BlockedByGuardrail("Prompt injection detected. Crew blocked before any model call.")
證明的重點不是 log 那一行,而是 trace:被阻擋的執行沒有任何子 Agent span。 Intake、Credit & Risk 與 Policy 都沒有跑。我是靠計算匯出檔中的 span 數量來驗證這件事:被阻擋的 trace 只包含注入檢查和團隊根節點。若一個真正能停止多 Agent 團隊的阻擋,就會讓下游什麼都不剩,而 trace 正是你確認這件事的地方,不是相信一行 print。
這裡有個值得誠實說明的命名細節:SDK 真正的訊號是 guardrail.triggered(由 guardrail 的布林回傳自動設定)。團隊停止的旗標 demo.crew.blocked 是我自己的屬性,不是 SDK 的。我把兩者分開,就是不想讓任何人以為 SDK 做了它其實沒有做的事。
實作 2:在每個子 Agent 上遮罩個資
init(redact_pii=True) 會加入一個 regex processor,在匯出前把電子郵件、電話與 SSN 在每個 span 中遮罩成 [REDACTED_EMAIL]、[REDACTED_PHONE]、[REDACTED_SSN]。我用唯一重要的方式驗證:搜尋所有 span 屬性中是否存在測試用電子郵件與 SSN 的字串。整個多 Agent 樹狀結構中都是零命中,不只是 Intake 入口點。
坦白說它的限制:這是盡力而為的 regex,不是 ML NER。它能抓到像電子郵件、SSN 這類有標記的格式;名字、地址與未標記的 id 可能漏掉,而且也可能過度遮罩。在真實系統中,你應該把這點講明白,並在上面再疊一層真正的 PII 分類器。
實作 3:蓋上 EU AI Act 證據
init(compliance={"frameworks": ["eu_ai_act"], "risk_tier": "high"}) 會自動把 eu_ai_act.risk_tier=high 加到每個 span。信用評分是附錄 III 第 5(b) 項的教科書案例,所以我手動蓋上 eu_ai_act.annex_iii_category="5b_creditworthiness"。這個區分是刻意設計而且已用 SDK 原始碼驗證:SDK 會自動寫入 risk_tier,但附錄 III 的 key 是保留常數,不會自動填入,所以你要它,就得自己設。disclosure() 會記錄第 50 條透明度,而每個 span 都帶有自動的 governance.integrity_hash。
一份白話報告可以直接從 trace 檔讀出來,所以合規審查者不需要打開原始 span JSON:
有執行的 AGENT:loan-prescreen, intake, credit-risk, policy
護欄層級:      A 顯式 YES · B provider-native「未觀察到」· C heuristic YES
EU AI Act:     risk_tier N/N spans · annex_iii YES · Art.50 YES · integrity_hash YES
PII 洩漏檢查:   原始測試 PII 找到 0 處(必須是 0)
這裡有一個多數教學會略過、但我的 verify_trace.py 現在會印出的誠實說明。Traccia 的 guardrail 引擎有三個偵測層:A(顯式,也就是你用 @observe 寫的 guardrail)、B(provider-native,當模型本身回傳安全或停止訊號時觸發)、以及 C(heuristic,當某個工具 span 因拒絕關鍵字而錯誤時觸發)。我示範的是 A 與 C 觸發(注入阻擋是 A;對歐盟申請人因區域限制而報錯的徵信工具呼叫是 C)。B 層不會在乾淨執行時觸發,這是預期行為,不是缺陷。所以誠實的說法是「A 與 C 有示範;B 會在模型自己的安全訊號出現時觸發」,絕不能說「三層全都觸發」。
平台帶來的收穫,以及一開始為什麼沒成功
這裡就是我那天下午卡住的地方,也就是後來得到的教訓。
我把 @govern(fail_open=False) 套在團隊入口點,把金鑰放進 .env,然後執行。結果:ALLOWED。沒有阻擋。
在任何政策能被評估之前,還有一個設定陷阱要先排除。@govern 需要的是 tracing 的endpoint,不只是金鑰。若沒有設定 TRACCIA_ENDPOINT,SDK 會記錄「找不到 Traccia endpoint」,然後靜默跳過強制執行,回傳 ALLOWED。我把 TRACCIA_ENDPOINT=https://api.traccia.ai/v2/traces 設上去,警告就消失了。這時強制執行才真的有在跑,所以真正的診斷可以開始。結果它還是回傳 ALLOWED。
接著我建立了一條 Model Boundary 政策,只允許 gpt-4o(這個團隊用的是 Nova Pro),把它範圍限定在團隊 Agent loan-prescreen,設為 Block,並啟用。再跑一次。還是 ALLOWED。 這就是第一條本來應該阻擋卻沒有的政策。
讓我找出答案的是 Dashboard 裡的 Decision Log。它會把每次呼叫的政策檢查按 trace 分組,而每一列都寫著同樣兩件事:No Match,而且檢查是歸屬於 Agent credit-risk,不是 loan-prescreen。
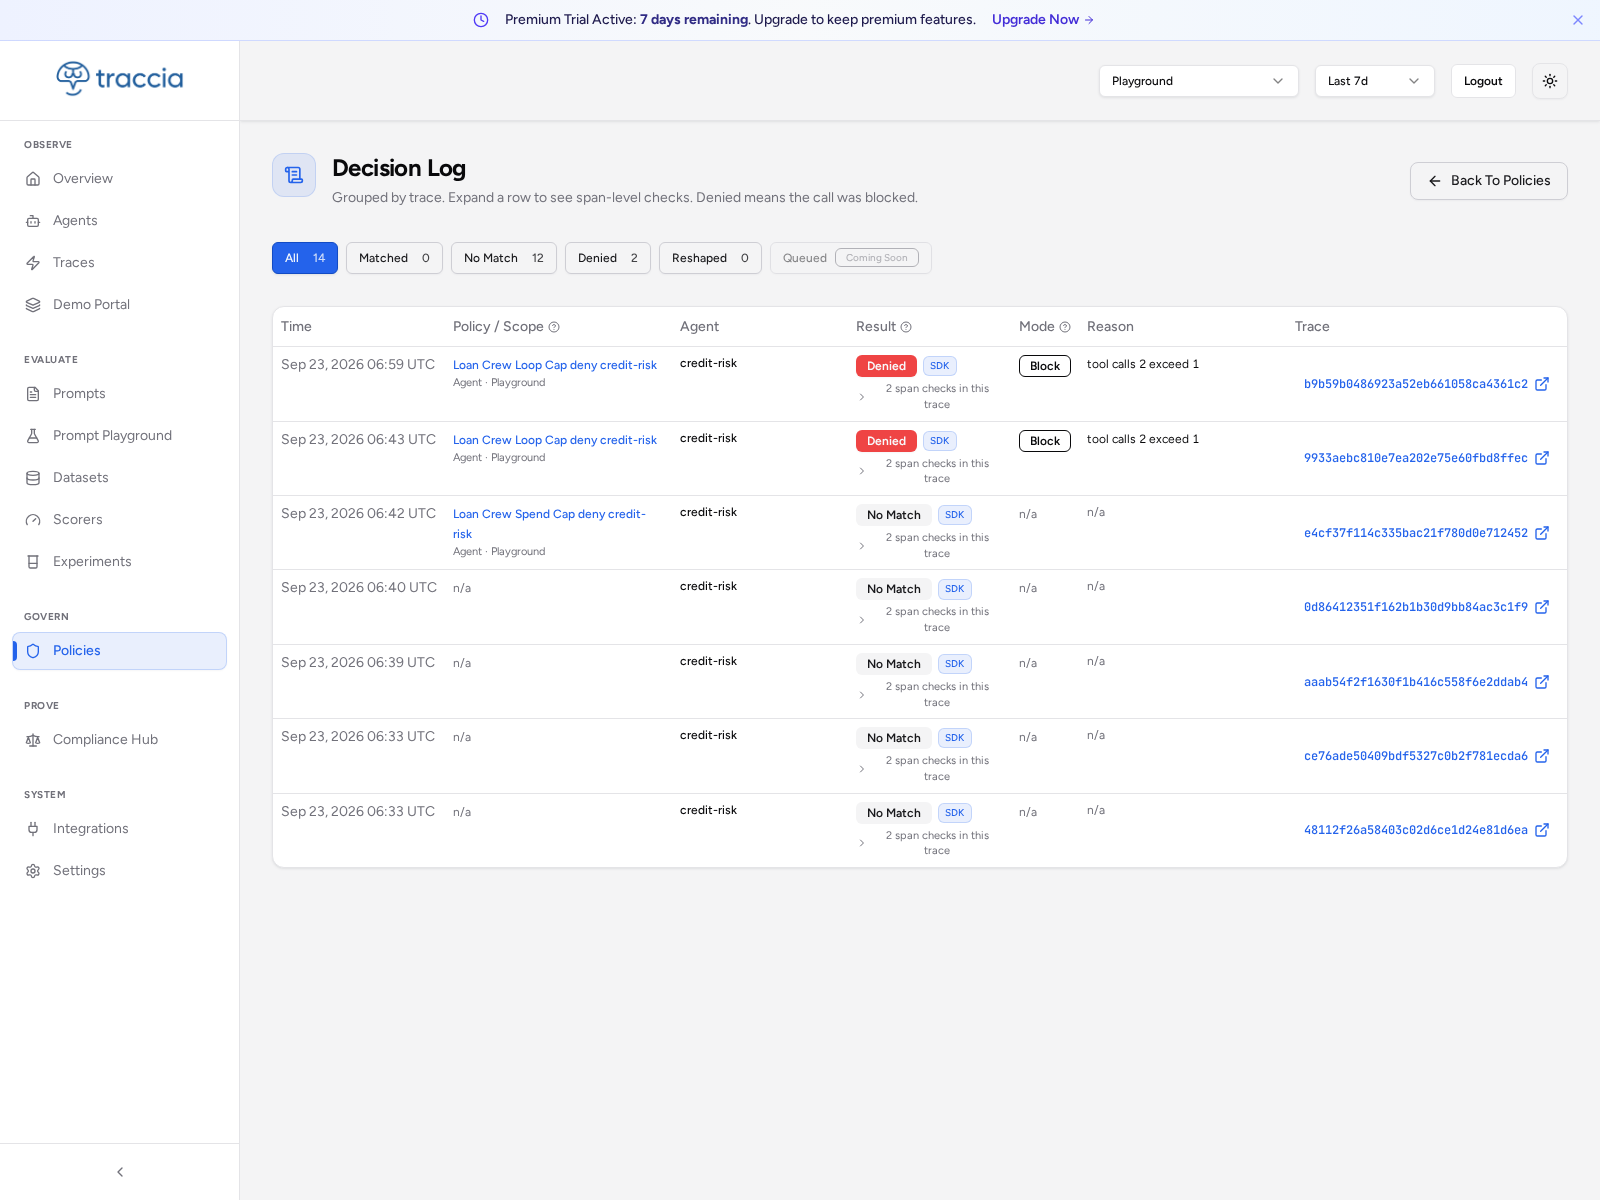
Decision Log 就是這次讓我釐清問題的畫面。每一列都是綁定到某個 trace 的每次呼叫檢查。No Match 的列告訴我為什麼我最早的那些政策會失敗;Denied 的列(Loop Cap,credit-risk,「tool calls 2 exceed 1」)則是最後真正成功阻擋的那條。每一次檢查都歸屬於 credit-risk,不是 @govern 入口點。
這裡浮現兩個教訓,而它們正是文件與參考論文沒有寫清楚的內容。
教訓 1:政策要套用在真正發出呼叫的 Agent 上。 我的團隊會用 Strands 的 run_identity 包住每個子 Agent,所以每次呼叫的政策檢查,是以子 Agent 的身分(credit-risk)執行,而不是 @govern 入口點的身分(loan-prescreen)。套在入口點的政策永遠不會命中,因為沒有任何呼叫會被歸給它。應該套在子 Agent 上,或組織層級上。
教訓 2:政策類型要與 span 實際承載的訊號相符。 我把一條 Spend Cap(預算 $0)重新套到 credit-risk。還是 No Match。每個 trace 裡的兩個 span 檢查是兩次 tool 呼叫(credit_score 和 pull_bureau_report),而它們的成本幾乎是零,所以支出規則根本沒東西可以觸發。Model Boundary 需要一個自動補丁的 LLM client 來檢查使用中的模型,而 Strands 的 BedrockModel 不是 Traccia 會自動 patch 的 client。因此這兩種政策都無法匹配這個團隊,原因還不同。
Loop Cap 會計算每次執行中的工具呼叫數。這個團隊剛好會呼叫兩次。所以我把 Max Tool Calls Per Run 設成 1,Block,範圍限定在 credit-risk,然後啟用,再執行:
PLATFORM BLOCK - AgentBlockedError:
   reasons             : ['tool calls 2 exceed 1']
   decision_id         : b5a3a3e4-6b62-4c81-9c07-358773735d44   (每次執行都不同)
   remaining_budget_usd: None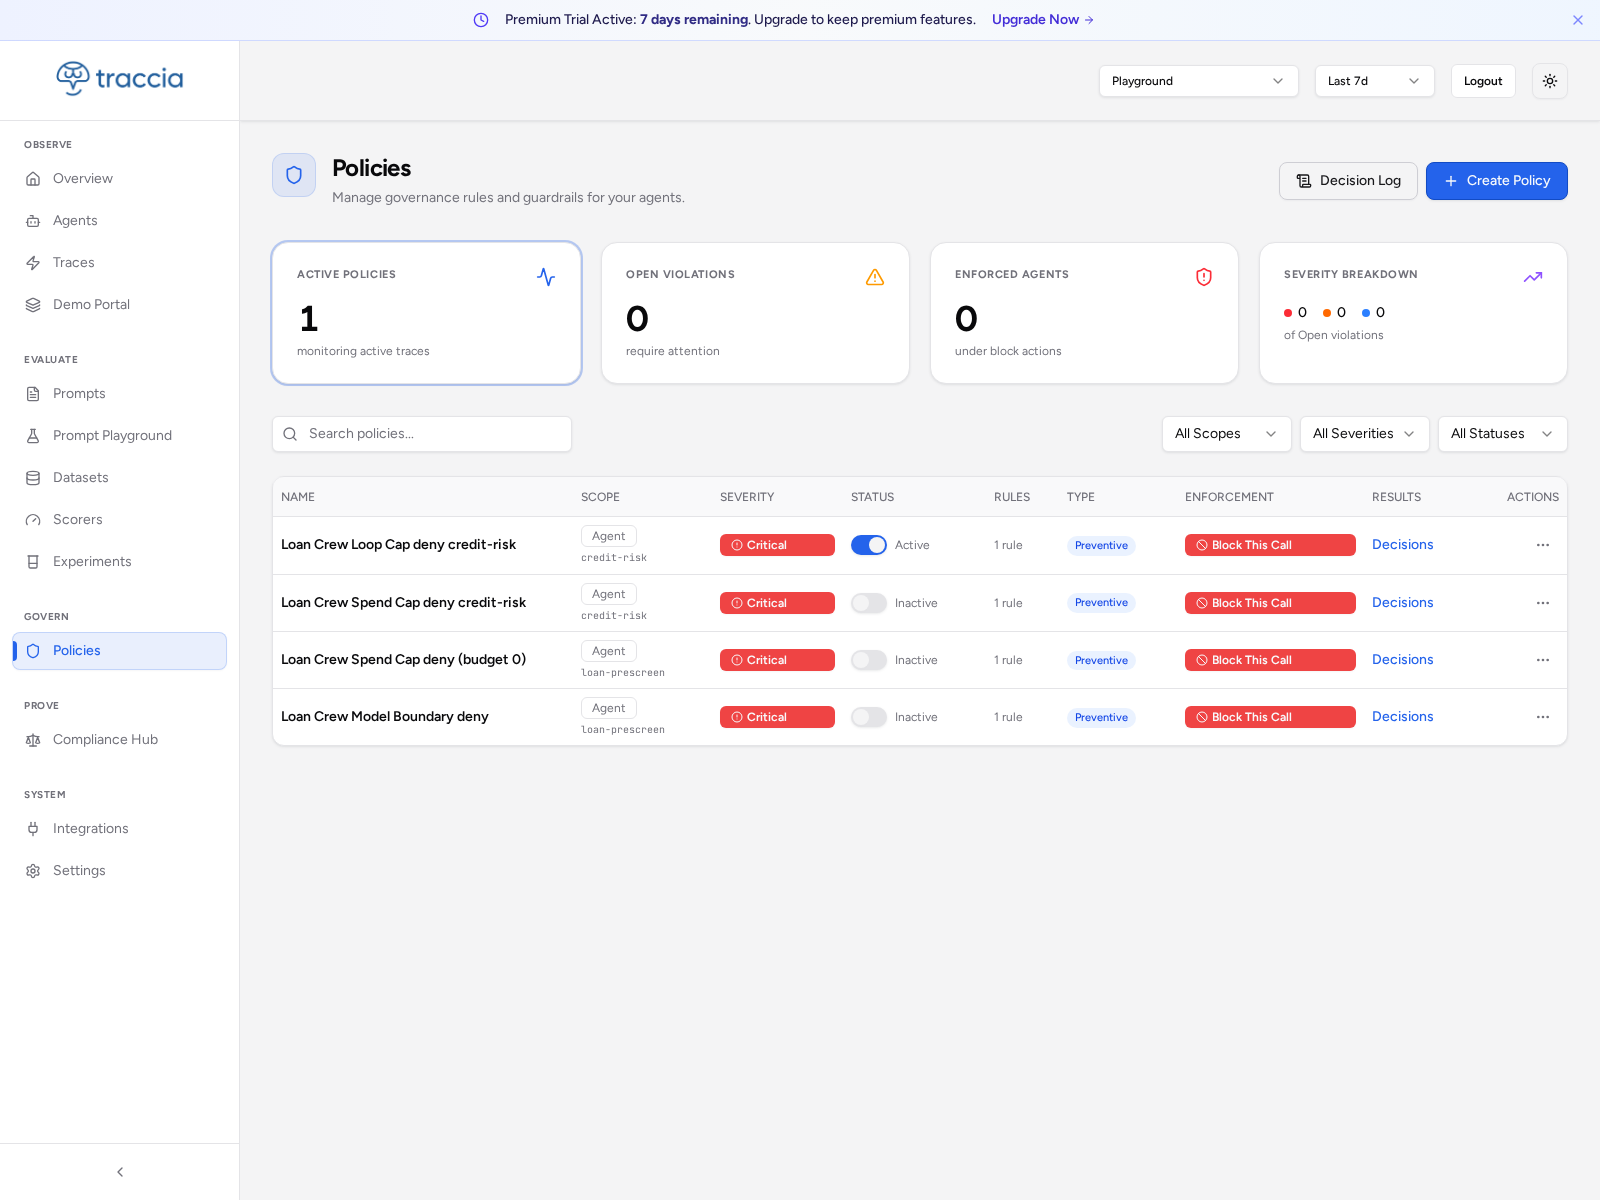
啟用中的 Loop Cap:Max Tool Calls Per Run = 1,範圍套用到 credit-risk,執行方式為 Block。這是這個團隊中三種政策類型裡,唯一一種其訊號真的存在於 span 裡的政策。
這是一個真的、網路化的拒絕,帶有原因與決策 id(id 每次執行都會更新)。我也從 SDK 原始碼驗證了一個細節:這些有內容的欄位(reasons、真正的 decision_id)來自每次呼叫的拒絕路徑。若是來自延遲狀態檢查的阻擋,會丟出一個空白的 AgentBlockedError,沒有 reasons,也沒有 id。所以,當一個阻擋顯示出真實原因字串與決策 id,就代表是每次呼叫的政策引擎拒絕了它,而不是驗證失敗或狀態斷路器觸發。remaining_budget_usd 會是 None,因為這是 loop 路徑,不是 spend 路徑(只有 Spend Cap 的拒絕才會填這個欄位)。
這不是「Loop Cap 好,另外兩個差」的案例。執行期強制執行取決於模型呼叫在哪裡對治理平面可見,以及哪個 Agent 身分承載了那次呼叫。對於一個工具呼叫很多、LLM 成本幾乎為零的 Strands 團隊來說,Loop Cap 才是那個其訊號真的存在於 span 中的政策類型。Decision Log 的「N span checks、No Match 與 Denied」一次告訴你這兩件事,這也是我整個過程都把它開著的原因。
一路上我也修了兩個真實 bug,而且都已提交:團隊入口點原本把整句提示當成 applicant_id 傳下去(導致 KeyError),平台初始化則只傳了金鑰,沒傳 endpoint。這些都不稀奇;但只有真的對著平台跑,才抓得出來。
監管機關會要求的證據
一旦真的有了阻擋,Governance Hub 就會把它變成文件。根據那個被阻擋的單一 trace,我完成了註冊、審查、記錄與匯出。
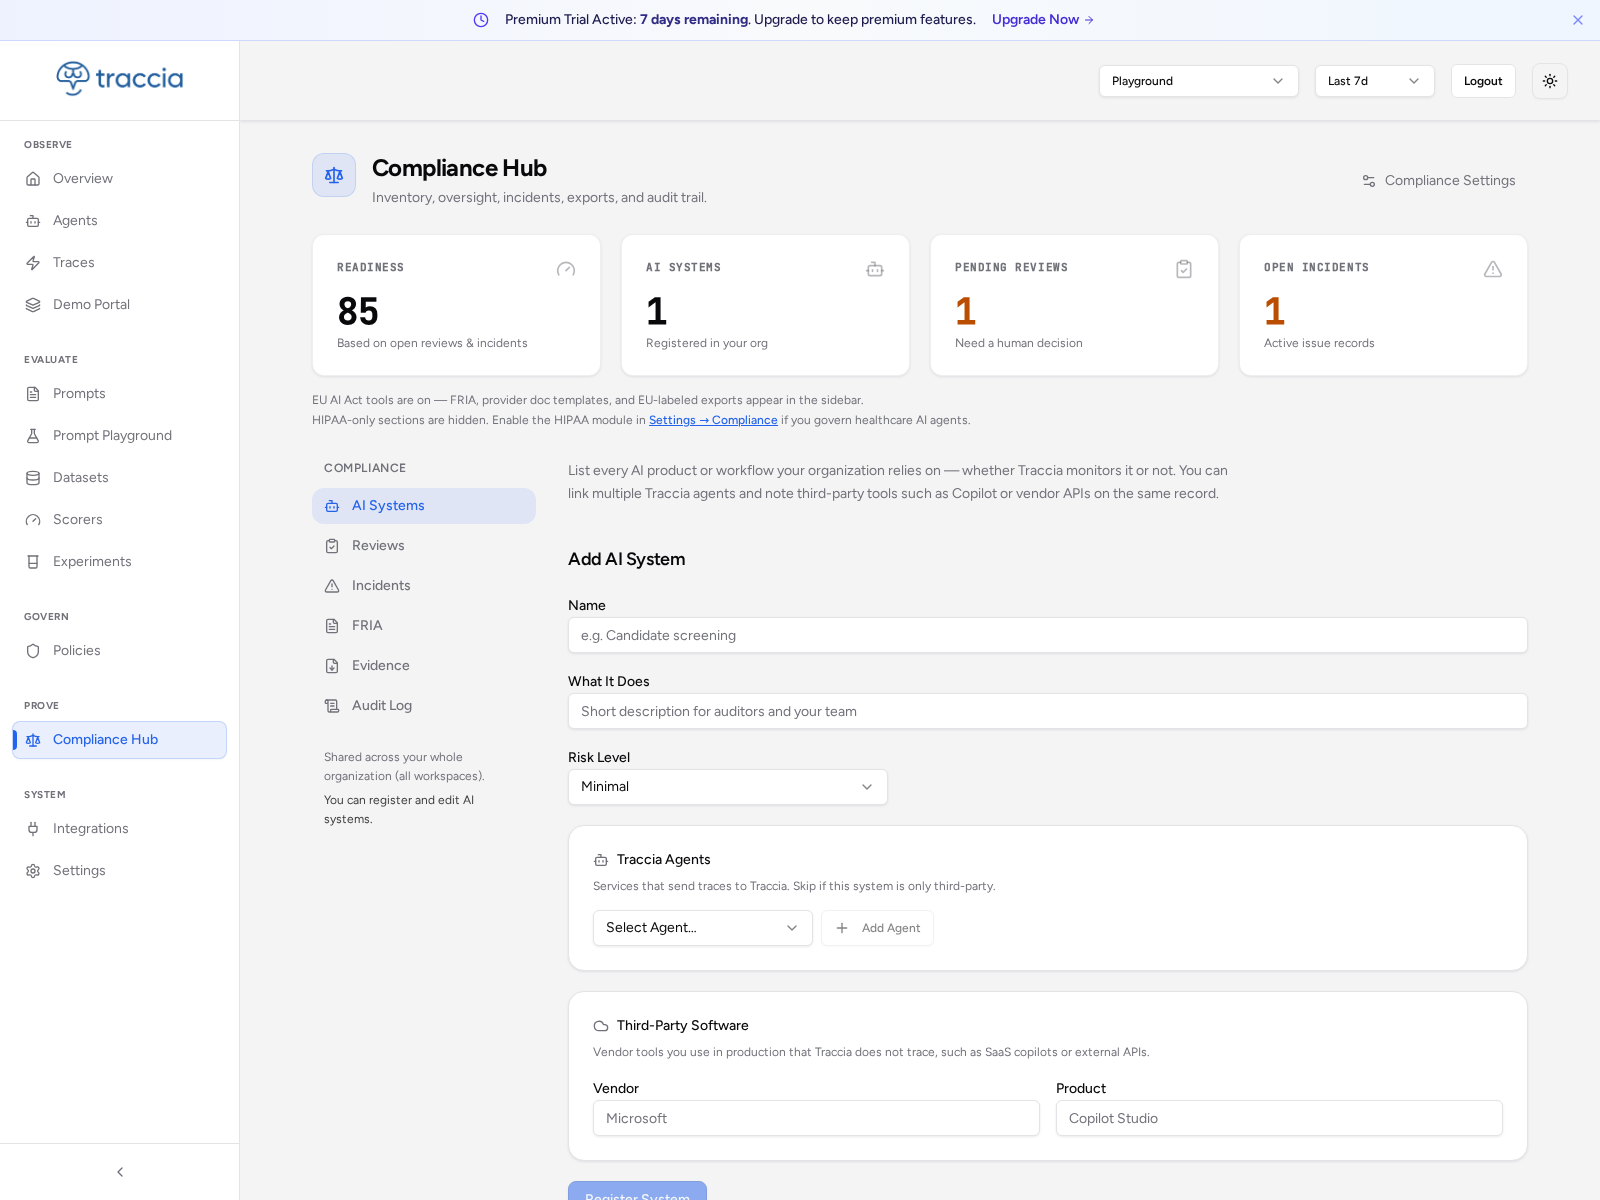
執行後的 Compliance Hub:Readiness 85、1 個已註冊 AI System、1 個待審查專案、1 個開啟中的 incident。這些都是真實且非零,且每一個都能追溯回那一次單一被阻擋的執行。
我從那個被阻擋的 trace 建出監管機關期待的紙本軌跡。我把團隊註冊成高風險 AI System(第 12 條紀錄保存),風險等級 High,連結三個 Agent,並標示一個附錄 III 5(b) 的預定用途,讓系統登錄從 0 變成 1。我針對那個被阻擋的 trace 提出人為審查請求(第 14 條人為監督),Reviews 分頁變成 Pending 1。我也記錄了一起 incident(第 72 與 73 條)──「Loop Cap block:credit-risk 超過工具呼叫上限(2 > 1)」──內容帶有決策 id 與 trace,Incidents 分頁因此變成 Open 1。最後我匯出了一個稽核包(第 12 條 / 附錄 VIII),這就是成果物:一個雜湊封存的 JSON,大約 10 KB,把所有事情串在一起。
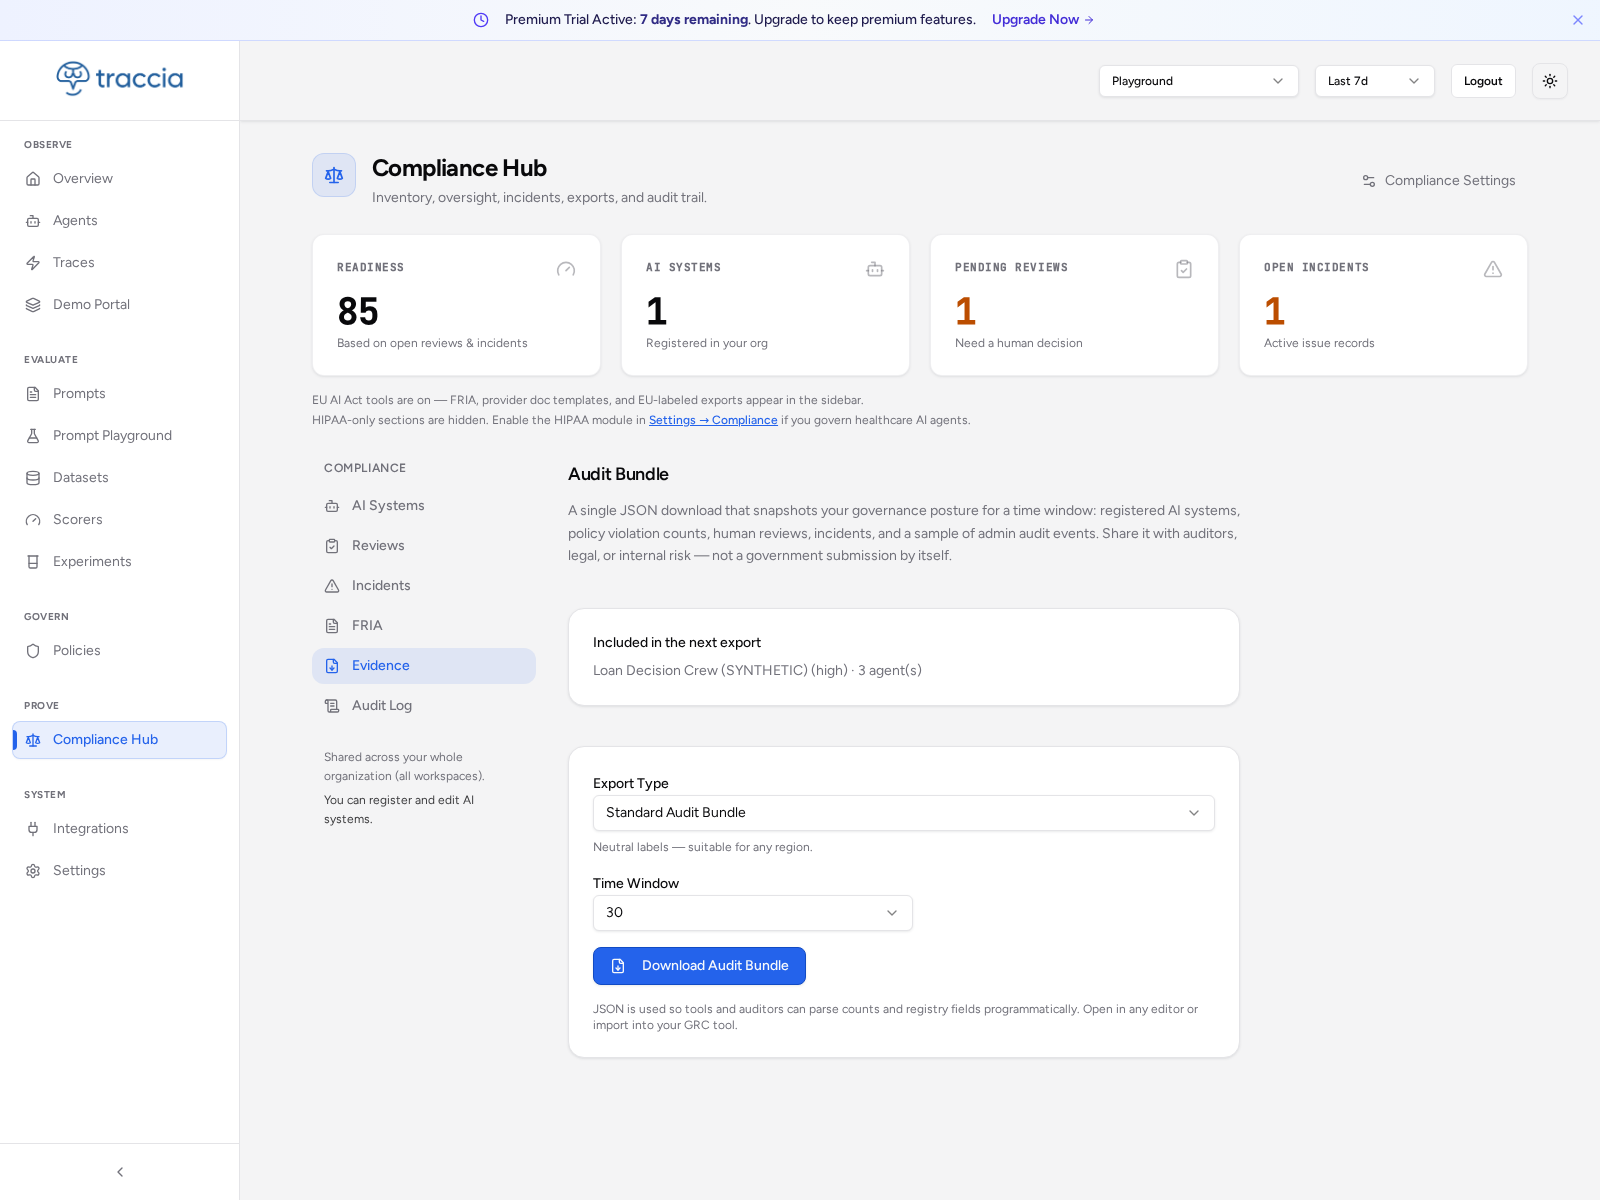
稽核包是一個雜湊封存的 JSON,快照了已註冊系統、政策決策、人為審查、incident 與管理稽核軌跡。已驗證內容:High-risk 系統與三個已連結 Agent、review_requests_count 1(裡面包含被阻擋的 trace id)、incidents_count 1、audit_events_count 110,以及最上層的 integrity_hash。
在設定裡打開 EU AI Act 模組後,又解鎖了 EU 特有的產出:一份 FRIA 草稿(第 27 條)、使用說明(第 13 條)、附錄 IV 技術文件大綱,以及 EU 註冊預填(附錄 VIII)。每一項都是真實匯出,並且綁定到已註冊的系統。
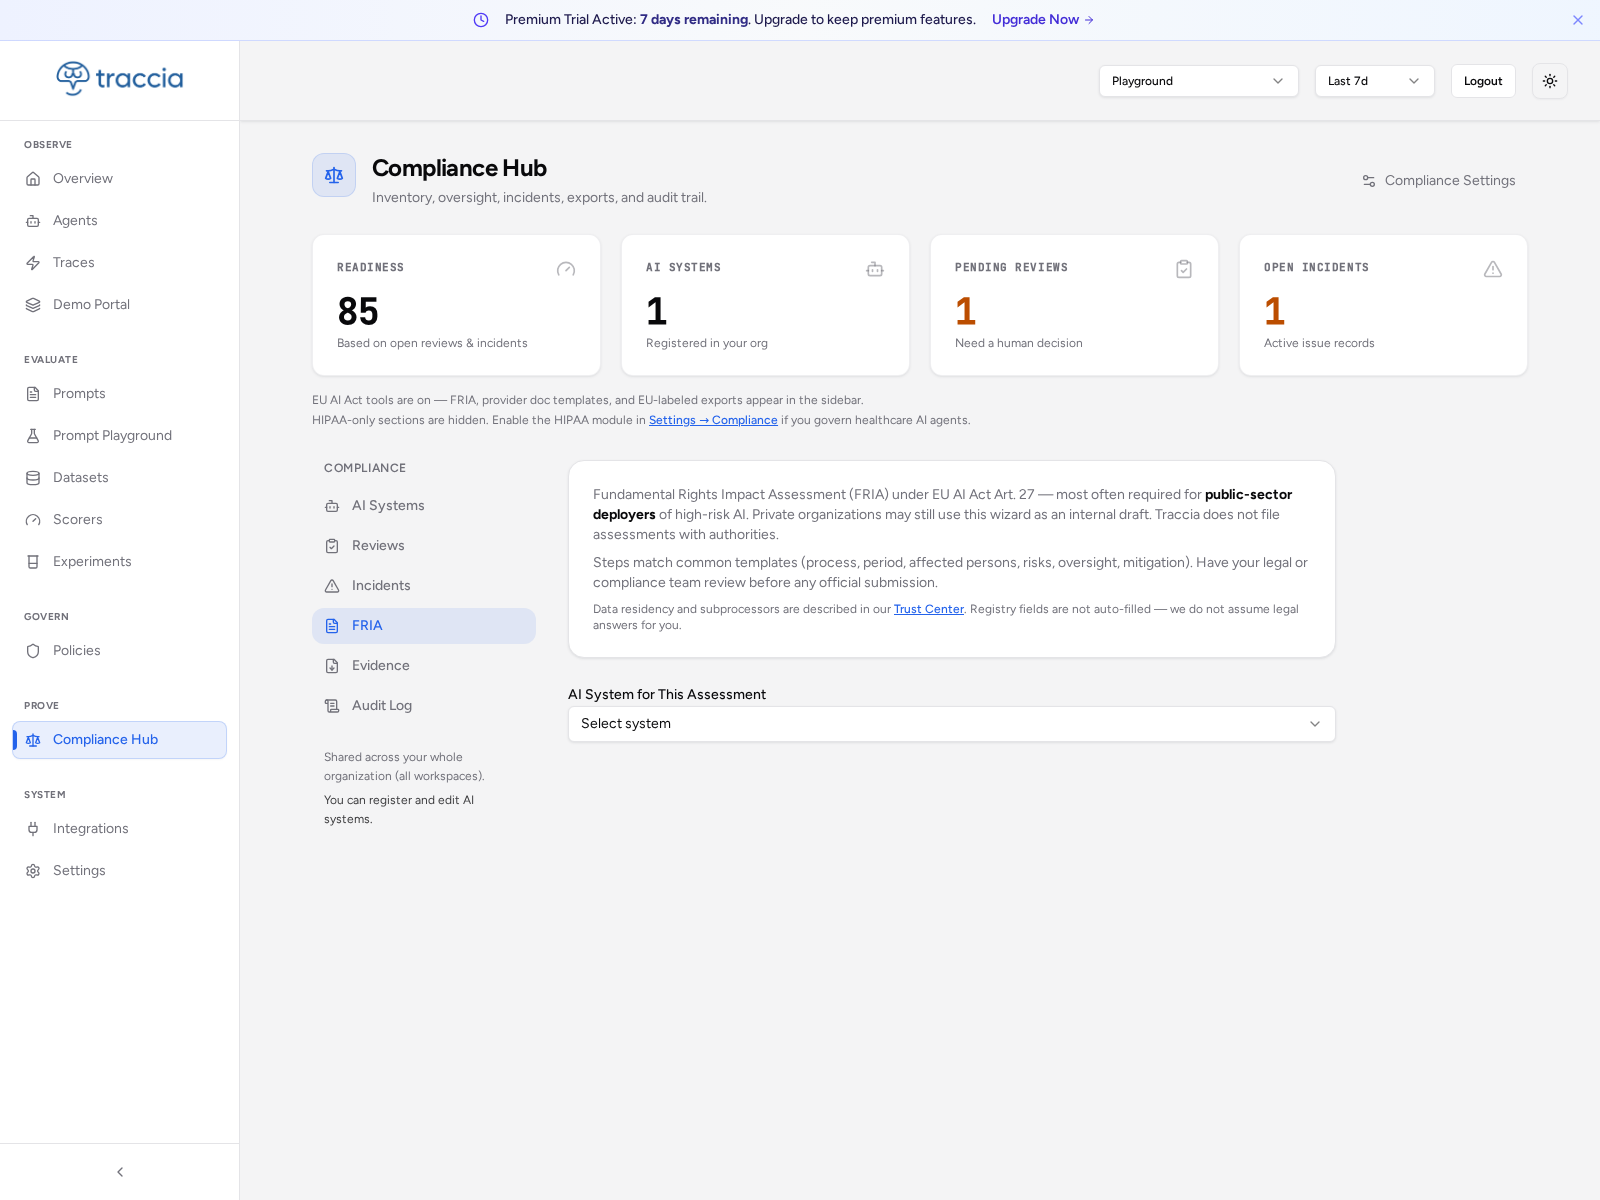
FRIA 精靈(第 27 條)綁定到已註冊的高風險系統。它會匯出一份草稿 JSON,內含真實的 ai_system_id 與完成百分比,這也是高風險系統部署者預期要產出的另一項證據。
再說一次誠實的限制,因為誇大其詞的治理工具比沒有還糟:
@govern預設是fail_open=True。如果平台無法連線,執行就會繼續。我把高風險團隊設成fail_open=False,但那只會加強執行前的狀態檢查。每次呼叫的政策檢查永遠是 fail-open,沒有覆寫選項,所以如果執行途中網路中斷,那一次呼叫就會通過。畫面上的阻擋是真實的每次呼叫拒絕,但不能保證平台永遠不會漏掉一次呼叫。integrity_hash只是未加密鑰的 SHA-256。它是防竄改證據,不是簽章。任何能重寫 bundle 的人,都能重新計算雜湊。- EU 註冊匯出只是預填,而且它也明講了:
annex_iii_category會回傳 null,因為 registry 欄位不會從 SDK 的 span 蓋章自動填入,而匯出也帶有明確聲明:Traccia 不是官方 EU 登錄系統。 - 證據基礎層不等於法律合規。 律師或 notified body 仍然要判定符合性。這裡做的是產出記錄;不是代替你簽核。
即時強制執行 vs 排程式偵測
儀表板上有一件事曾讓我困惑,值得花 30 秒講一下,因為它看起來像 bug,但其實不是。Policies 頁面顯示「Open Violations 0」,但我明明有真實阻擋。原因是 Traccia 有兩類政策,會顯示在不同地方:
- 預防型(每次呼叫) 政策(Loop Cap、Spend Cap、Model Boundary)會在即時、每次呼叫前執行,並立即在 Decision Log 中顯示為「Denied」(再加上
AgentBlockedError)。我的阻擋就是這一類。 - 偵測型(監控) 政策(Output Token Limit、Cost Spike Alert)會在執行後,依照排程評估(最短每小時一次),並反映到 Open Violations 小卡。
所以「Open Violations 0」旁邊同時有 Denied 列是正確的:阻擋是即時的預防型拒絕,而偵測型違規要等下一個排程 tick 才會開啟。我另外加了一條偵測型的 Output Token Limit 政策來示範第二條路徑,而在每小時評估後,Open Violations 變成 1。給任何要實作這種系統的人一個教訓:不要在畫面前(或示範時)等每小時的 tick,也要把這個差別講清楚。即時阻擋看 Decision Log;排程偵測看違規小卡。
為了完整交代即時數字,在團隊跑了幾十次之後,已註冊的 Agent 顯示如下。
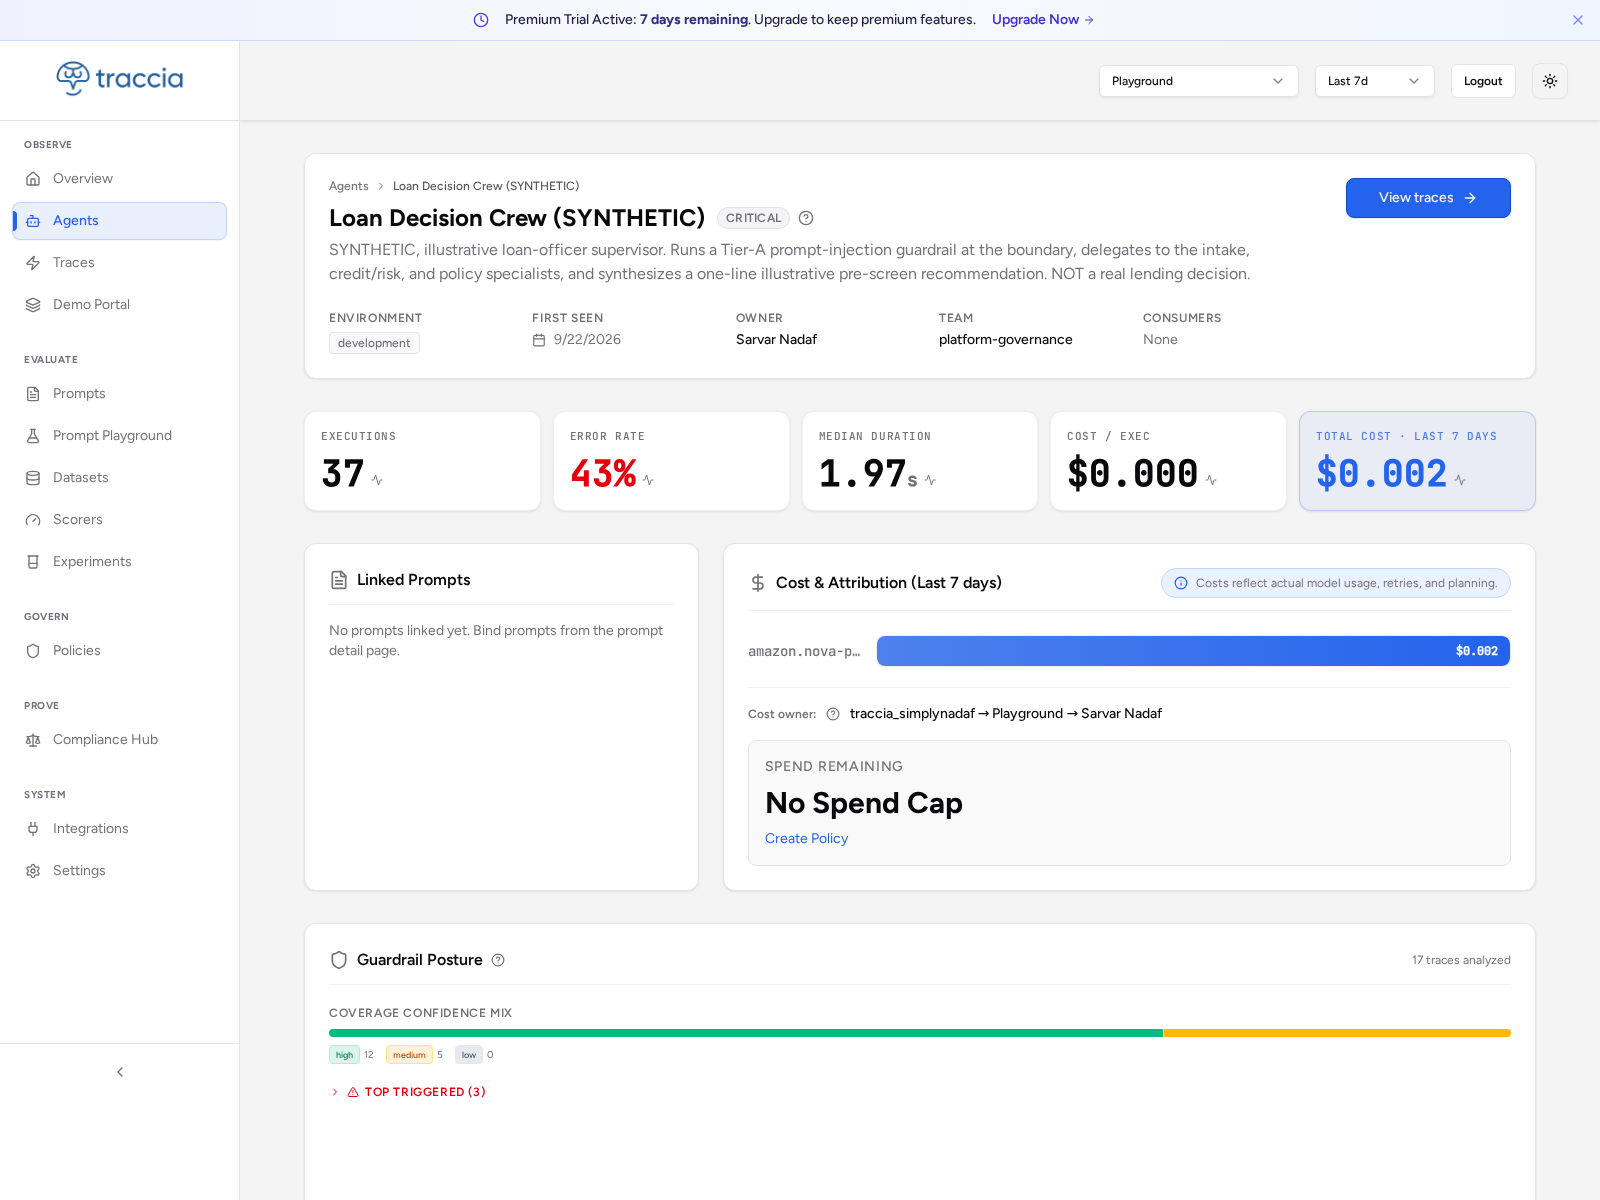
團隊的每個 Agent 成本與姿態:37 次執行、43% 錯誤率,以及約 $0.002 的 7 天成本。錯誤率刻意設得高,因為每次示範都包含一次刻意的注入嘗試,而每一次 @govern 拒絕都會依設計 raise 錯誤。這裡的高錯誤率代表護欄生效,不是缺陷。
37 次執行與接近零的成本都是真實的,不是刻意限流或修飾過的:每次執行都只是 Nova Pro 的短序列呼叫,而我沒有為了好看而偽造其中任何數字。43% 的錯誤率也同樣看待:那是護欄與拒絕在做它們該做的事,不是可靠性問題。
現在做這件事的時機為什麼剛好
第 50 條的透明度義務已於 2026 年 8 月 2 日開始可執行。附錄 III 中針對信用評分的高風險義務則會於 2027 年 12 月 2 日適用。這是一段準備期,不是免死金牌;而且在期限前先建立證據層,成本遠比事後補做低。(請在你發文當天自行再次確認日期;法規時程會變,而會推動這些日期變動的綜合法修法,正是最需要核對的那一類。)
我對 Traccia 治理的誠實看法
我真的把一個團隊部署上去,還讀了 SDK 原始碼來理解行為,所以這裡是根據這些經驗得出的評估:哪些地方值得,以及哪些地方讓我花了一個下午。
先說最值得的地方。兩層分離確實做出了實質工作,而且是 $0:你能在本機得到真正的治理(阻擋、遮罩、蓋章),不需要金鑰,而金鑰則帶來網路化強制執行與審計中心。免費層不是 demo 用的試看版;它不用帳號就能做真正的工作。Decision Log 是這個產品最好的診斷工具。「N span checks、No Match 與 Denied、歸屬於 Agent X」這些資訊,同時告訴我政策為什麼失敗,以及該怎麼修正,沒有它,上面那兩個教訓我會花更久才弄懂。證據中心也和真正的 EU AI Act 條文對得很漂亮:登錄、審查、incident、證據包、FRIA,以及 EU 匯出,對應到第 12、13、14、27、72/73 條與附錄 IV、VIII;對於需要「拿得出東西」的團隊來說,價值很高。而且它在匯出裡也沒有過度吹捧自己;那些聲明(「不是官方登錄」、「未加密鑰雜湊」)是直接做進產品輸出裡的,不只是我在這篇文章裡額外加的註解。
接下來是讓我得自己摸索、而且確實應該改進的地方:
- endpoint 需求是靜默的。
@govern在沒有 endpoint 時會跳過強制執行(以我寫作時的版本來說)。只設金鑰會得到 ALLOWED,而且還會附上一行很多人會錯過的 log。若能直接報錯,或至少警告更大聲一點,會少掉很多混亂。 - 永遠 fail-open 的每次呼叫檢查,應該更明確寫出來。
fail_open=False看起來像是「這一定會擋」,但它其實只加強狀態檢查;每次呼叫的引擎仍然是 fail-open。這種設計是可以辯護的(網路抖動不應該讓正式生產呼叫整個失敗),但對高風險部署者來說,這正是應該在前面講清楚的細節。 - 每次呼叫的身分歸屬,對多 Agent 團隊來說是真正的坑。 檢查是跑在子 Agent 的
run_identity上,不是@govern入口點,這個行為本身是正確的,但對這個案例來說文件沒有寫,而且這正是多 Agent 建置最先出錯的地方。 - 真正的缺口是文件,和第一篇一樣。我是透過實際跑平台與讀原始碼,才知道身分優先序、endpoint 要求、每次呼叫永遠 fail-open 的規則,以及政策匹配邏輯,而不是從文件裡學到。能力是有的;但給多 Agent Strands 建置者的指引,還沒完整寫下來,而這篇文章正是在補那個缺口。
總結:治理是真實的,而證據結構也確實有用。缺口在文件,以及幾個開發體驗上的小傷口;我不會把它們全都當成產品早期成長陣痛就帶過。對一個價值完全建立在可信審計證據上的工具來說,發佈一個會永遠 fail-open、而且還沒寫明白的每次呼叫行為,已經不只是美觀問題;高風險部署者需要的是被直接揭露,而不是自己慢慢發現。能力在那裡,而且真的能用。但指引和一些預設值,還沒追上它。
誠實的限制
- 這個貸款團隊是合成的。信用模型是模擬、申請人是虛構、輸出不是任何真實決策。這產出的是證據,不是合規。
- 本機阻擋與 PII 遮罩會在有無金鑰的情況下都於 in-process 執行。金鑰新增的是網路化強制執行與 hub,不是本機護欄。
- Traccia 的 guardrail 會偵測;不會強制執行。Beat 1 的阻擋是我自己的控制流程在 finding 上 raise。
- PII 遮罩是盡力而為的 regex,不是 ML NER。名字與地址可能漏掉,也可能過度遮罩。
integrity_hash是未加密鑰的 SHA-256:它是防竄改證據,不是簽章。@govern預設fail_open=True;而且每次呼叫的檢查永遠是 fail-open,即使你設了fail_open=False也是如此。- 我示範的是護欄層級 A 與 C;B 是 provider-native,而且在乾淨執行時不會觸發。不要宣稱三層全都觸發。
- 每一筆美元與 token 數都是真實的,但每次執行會變動。請把這些關係(團隊會呼叫兩次工具;Loop Cap 設成 1 會擋住它)當作重點,而不是精確小數。
- 真正有效的阻擋是套用在
credit-risk的 Loop Cap,不是 Model Boundary 或 Spend Cap,原因就在前面的平台收穫段落。你的政策選擇取決於你的 span 實際承載了什麼。
重點不是「去買治理工具」。重點是:看見一次失敗,和阻止一次失敗,是不同的層;在多 Agent 團隊裡,強制執行必須針對真正發出呼叫的 Agent;而審計證據是你要在監管機關來問之前,刻意產生出來的東西。
FAQ
什麼是 AI Agent 治理?它和觀測性有什麼不同?
觀測性記錄 Agent 做了什麼、花了多少錢。治理決定 Agent 能不能做這件事(護欄與執行期政策),並產生可持久保存的審計記錄。觀測性負責看;治理負責阻擋與證明。
我能在不付費的平台下阻擋失控的 Agent 嗎?
你可以用 in-process 的護欄在本機阻擋,而且會 raise(這裡的注入阻擋就是 $0、不要金鑰)。需要平台的是網路化強制執行:由平台在每次呼叫都評估的 Loop Cap、Spend Cap 或 Model Boundary,並拒絕且附上可引用的決策 id。
為什麼我的 @govern 政策沒有擋住任何東西?
通常有三個原因,而我三個都遇過。你沒有設定 TRACCIA_ENDPOINT,所以 SDK 靜默跳過強制執行。你把政策套在 @govern 的入口點 Agent 上,但在 Strands 團隊裡,每次呼叫的檢查是歸屬於子 Agent 的 run_identity。或者你選了某種政策類型,但你的 span 裡根本沒有那種訊號(例如在幾乎零成本的團隊上用 Spend Cap,或在不會自動 patch 的 client 上用 Model Boundary)。打開 Decision Log 看看;「No Match 與 Denied」會告訴你是哪一種。
這和 EU AI Act 怎麼對應?
信用評分是附錄 III 第 5(b) 項,高風險。這個示範會產生紀錄保存(第 12 條)、對部署者的透明度(第 13 條)與對使用者的透明度(第 50 條)、人為監督(第 14 條)、事故記錄(第 72/73 條)、FRIA 草稿(第 27 條),以及附錄 IV / VIII 的匯出。它是證據基礎層,不是合規簽核。
Traccia 是開源的嗎?
SDK(traccia-py)是 Apache-2.0 且原生支援 OpenTelemetry,所以 span 是標準 OTel,而本機治理不需要帳號。@govern 的強制執行與 Governance Hub 則是託管的商業部分。
這個可以開箱直接用在 Strands 上嗎?
$0 的 SDK 治理(阻擋、遮罩、蓋章)可用在任何你能裝飾的程式碼上。平台的 @govern 也可用,但每次呼叫的政策匹配在多 Agent 身分上有上面的細節:要套在真正發出呼叫的子 Agent 上,而對工具很多的團隊則要選 Loop Cap。
試試看
想先看它實際運作嗎?完整教學在 YouTube:觀看示範。
完整程式碼(團隊、三個 $0 實作、平台 @govern 腳本、10 個單元測試與 Makefile)都在 GitHub:ai-agent-governance-aws。把它 clone 下來,跑 make demo 看本機阻擋、遮罩與 EU AI Act 蓋章如何在 $0 下運作,然後把 Traccia 金鑰放進 .env、加入 endpoint,再跑 make platform,就能得到真正的 AgentBlockedError。
如果你在 production 跑 Agent:你是在請求路徑上真的有阻擋,還是只在錢(或錯誤決策)已經流失之後才發警報?整篇文章談的就是這個差別。
想看更多 AWS 架構、DevOps 與 AI Infrastructure,歡迎追蹤我:
作品集 | LinkedIn | Dev.to | YouTube | Email | AWS Builder Center | X
原文出處:https://dev.to/aws-builders/ai-agent-governance-on-aws-block-agents-prove-eu-ai-act-compliance-1829
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

