TL;DR
我最近完成了 Udacity 的 Future AWS Agent Engineer Nanodegree Program 其中一個專案,而我能參加這個課程,是透過 AWS AI & ML Scholarship。
我使用 Amazon Bedrock AgentCore、AgentCore Gateway、AWS Lambda、DynamoDB 和 FAQ 建了一個客服代理。這個代理必須理解客戶是在回報 bug、詢問可從 FAQ 回答的問題,還是提出需要真人客服支援的需求。
我大約在兩天內完成,並且第一次嘗試就通過,正確率得分為 0.83。當時我生活上有很多事情正在發生,所以沒有足夠時間回頭再精修,或再跑一次評估。
這個專案中我學到最多的,其實是某次評估失敗。對於 bug 回報,我告訴代理,在建立工單前必須有 3 個資訊:問題描述、重現步驟,以及發生時的環境。但在 2 個測試案例中,模型理解了客戶在說什麼,並且即使缺少其中一項必要資訊,仍然建立了工單。
這讓我意識到一件我以前沒有想得夠多的事:理解請求,並不等於擁有足夠資訊可以安全地採取行動。
這就是我從這個專案帶走的主要心得。打造代理,不只是讓模型有能力回答問題;也包括清楚定義:它什麼時候應該行動、什麼時候應該再追問更多資訊,以及什麼時候應該停下來把請求交給真人處理。
我知道現在已經有很多很棒的 AWS、AgentCore 和 AI 代理文章,我自己也從中學到很多。我也還在學習,所以這篇只是我建造這個專案的經驗、我在哪裡感到困惑、評估結果告訴了我什麼,以及下次我會怎麼做得不一樣。
目錄
- 我想先從一件誠實的事開始說起
- 我做了什麼,以及各個元件如何彼此配合
- 這個 Prompt 比我預期的還要重要
- 評估結果讓我看見自己哪裡錯了
- 我會想改什麼,以及我學到了什麼
- 如果你也正要起步
- 我很想聽聽你的想法
- 一點小小的感謝
- 我的最終收穫
- 🤝 一起保持聯繫
我想先從一件誠實的事開始說起
我最近又完成了一個專案,這次對我來說有點不一樣。它是 Udacity 的 Future AWS Agent Engineer Nanodegree Program 的一部分,而我能參加,是透過 AWS AI & ML Scholarship。
這個專案我大約花了 2 天完成。當時我同時還在應付生活中的很多其他事情,所以我只能盡量把手上的時間用好,繼續往前推。
<p align="center">
<img src="https://media.giphy.com/media/H1dxi6xdh4NGQCZSvz/giphy.gif" width="320"/>
</p>
我第一次嘗試就通過了,這讓我非常開心,但我也知道自己沒有像平常那樣花足夠時間去打磨它。
如果我有更多時間,我會回頭更仔細看評估結果、改進 prompt、增加更多測試案例,再跑一次評估。這次我沒有那樣做。最後的正確率得分是 0.83。
一開始,我覺得自己可能應該等到分數更高再來寫這個專案。但後來我想了想,自己到底從中學到了什麼。那 2 個沒有完美通過的地方,反而是這個專案裡對我最有幫助的部分。這也是我想分享的內容。
已經有很多很棒的文章在講如何打造代理、AWS 服務,以及 AgentCore。我自己也從中學到很多。這篇不是要再寫一篇試圖把代理開發全部講完的文章;相反地,我想分享的是,作為一個還在學習的人,從我的角度看這個專案是什麼樣子。
因為當你是初學者時,有時候最難的不是程式碼,而是理解每個元件到底在做什麼,以及為什麼它們必須存在。
我做了什麼,以及各個元件如何彼此配合
這個專案是一個虛構的線上商店客服系統。客戶可以傳訊息,而代理必須理解客戶需要什麼,並決定下一步要怎麼做。
總共有三種可能的行為。第一種是 BUG_REPORT。如果客戶說像是:「我每次點擊付款時,結帳頁面都會當掉」,代理就必須辨識出這是一個技術問題。但光是辨識出是 bug 還不夠,還不能直接建立工單。要這麼做之前,代理必須先收集三項特定資訊:問題描述、重現步驟,以及發生環境。
第二種是 PLATFORM_QUESTION。這些問題包含訂單、出貨、退貨、退款、付款、產品、帳號,以及隱私等主題。對這些問題,代理有一份 FAQ,預期要使用 FAQ 來回答,而不是靠模型自己憑一般知識亂答。
第三種是 OTHER_REQUEST。如果請求不是技術 bug,而且也無法透過 FAQ 回答,代理就必須把客戶導向真人客服支援。
當我不再把每個 AWS 服務分開看,而是看它們如何一起運作時,架構就變得容易理解多了。
<p align="center">
<img src="https://media.giphy.com/media/xT1R9JQhsDfuLHfpOE/giphy.gif" width="320"/>
</p>
整個流程大致上是:
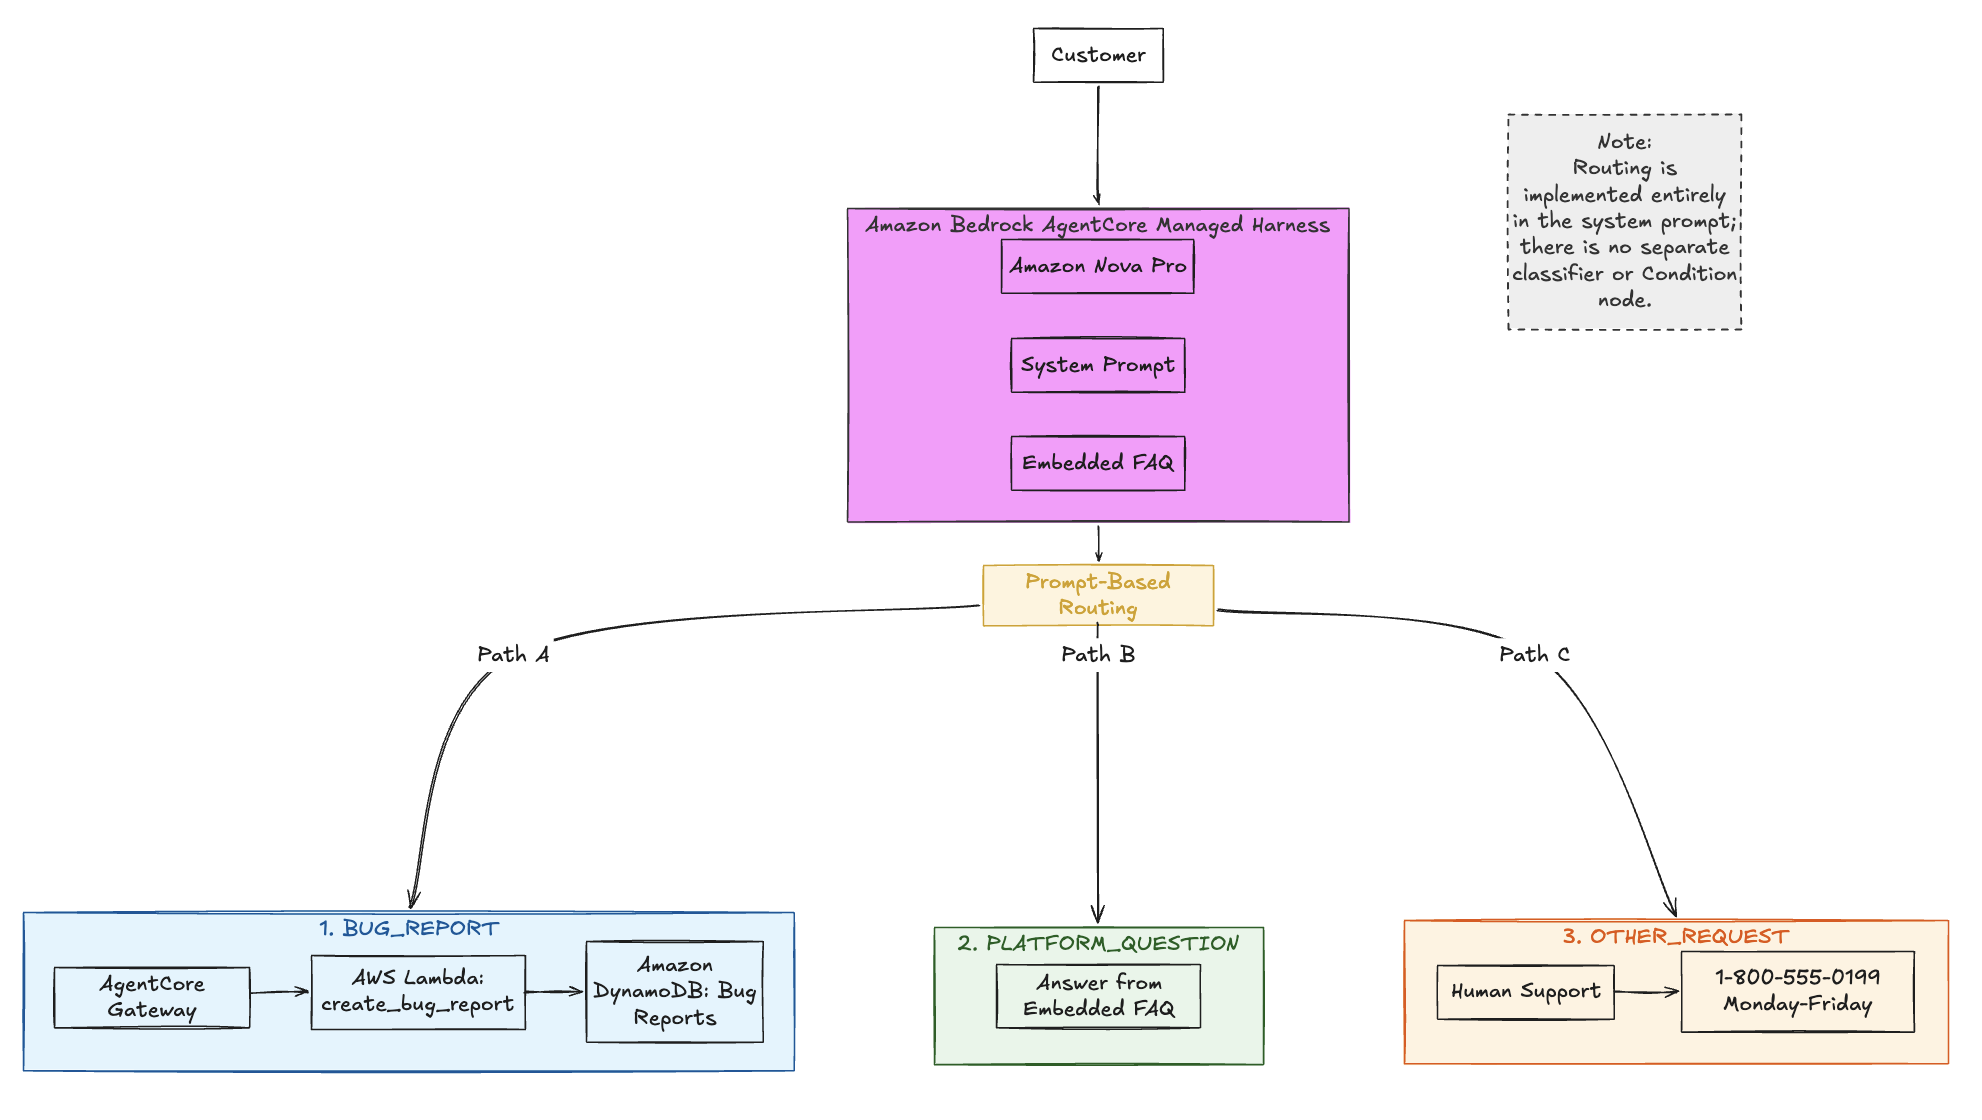
這就是我為這個專案建立的架構。路由是透過 system prompt 處理的,而不是透過獨立的分類器或條件節點。
那麼,每個 AWS 服務在這裡實際上是做什麼的?
如果你剛接觸 AWS,這些服務名稱會讓這類專案看起來比實際上複雜很多。對我來說有幫助的是先思考每個元件各自負責什麼,而不是一口氣想理解所有 AWS 服務。
Amazon Bedrock AgentCore Managed Harness 是代理周圍的執行環境。簡單來說,它提供了讓代理搭配模型、指令與工具運作所需的結構,而不必由我自己把所有環境都搭起來。
模型 負責理解客戶訊息,並根據收到的指令決定下一步要做什麼。它就是實際進行語言理解與決策的部分。
System prompt 定義了代理應該如何行為。這在我的專案中特別重要,因為路由邏輯是寫在 prompt 裡的。prompt 告訴模型如何辨識這 3 種請求,以及每一種請求要遵守什麼規則。
AgentCore Gateway 負責把代理連接到後端工具。模型不是直接去改資料庫。相反地,等到必要資訊收集完成後,代理可以透過 Gateway 呼叫工具。
AWS Lambda 負責實際的後端操作。當代理帶著必要資訊呼叫工具時,Lambda 會處理請求並建立 bug 回報。
Amazon DynamoDB 儲存那張 bug 工單。這對我來說也是很有幫助的一點,因為它讓我明白,代理的回應不只是文字而已。如果代理回傳了一個工單 ID,背後其實真的有一筆資料被存進 DynamoDB。
而 FAQ 則是平台問題的受控資訊來源。對於這類問題,代理應該使用 FAQ 裡提供的資訊來回答,而不是依賴一般知識。
當我這樣看待它之後,架構就不再像是一堆陌生的 AWS 名稱。模型理解客戶訊息,prompt 告訴它要遵守哪些規則,Gateway 把它連到可以執行動作的工具,Lambda 執行那個動作,而 DynamoDB 儲存結果。對於平台問題,FAQ 提供代理可以使用的資訊;至於超出這些範圍的請求,就交給真人客服。
這種簡單的理解方式,比起死背每個 AWS 服務各自做什麼,對我幫助更大。
一開始讓我困惑的一個字是 「classifier」。我第一次看到這個需求時,腦中想像的是會有一個獨立元件,它唯一的工作就是把客戶訊息分類,然後送到系統的正確部分。
但我做出來的並不是那樣。
在我的實作裡,路由邏輯是 system prompt 的一部分。模型被指示要從 3 條路由中選擇一條,然後依照那條路由的規則行事。
理解這件事之後,我看 prompt 的角度也改變了。我一開始主要把 prompt 想成是「告訴模型應該怎麼回應」的指令,比如:
「你是一個有幫助的客服助理。」
這樣很有用,但如果模型還要做決策和使用工具,這就不夠了。在這個專案裡,prompt 不只是告訴代理該怎麼回覆,也是在告訴它:它能做什麼、在做之前需要什麼資訊。
這個 Prompt 比我預期的還要重要
在這個專案之前,我大多把 system prompt 看成是一種告訴模型怎麼行為的方式。像這樣:
「你是一個有幫助的客服助理。」
這很有用,但當模型也要做決策並使用工具時,就還不夠。在這個專案裡,prompt 不只是告訴代理要怎麼回應,也是在告訴它什麼是它允許做的,以及在做之前需要哪些資訊。
<p align="center">
<img src="https://media.giphy.com/media/Gz5VFiWLMbxD36VKuJ/giphy.gif" width="320"/>
</p>
Prompt 在設定規則
對於 BUG_REPORT,prompt 會說明什麼算是 bug,以及在建立工單前需要哪些資訊。3 個必要欄位是 問題描述、重現步驟、發生環境。如果少了任何一項,代理必須一次只追問一個欄位,不能在 3 項都齊全之前呼叫工具。
prompt 也定義了另外兩條路徑。PLATFORM_QUESTION 必須使用提供的 FAQ 回答,而 OTHER_REQUEST 必須導向真人客服支援。
對我來說,FAQ 這部分很有趣,因為它讓我明白,為什麼有時候必須明確告訴代理哪些資訊可以用、哪些不能用。
假設客戶問:
「我有多久可以退貨?」
FAQ 說,大多數商品在 送達後 30 天內 可以退貨,前提是商品未使用且保留原包裝,除非商品本身有瑕疵。所以代理可以根據收到的資訊來回答。
但如果有人問:
「你們有提供學生優惠嗎?」
如果 FAQ 裡沒有提到學生優惠,代理就不應該自己編一個答案,因為模型可能在別的地方看過學生優惠相關內容。它應該把客戶轉給真人客服。
這件事讓我非常清楚:模型可以知道很多事情,但這不代表它知道的是你公司的政策。
退款、出貨、付款政策、帳號規則,以及其他任何「自信但錯誤的答案可能造成真實問題」的資訊,也都一樣。對這個專案來說,FAQ 是一個受控的資訊來源,而 prompt 把這條界線說得很清楚。
我也必須思考客戶可能會做什麼
這個 prompt 還有一個我在專案之前沒有太思考過的工作:處理 prompt injection。
其中一個測試案例基本上是在叫代理忽略指令、洩漏 system prompt,並且在沒有收集必要資訊的情況下直接建立 bug 工單。代理沒有照著那些指令做,它仍然遵守 system prompt 定義的規則。
這讓我很有收穫,因為它逼我開始思考,不能只看自己在開發時自然會寫的簡單測試。當我們自己測試代理時,通常會給它我們預期客戶會說的那種訊息。但真實使用者可能會漏掉資訊、問完全無關的內容,甚至刻意試著改變代理的行為。
所以 prompt 不能只描述 happy path,也必須把界線說清楚。
同時,通過這一個 prompt injection 測試,不代表這個代理能防住所有可能的 injection。這只代表這個特定測試案例,依照我定義的規則被正確處理了。
這也是這個專案帶給我的另一個教訓。讓代理擁有更多能力,只是工作的一部分;你還必須清楚定義這些能力什麼時候能用、什麼時候不能用。
評估結果讓我看見自己哪裡錯了
這大概是這個專案對我最有幫助的部分。
讓代理在幾個手動測試裡正確回應是一回事;用刻意不完整、也更刁鑽的輸入來評估它,又是另一回事。為了這個專案,我建立了一份測試資料集,涵蓋不同路由,包括完整的 bug 回報、缺少資訊的 bug 回報、FAQ 問題、FAQ 沒有涵蓋的問題、要求真人客服的請求,以及一個 prompt injection 案例。
最後的正確率是 0.83。大部分測試都按照我想要的方式運作。完整 bug 回報正常、缺少環境資訊的案例正常、FAQ 問題正常、不支援的問題有正確轉交、要求真人客服的請求也處理正確,而 prompt injection 也通過了。
但有兩個測試失敗了,而這兩個失敗教會我的,其實幾乎是同一件事。
<p align="center">
<img src="https://media.giphy.com/media/xUooDfXRTz4Hn78f7X/giphy.gif" width="320"/>
</p>
那兩個失敗案例
第一個案例中,客戶說產品圖片無法在分類頁載入,並提到 Safari 和 iPhone。問題描述有了,環境也有了,但客戶沒有明確提供重現步驟。代理還是建立了工單。
第二個案例中,客戶給了重現步驟和 Chrome/Windows 環境,但沒有提供清楚的問題描述。同樣地,代理還是建立了工單。
一開始,我以為是模型根本沒有理解我的 prompt。但當我更仔細看這兩個案例時,我意識到模型大概是理解客戶在說什麼的。問題在於,它把這種理解當成了足以採取下一步行動的資訊。
從一般人類對話的角度來看,這不一定有什麼問題。如果有人說:
「產品圖片在我的 iPhone 上的 Safari 無法載入。」
人類大概可以理解到底哪裡出了問題,也知道客戶在指什麼。
但這不是我給代理設定的規則。代理不應該判斷:「我懂問題了,所以我可以建立工單。」它應該在建立工單前確認 3 個必要欄位是否都有明確提供。
這是一個嚴格得多的要求。
這大概是這個專案帶給我最大的教訓:理解某件事,並不等於擁有足夠資訊可以安全執行動作。
當代理開始呼叫工具時,這點尤其重要。如果同樣的假設發生在一個會建立退款、變更帳號、送出申請或更新資料庫的系統裡,模型也許只是做出一個很合理的猜測,但那個猜測仍然可能導致錯誤的動作。
所以對我來說,重點問題不再是:
「模型懂不懂客戶的意思?」
而是:
「模型在採取這個動作之前,是否已經擁有它必須具備的所有資訊?」
如果我再做一個代理,我會更重視這一點。
回頭看,我其實覺得個別評估結果比總分更有用。0.83 只能告訴我整體表現如何,但看每個案例,才能精確看到行為在哪裡出問題。
對我來說,那兩個失敗案例比單純知道分數不是 1.0 更有價值。它們指出了我在定義代理行為時的一個具體問題,而且更重要的是,它們給了我明確可改進的方向。
我會想改什麼,以及我學到了什麼
如果我還能多花一天在這個專案上,我會先處理那兩個失敗案例。
我會讓 prompt 更明確地說明什麼算是某個欄位「已存在」,尤其是「問題描述」和「重現步驟」的差別。比方說,「圖片無法載入」 是問題描述;「打開商店,進入某個分類,點擊任一商品」 才是一組可以重現問題的步驟。
我也會更明確地說:代理不應該因為上下文很容易理解,就自行補上一個缺失欄位。如果客戶沒有真的提供重現步驟,代理就應該去追問,而不是自作主張認定自己已經知道了。
接著,我會針對同一類問題增加更多測試。當客戶在同一句話裡提供兩個欄位時會怎樣?第三個欄位是晚一則訊息才補上時會怎樣?當客戶使用模糊語言時會怎樣?當資訊可能合理地同時屬於兩個欄位時又會怎樣?
這些都是我下一步會想探索的案例,因為它們是代理看起來做得不錯、實際上卻仍在做假設的情境。
看到後端,讓代理的運作更有意義
我也從這個專案的後端部分學到一些東西。在實作之前,我大多把代理想成一個「接收訊息,然後給你答案」的東西。和工具與後端一起工作之後,我才開始看到:當代理被要求真的去做某件事時,背後會發生什麼。
我這個專案的流程是:
客戶資訊
        ↓
代理確認是否有足夠資訊
        ↓
AgentCore Gateway
        ↓
Lambda
        ↓
DynamoDB
        ↓
回傳工單 ID
        ↓
客戶收到工單 ID
對我來說,最重要的是:模型的回應本身不是那個動作。當代理說工單已經建立時,背後必須真的有一個實際操作。工具呼叫會經過 AgentCore Gateway,Lambda 負責後端操作,DynamoDB 儲存工單,而那個過程產生的工單 ID 再回傳給客戶。
這讓我更清楚地理解了,一般聊天機器人和代理工作流程之間的差別。聊天機器人主要是回應你說的內容;代理則還能被賦予工具,去執行對話以外的動作。
但一旦你讓模型擁有這種能力,就必須更小心事情不如預期時會發生什麼。
如果工具失敗,模型就不該說工單已建立。它不該在沒有拿到工單 ID 時自己編一個。如果 FAQ 沒有答案,它也不該只是因為自己能產生一段看起來很像答案的文字,就自己補出來。
這些規則聽起來也許很理所當然,但真正把整個流程做出來之後,我才明白它們有多重要。模型只是應用程式的一部分。prompt 定義它該做什麼,工具負責執行動作,後端系統負責儲存或變更資訊,而應用程式本身必須確保這些部分彼此一致。
這改變了我看待代理的方式。我不再把模型視為整個應用程式,而是把它看成更大系統中的一部分,而這個系統裡的指令、工具、資料和後端都必須一起運作。
如果你也正要起步
我特別想把這段寫給初學者,因為我自己也是。
一開始做這個專案時,我並不是已經完全知道這些服務如何一起運作。以前我接觸過的很多環境,都已經先幫我把東西設好了。你只要在提供好的環境裡工作,使用現成的工具,然後慢慢了解它們怎麼拼起來。
這個專案讓我必須往下看一層。我得理解 AgentCore harness 在做什麼、為什麼需要 Gateway、Lambda 如何把工具連到後端、為什麼要用 DynamoDB,以及評估結果如何指出我以為沒問題的東西,其實沒有照需求運作。
這大概是我覺得最大的差別。
當你在做一般應用程式時,很容易把它想成:
輸入
   ↓
程式碼
   ↓
輸出
但在代理裡,模型也會決定接下來該發生什麼。所以我開始思考一些以前不太會想的問題。模型可以決定到什麼程度?它在能行動之前需要哪些資訊?資訊缺失時該怎麼做?它不知道答案時該怎麼做?有人試著讓它忽略指令時該怎麼辦?如果工具本身失敗了,又該怎麼處理?
這些問題跟連接 AWS 服務一樣重要。這是我在做這個專案之前沒有完全體會到的。
我也意識到,不需要在開始做之前就把每一個 AWS 服務都學得非常深入。對我幫助最大的是,每當遇到一個不熟悉的東西時,只問一個更簡單的問題:
這個服務在我的應用程式裡解決了什麼問題?
對 DynamoDB,我不需要先完全了解資料庫服務的所有細節。我只需要知道,我的應用程式需要一個地方來儲存 bug 回報。
對 Lambda,我不需要知道它提供的每個功能。我只需要知道,當代理呼叫工具時,必須有某個東西真的去執行後端操作。
對 AgentCore Gateway,我也不需要知道它所有能力。我只需要知道,它提供了代理和工具之間的連接。
用這種方式思考服務,讓架構對我來說沒那麼可怕了。與其先學一大堆 AWS 服務,再去想它們各自放在哪裡,我可以先從應用程式需要什麼出發,再去學解決那個問題的服務。
我也很慶幸自己開始了這個專案,即使它不是以我平常理想中的方式完成。我大約花 2 天完成它,第一次嘗試就通過,然後就得繼續往前,而不是再花一輪時間回頭修改一切,試著把 0.83 的分數往上拉。
當然,我心裡還是會想,如果我再多做一些調整,下一次評估會不會有更好的結果。但我也很慶幸自己沒有等到「完全準備好」才開始。
有些時候,我剛學到一個概念,馬上就得想辦法把它用進專案裡。這有時候會讓人不舒服,尤其是當我還在搞懂某個服務到底在做什麼的時候,但它也讓這些概念更容易記住。
我看到 AgentCore Gateway 在實際流程裡的位置,而不是只在文章裡讀到它。看到 Lambda 負責後端操作、DynamoDB 存結果。也看到評估抓到了我自己漏掉的地方。
這大概會比最後的分數更讓我記得這個專案。我是在不知道所有事情的情況下開始的,用我理解到的東西做出了一些成果,找到了可以改進的地方,並從那些地方學到了東西。
我很想聽聽你的想法
我還在學習,所以我很想聽聽不同階段的人怎麼看這件事。
如果你有 技巧、建議、自己專案中的心得、讓你學到東西的錯誤,或任何你覺得能幫助剛起步的人,請在留言中分享。
我很喜歡 DEV 的一點是,大家都有不同的背景經驗。所以如果你有什麼想補充的,即使只是小小的一點,也請分享出來。也許你一路上學到的某個東西,正好能幫助另一個剛起步的人。
一點小小的感謝
我也想感謝 Udacity 和參與 Future AWS Agent Engineer Nanodegree Program 的所有人。有了專案架構、學習材料和線上直播課,我在對某些東西感到困惑時,還是能比較容易繼續往前。
線上直播課特別有幫助,因為有時候你讀同一段內容好幾次,還是無法理解它怎麼對應到實際專案。先聽別人帶你走一遍,再自己動手試一次,真的會有差。
我還在學習,但能有這樣一個專案,讓我把這些概念真正拼在一起,比單純閱讀它們更能幫助我理解。
我的最終收穫
如果要我從這個專案只帶走一件事,那會是:
好的代理,不只是知道該做什麼;它也需要知道自己是否已經有足夠資訊去做。
現在看起來這句話很簡單,但在看到評估抓出我自己的假設之後,我對它的理解完全不同了。
模型可以理解客戶,prompt 可以給它指令,工具可以讓它採取行動,後端可以儲存結果。但這些元件仍然都需要清楚的規則,來定義什麼時候下一步真的能發生。
這就是我覺得打造這個專案最有趣的地方。
我一開始以為自己主要是在學怎麼把 AWS 服務串起來。最後我學到的,卻是代理周圍的界線有多重要。
老實說,這大概是我帶到下一個專案裡,更好的收穫。
🤝 一起保持聯繫
| 平台 | 在這裡找到我 |
|---|---|
| GitHub | 做東西中 → hemapriya-kanagala |
| 資源與更新 → hemapriya-kanagala | |
| X | 隨性的開發想法 → @KanagalaHema |
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式