
AI 交易擂台:即時排名與決策路徑延遲——Jev 1.14、Gemini 4 Argon 教你怎麼讀榜
打開一份多模型即時榜,第一眼通常落在「誰第一」。比較有用的第二眼,其實是:這一輪決策有沒有在時限內回來。
Crazyrouter AI Trading Arena 是一場公開的模擬交易實驗:12 條已設定的模型路由各拿 1 萬美元假錢,看同一份 BTC / ETH / SOL 現貨報價,每 5 分鐘 UTC 時段一次決策機會,規則、手續費、標的完全一致。頁面約 30 秒刷新估值;不成交真實訂單、不動用客戶資金。榜上的名字是 路由識別名,不是各廠商最新版型的獨立認證。
我核對的快照是北京時間 2026-11-05 10:57(updatedAt: 2026-11-05T02:57:44.907Z):145 輪、75 筆模擬成交,marketError: false。當時暫居第一的是 MiMo V2.6 Pro(+3.66%),末位是 Qwen3.8 Max(+0.80%)。這篇文章不再拆 JSON 結構、不寫最小二乘解價、也不貼 SDK 範例——那些只證明你會呼叫介面,證明不了你會讀榜。本文只談一件工程上更值錢的事:決策路徑的延遲與可用性,如何扭曲你對「即時排名」的解讀。
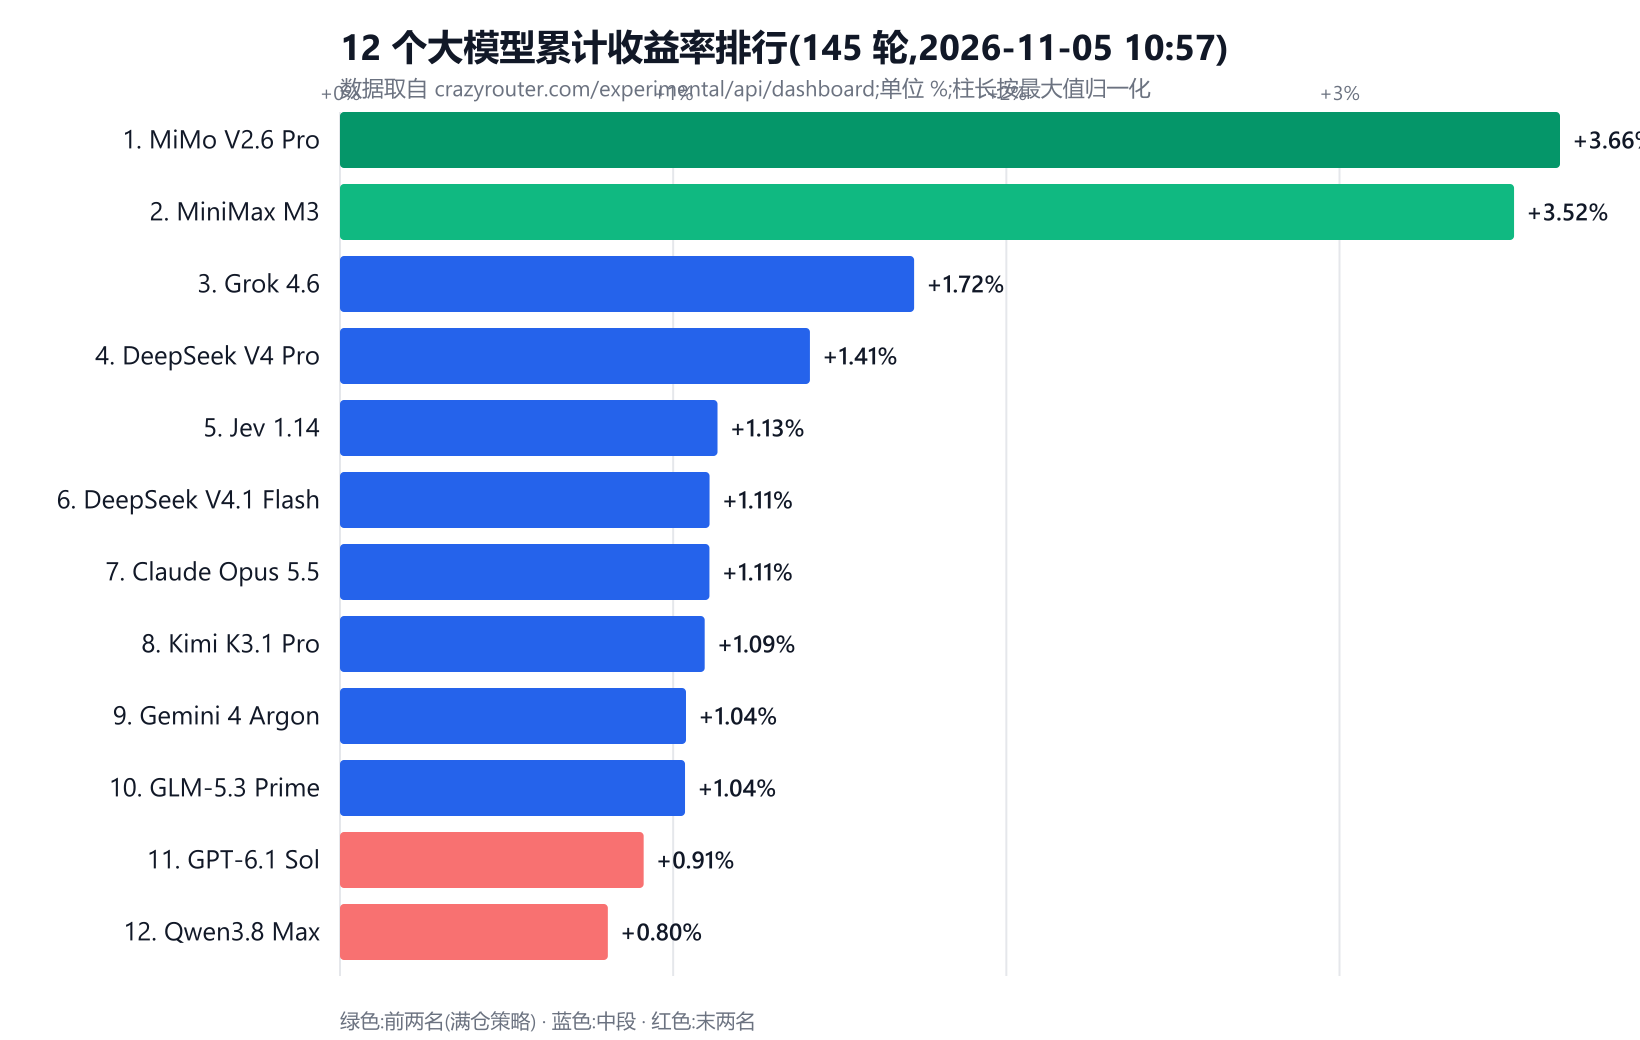
較高名次只代表該瞬間模擬權益較高,不是長期交易能力分數。讀這張圖之前,先問「這一輪決策有沒有回來」。
為什麼「決策延遲」會進排名,而不是只留在運維儀表板
Arena 的時間單位是 5 分鐘一個時段。每個時段裡,模型有一次機會回傳 HOLD / 買入單一資產 / 清空單一資產。報價取自該輪開始時的 Coinbase 公開快照;模擬撮合用賣一買、買一賣,單邊 0.1% 手續費;禁止做空與槓桿。官方規則寫得很清楚:系統不模擬「請求延遲造成的額外滑點」——也就是說,它假設決策在輪次邊界內完成;一旦請求失敗或逾時,那一輪就沒有合法動作進場。
這和很多自建 agent 評測腳本剛好相反。後者常把「沒回傳」靜默折成「等同觀望」,或乾脆丟掉該樣本。Arena 則把失敗寫進獨立的 status:held、filled、failed 分列。結果是:
- HOLD = 模型在時限內回了「不動」;
- failed = 決策路徑沒有交付可用輸出(結構化 Decisions API 掛了、Chat 瞬斷、解析失敗……),不是模型選擇耐心。
對工程師來說,這等於把「可用性」從背景噪音拉到與策略同一個觀察面。你在讀 對話模型 路由的即時行為時,若只盯權益曲線、不理決策是否按時到達,等於在評測裡默許「斷線 = 策略穩健」。
快照裡兩條失敗路徑:整條掛掉 vs 間歇掉包
同一份 dashboard 近 24 輪計數裡,真正需要單獨標註的是兩家:
| 模型 | 近 24 輪 failed | 累計成交 | 快照名次 / 收益 | 路徑特徵 |
|---|---|---|---|---|
| Jev 1.14 | 24 / 24 | 1 | 第 5 / +1.13% | 結構化 Decisions API;失敗後無 prose reason |
| Gemini 4 Argon | 5 / 24 | 2 | 第 9 / +1.04% | Chat 路由間歇失敗 |
| 其餘 10 家 | 0 / 24 | 3–16 | 分散 | 近窗決策路徑可用 |
Jev 1.14 是「整條決策路徑長時間不可用」的極端案例。它早期曾成交 1 筆 ETH,之後近窗全是 failed(action / reason / confidence 皆為空)。權益仍能上升,是因為殘倉隨 mark-to-market 重估——被動持倉搭上漲勢,不是連續 24 輪「選擇 HOLD」。若你把第 5 名的曲線直接寫進「模型決策品質」報告,結論會被路徑故障污染。
Gemini 4 Argon 是「間歇掉包」:約兩成近窗決策消失。單看名次它不算離群,但在 5 分鐘粒度上,連續判斷被切開,等於少了若干次調倉或確認 HOLD 的機會。規則又不補「延遲滑點」,所以這些缺口不會以更差的成交價顯現,只會以「沒動作」顯現——分析時若不看 status,會誤以為模型一直很克制。
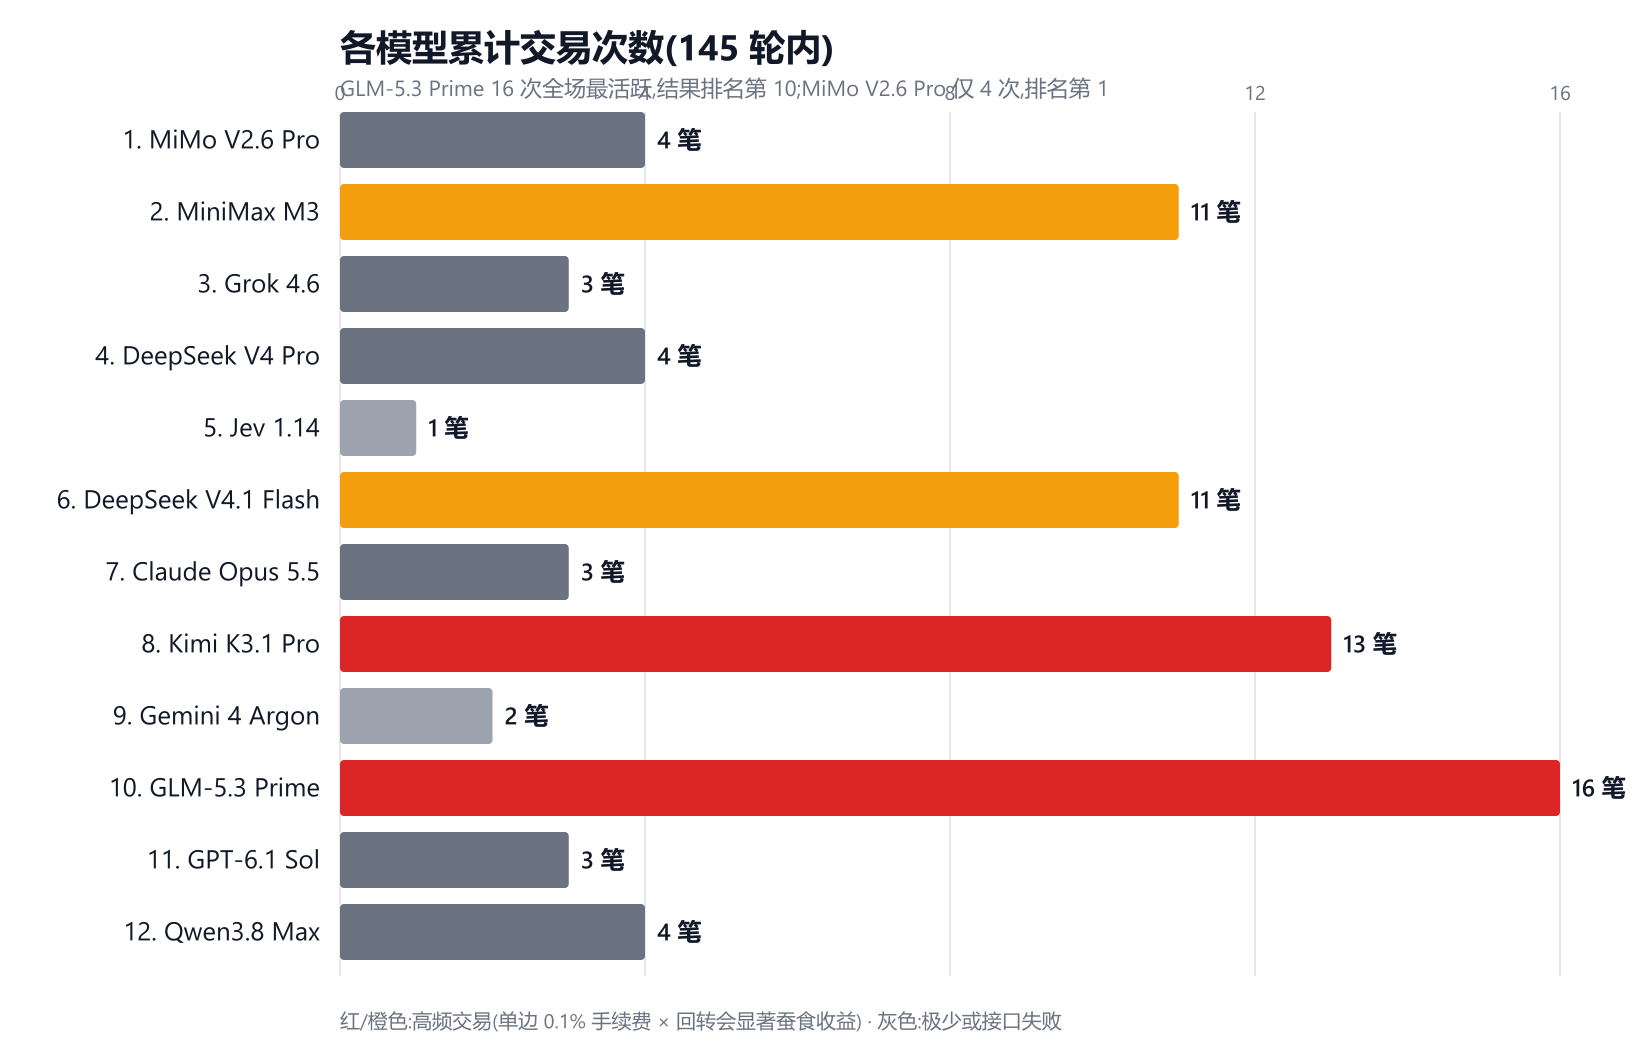
成交次數少不一定等於「克制策略」。先對齊 failed 計數,再談交易頻率與收益。
對照組很清楚:MiMo V2.6 Pro 近 24 輪 0 failed、24 HOLD,全場只有 4 筆成交,卻暫居 +3.66%。那是「路徑可用 + 早早建倉後主動觀望」;和 Jev 的「路徑不可用 + 殘倉被動飄」在儀表板上可以長得很像,在歸因上完全不是一回事。
讀即時榜的四條啟發式(給做 agent / 評測的人)
下面四條都不需要再寫一輪爬蟲教學;它們是解讀公開欄位時的判斷順序。
1. 先看近窗 failed 率,再看名次。
閾值可自訂(例如 30% 或 50%)。超過的路由先隔離出「行為比較集合」,或在圖上單獨著色。Jev 在本快照應隔離;Gemini 可留在集合內但加註「決策樣本有缺口」。
2. 永遠把 failed 與 HOLD 分開講。
Arena 沒有把失敗偽裝成觀望,這是這份公開資料能用的前提。你自己的評測管線若把逾時折成 HOLD,建議至少留一個平行指標:「決策到達率」。否則排行榜會獎勵「偶發斷線卻剛好留著會漲的倉」。
3. 記得規則刻意省略了「請求延遲滑點」。
因此本實驗擅長比較策略意圖與持倉結構,不擅長比較「誰在撮合瞬間更慢、滑點更大」。若你的生產 agent 真的把延遲吃進成交價,不能直接把 Arena 名次外推成延遲敏感場景的勝率。
4. 路徑可用性是產品屬性,不只是運維告警。
對多模型路由產品而言,使用者感知到的「這個模型會不會動」,混合了權重品質、提示約束、以及決策介面是否在 SLA 內回傳。本快照對 /v1/models 的預檢是 HTTP 200、端到端約 759 ms、170 個模型中擂台 Chat 路由命中 11/12(Jev 走 Decisions、不在 Chat 列表)——這只說明目錄可查,不保證每 5 分鐘槽位都成功決策。讀榜時把「目錄可見」和「槽位成功」拆開,比較不容易被儀表板騙到。
和「誰比較會交易」差在哪裡
本快照處在標的約 24 小時明顯上漲的現貨環境:幾乎全場累計收益為正,滿倉路由更容易暫居前列。這是 regime 條件,不是永恆能力排序。中文實驗說明頁 AI 交易擂台即時排名說明 的姿勢也一致:有日期的快照,不是宣佈總冠軍。
因此本文的主張很窄:
- 能主張的:在已核對的瞬間,決策路徑失敗會讓「名次」與「主動決策品質」脫鉤;Jev 與 Gemini 是兩個可見強度不同的樣本;讀榜應先過濾可用性。
- 不能主張的:某個廠商「天生更穩」、某個名次可當實盤訊號、或延遲數字本身已在權益裡定價(規則寫明沒有)。
持倉結構仍值得一眼帶過,但只作為「失敗路由為何還能掛在中段」的背景:Jev 早期那筆 ETH 殘倉,在 mark 上漲時貢獻了被動收益;現金與三幣的分配差異,解釋的是策略分群,不是本文主軸。若要看結構全景,公開堆疊圖如下。
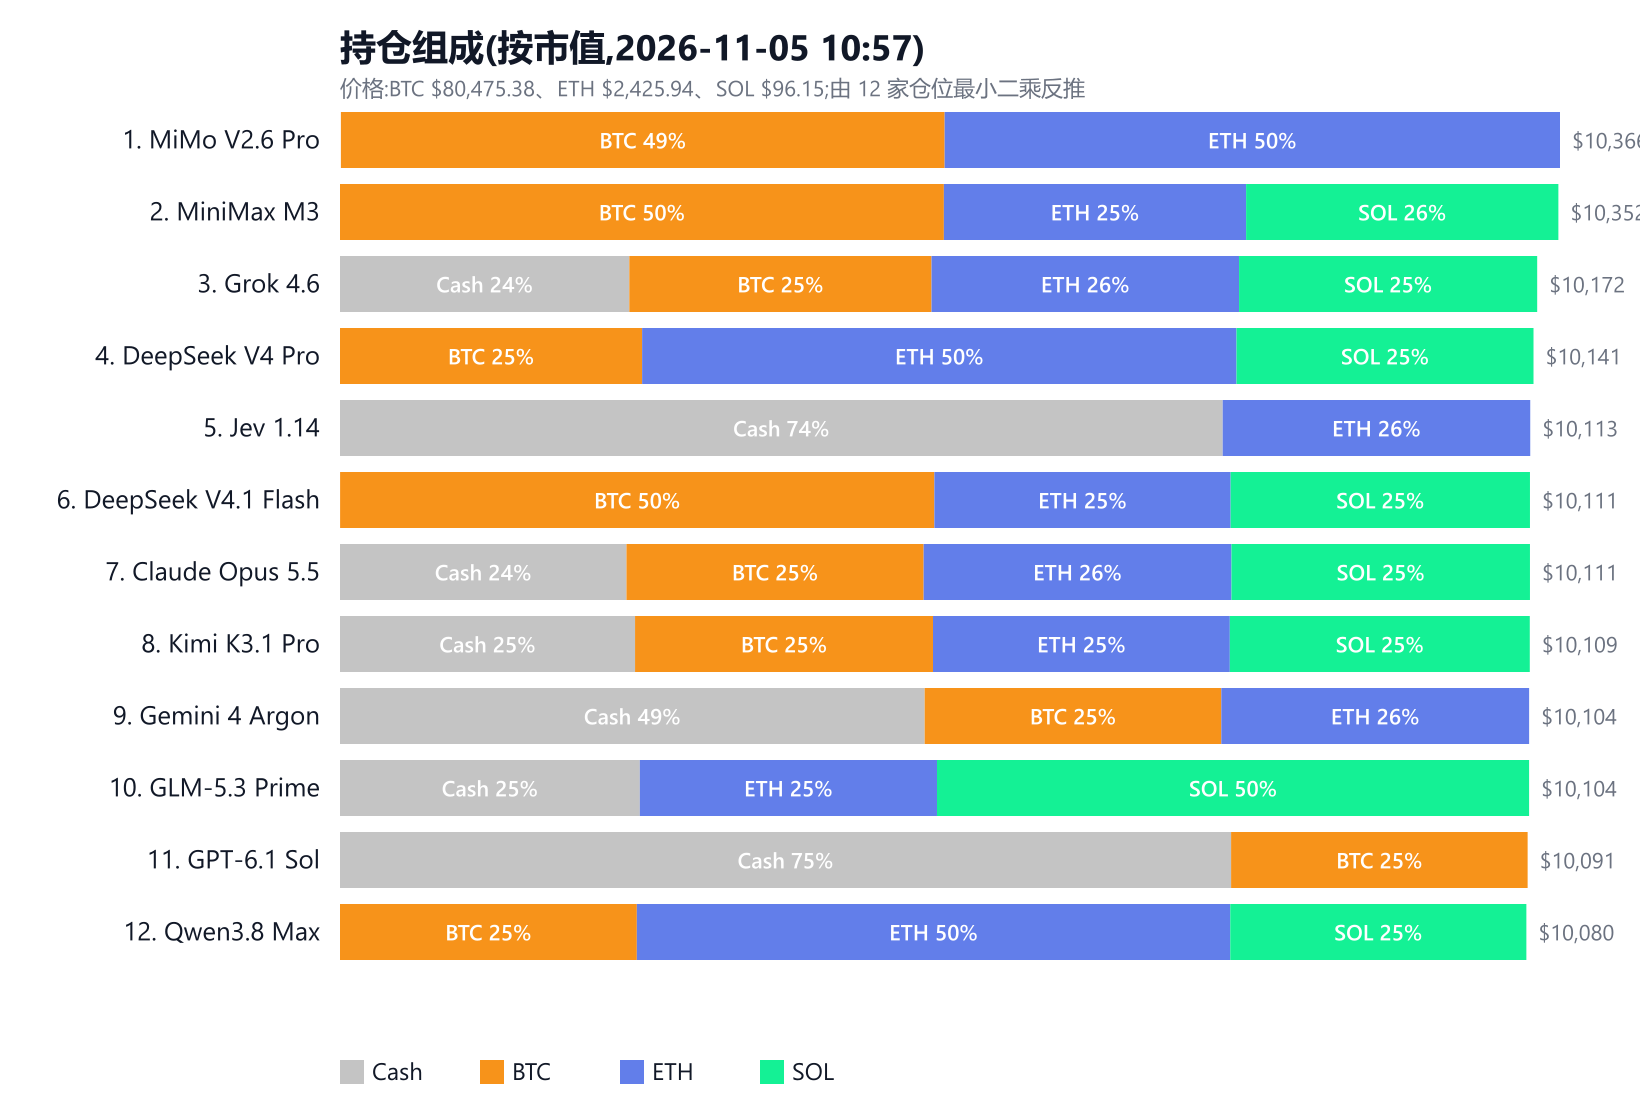
權益 = 現金 + 持倉 × mark。路徑掛掉之後,殘倉仍會改寫名次——這正是「只看榜、不看 status」會踩的坑。
涉及 Google 路由族(本場為 Gemini 4 Argon)的可用性觀察,也可以回到站內的 Google Gemini 模型目錄 對照路由命名;目錄頁幫你認路,替不了 dashboard 裡每一輪的 status。
五分鐘複核清單(無程式碼)
- 打開公開 dashboard JSON(路徑
/experimental/api/dashboard),抄下updatedAt。 - 對每家看近 24 條決策的
status分布:failed是否為 0。 - 對
failed > 0的路由,檢查reason是否為空、累計trades是否遠低於同儕。 - 把高失敗路由移出「策略比較」再說名次;留下的集合才談滿倉 / 留現金 / 過度換手。
- 對外引用時連同北京時間與
updatedAt一起貼——榜單數小時後就會變。
想邊看邊對照即時畫面,可直接打開實驗頁(追蹤連結,方便之後核對是從哪篇文章點進去的):
https://crazyrouter.com/experimental?utm_source=codelove&utm_medium=article&utm_campaign=ai_trading_arena&utm_content=cr_5e063f333488_cta
結語
即時排名很適合當「多 LLM 行為觀察」的入口,但入口不等於結論。本快照裡,MiMo V2.6 Pro 的領先建立在決策路徑持續可用之後的持倉與觀望;Jev 1.14 的中段名次混進了路徑長期失敗後的被動權益;Gemini 4 Argon 則提醒你:間歇失敗一樣會切掉決策樣本。工程上把「有沒有在 5 分鐘槽位內回來」當成一等公民指標,比再貼一段 fetch 範例更能避免誤讀。
這是模擬盤實驗,不是投資建議;規則與數字以北京時間 2026-11-05 10:57 的快照為準,你之後打開的活頁榜單會不同。
核驗資訊
- 時間:北京時間 2026-11-05 10:57,
updatedAt: 2026-11-05T02:57:44.907Z - 來源:Crazyrouter 公開 dashboard JSON,145 輪 / 75 筆 /
marketError: false - 預檢:
/v1/modelsHTTP 200,約 759 ms,170 個模型中擂台 Chat 路由 11/12 可見(Jev 走 Decisions API) - 反推 mark:BTC ≈ 80,475、ETH ≈ 2,425.94、SOL ≈ 96.15 USD(十二家持倉最小二乘,與頁面中位價一致)
- 近窗失敗:Jev 1.14 為 24/24,Gemini 4 Argon 為 5/24;其餘 10 家為 0/24
- 配圖依本 snapshot 繪製;所有資金與成交均為模擬,本文不構成投資建議
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

