

Most of我們中的許多人都聽過效能測試這個詞,不論是在發布一個重大新功能之前、推出一個新應用程式時,或只是單純檢查應用程式是否能承受特定負載。
效能測試能幫助我們了解應用程式在負載下的表現,以及它是否能承受預期的壓力。不過,效能測試必須設計得當,否則結果可能具有誤導性,甚至讓我們得出錯誤結論。
相反地,設計良好的效能測試可以幫助我們找出瓶頸、了解應用程式的限制,並在發布前提升更多信心。
在這篇文章中,我們會先看效能測試的基本概念與不同類型,接著進入更實務的部分:如何設計貼近真實情境的測試 сценарio、如何決定應用程式應承受的負載、如何處理外部服務,以及測試環境應該在多大程度上接近正式環境。
目標不只是產生大量請求,而是建立真正能告訴我們應用程式在真實世界中會如何表現的效能測試。
目錄
那麼,我們先從基本定義與不同類型的效能測試開始。
基本定義
我們可以把效能測試概括為一種非功能性軟體測試方法,用來評估應用程式在特定工作負載下的速度、穩定性、可擴充性與回應性。
簡單來說,讓我們以 API 為例。我們會準備測試,在負載下呼叫想測試的端點,通常依照某種順序進行,以模擬應用程式實際的使用方式。效能測試背後的核心理念,就是避免在應用程式尚未準備好承受預期負載時就貿然上線。
效能不佳可能導致正式環境當機、回應時間緩慢,或應用程式無法在要求的時間內完成工作。這些問題最終都可能導致客戶流失、營收損失,或產品聲譽受損。
我們可以依據設定方式、目的,以及想觀察的指標,將效能測試分成不同類型。
測試類型
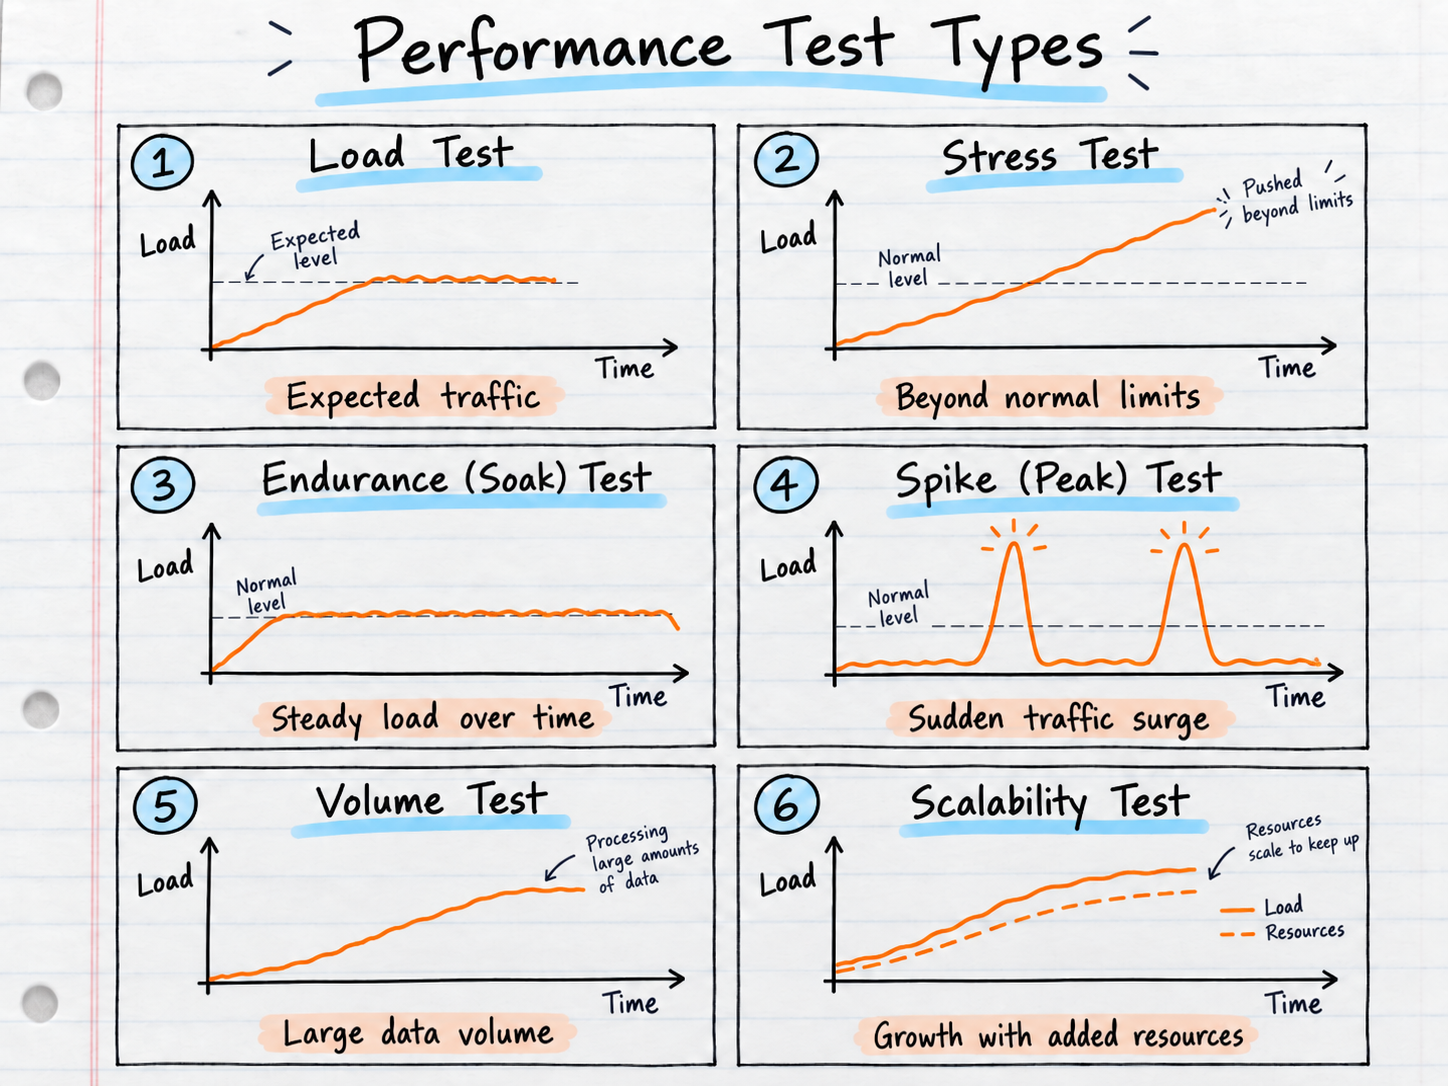
我想這張圖已經說明得很清楚了,不過還是簡單介紹一下各種類型:
負載測試(Load Test):驗證應用程式在預期或正常流量下的行為。目標通常是確認系統能在維持可接受的回應時間、錯誤率與資源使用率的情況下,承受所需的使用者數或請求數。
壓力測試(Stress Test):將應用程式推到超出預期限制,找出何時開始退化或失效。它能幫助我們找出系統的最大承載量,並觀察當 CPU、記憶體、資料庫連線或執行緒等資源耗盡時,系統會如何表現。
耐久測試(Endurance/Soak Test):在較長時間內讓應用程式持續承受負載。目的在於找出短時間測試可能看不出的問題,例如記憶體洩漏、連線洩漏、資源耗盡,或隨時間產生的效能下降。
尖峰測試(Spike/Peak Test):模擬流量突然且大幅增加。它能幫助我們驗證應用程式如何回應負載的快速變化,以及在流量回到正常後是否能恢復。
容量測試(Volume Test):著重於應用程式在需要處理大量資料時的表現。例如,我們可以測試資料庫查詢、匯入、匯出或批次作業,在資料量遠大於平常時會如何運作。
可擴充性測試(Scalability Test):驗證當我們增加工作負載並投入更多資源時,應用程式的效能如何變化。目標是了解系統是否能有效擴充,例如增加更多應用程式執行個體、CPU、記憶體或資料庫容量。
你不一定需要為每一種類型都實作完全不同的測試。在很多情況下,你可以重用同一個效能測試情境,只是根據要量測的內容調整設定,例如同時使用者數、持續時間、請求速率或工作負載模式。接著,再依照測試目標觀察不同指標。
而且也不是每個應用程式都需要所有類型的效能測試。有些應用程式可能主要需要負載測試與壓力測試,其他則可能更適合負載測試與尖峰測試。這真的取決於應用程式的需求,更重要的是取決於使用者實際如何使用它。
如何正確設計效能測試
設計良好的效能測試非常重要,因為大多數時候,我們不會只是隨機對端點發送請求。那樣通常無法告訴我們應用程式的真實行為,或瓶頸究竟在哪裡。
長期下來,我發現最有效的方法,是找出典型使用者行為,並在效能測試中加以模擬。例如,想像一個帶有訂單系統的電商應用程式。
典型使用者可能會:
- 搜尋幾項商品。
- 將商品加入購物車。
- 進行結帳流程。
- 完成付款。
與其把每個端點單獨拿來測試,我會設計一個能模擬整個流程的效能測試,並呼叫前端平常會呼叫的相同端點。
另一個例子可能是有多種使用者類型的商務應用程式,而不同使用者擁有不同權限,使用方式也不同。在這種情況下,我們可以為每種使用者類型設計典型工作流程,並依照前端的順序呼叫 API 端點。這種做法的好處是能模擬真實的使用者行為。之後,我們可以調整測試設定,例如增加同時使用者數,但仍維持相同且貼近真實的工作流程。
再舉一個例子,可能是 API 對 API 的通訊。假設我們有一個 POST 端點,後面接著一個 GET 端點。在這種情況下,我們可以在特定負載下模擬不同的輸入參數與請求模式,並觀察系統的行為。
假設我們已經設計好使用者路徑。在建立實際測試流程時,仍有幾個重要事項需要考慮。下方圖片整理了一些關鍵概念:
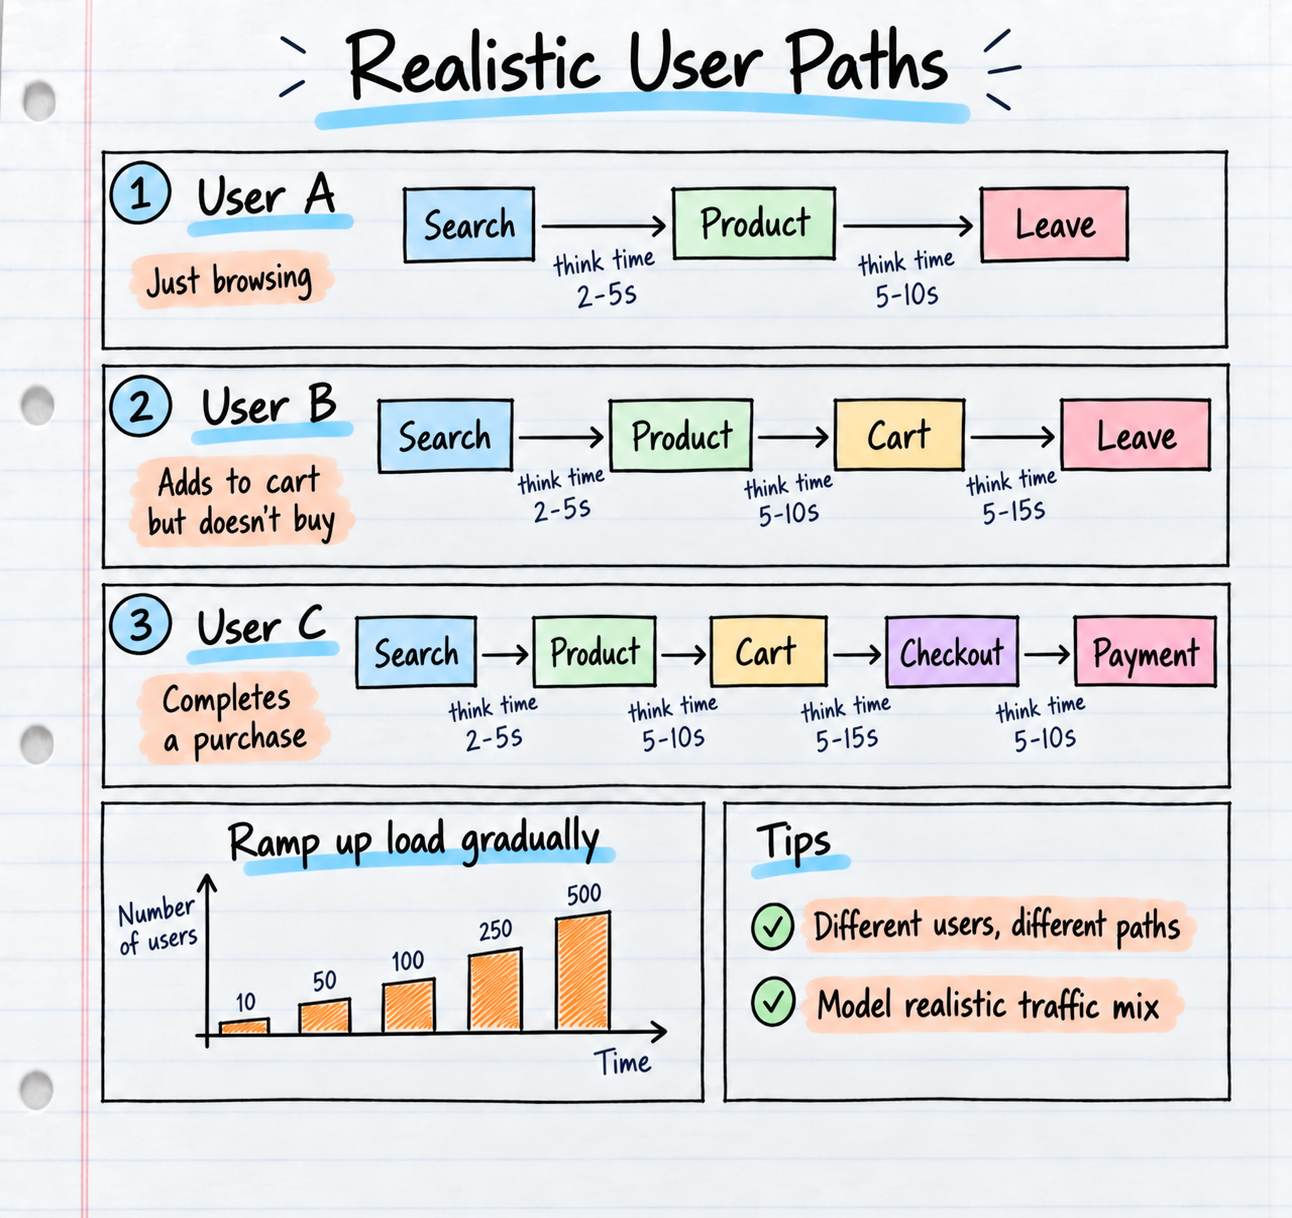
- 真實使用者不會像效能測試一樣快地點擊與送出請求,因此我們應該在操作之間加入符合現實的思考時間(think time)。
- 不是每位使用者都會走同樣路徑。在電商應用程式中,有些使用者會完成訂單,有些則只瀏覽商品,或把商品加到購物車後之後再回來。我們因此應模擬多條不同行為的使用者路徑。
- 使用者通常不會在完全相同的時間點一起連線,因此對於一般負載測試,我們應該讓負載逐步上升。
真實的使用者旅程告訴我們該測試什麼。下一個問題則是系統需要承受多少負載。
定義預期負載
設計逼真的工作負載只是工作的一部分。在執行測試之前,我們還需要定義什麼才算成功。不是每個應用程式都需要承受每秒 1,000 個請求。每個系統都有自己的預期工作負載與效能需求。
例如:
預期負載:150 RPS

p95 < 400 ms
p99 < 1 s
錯誤率 < 0.5%
維持所需吞吐量
沒有持續成長的佇列/連線
那麼,我們要如何決定這些數值?
讓我們回到電商的例子。許多應用程式在某些時段的流量會明顯高於平常。對電商應用程式來說,可能是聖誕節、黑色星期五,或其他大型促銷活動。如果公司已經具備良好的可觀測性,歷史正式環境指標就能提供很有用的起點。我們可以查看 Grafana 等工具,找出峰值請求率、同時使用者數、訂單量、CPU 使用率、記憶體消耗,以及其他相關指標。接著,我們就能估算未來負載。例如,如果預期明年流量成長 10%,我們可能會決定在預期負載之上再加上額外安全邊際來測試系統。
另一種估算所需負載的方法,是從商業需求出發。例如,假設業務端預期我們的電商應用程式要在兩小時的尖峰期間處理 10,000 筆訂單。我們可以觀察典型訂單流程,估算使用者在搜尋商品、加入或移除購物車商品、進行結帳並完成訂單時,會產生多少 HTTP 請求。如果一筆完成的訂單平均會產生 20 個請求,那麼 10,000 筆訂單大約就代表這兩小時內會有 200,000 個請求。
接著,我們可以計算平均請求速率:
200,000 個請求 / 7,200 秒 ≈ 每秒 28 個請求
這表示平均大約是 28 RPS。但這不代表 28 RPS 就應該直接成為測試目標。這個計算只是在估算完成訂單流程所產生的流量。實際應用程式流量通常會更高,因為瀏覽行為、放棄購物車、背景請求與其他使用者旅程也都會貢獻總工作負載。真實流量也很少是平均分布,因此我們應該考慮較短時間的流量尖峰,並加入適當安全邊際。
這種方法在無法取得可靠正式環境指標時,提供了另一種估算所需負載的方式,也說明我們可以同時從技術資料與商業需求推導效能目標。
效能測試與外部服務
在效能測試中,外部服務需要特別注意。
在某些情況下,我們可以模擬外部服務,因為基於幾個原因,我們根本不需要或不想測它。一個很好的例子是位於我們端點背後的付費 API,例如 LLM API 或其他付費第三方服務。成本是一個合理的考量,因為在效能測試期間,我們的應用程式可能會在相對短的時間內產生大量請求。
另一種情境是我們根本不需要呼叫外部 API。例如,它可能只是參考資料 API,或是一個其效能不在測試範圍內的付款服務提供者。這時,我們可以使用像 WireMock 這類工具,以受控依賴取代它,並在測試期間回傳預期的回應。如此一來,我們就能專注於自身應用程式的效能,而不會受到外部服務的效能、速率限制或可用性影響,避免更難找出真正的瓶頸。
另一方面,如果與外部服務的通訊是系統真實世界效能的重要部分,我們可能會想單獨測試它,或將它納入效能測試中。
因此,要不要模擬外部服務,應該取決於我們想模擬的行為,以及我們究竟想量測什麼。
環境設定
環境設定也是效能測試中很重要的一環,因為理想上,我們希望效能測試環境盡可能接近正式環境。如果環境與正式環境差異太大,結果就可能失真,尤其是當我們想估算應用程式在真實正式負載下的表現時。
那麼,我們應該設定什麼?
首先,應用程式本身應使用與正式環境相同或非常相近的設定。執行 API 的伺服器或叢集,也應具備相近的 CPU、記憶體、擴充規則與其他資源限制。
資料庫也是一樣。這不只是要使用相近的資料庫資源而已,我們也應避免在幾乎空白的資料庫上測試。資料的數量與分布會對效能產生顯著影響。在高負載下,CRUD 操作、JOIN、篩選與排序,當資料表有數百萬筆資料時,表現可能和只有少量測試資料時完全不同。索引、查詢執行計畫、統計資訊與快取的行為,也都可能因資料量與結構不同而改變。
因此,只要可能,測試資料庫應盡量包含具代表性的真實資料量。
我們也應注意快取設定,例如 Redis 或記憶體內快取。不同的快取設定,或是在快取永遠處於暖機狀態下測試,都可能產生無法代表真實正式環境行為的結果。
網路條件也是另一個重要因素。例如,如果外部服務在本機被模擬,請求可能幾乎瞬間完成;但正式環境中的真實服務,可能會額外增加數十到數百毫秒的網路延遲。根據我們想量測的內容,我們可能需要模擬這種延遲,才能得到更貼近現實的結果。
最後,還有負載產生器本身。這一點很容易被忽略。產生負載的機器必須有足夠的 CPU、記憶體、網路容量與可用連線,才能產生所需工作負載。否則,負載產生器本身就會變成瓶頸,而不是我們真正要測試的應用程式。
指標與結果
當我們執行完效能測試後,就需要評估結果,並通常產出某種報告。我們關注的指標會依測試類型而異,因為不同類型的測試回答的是不同問題。
讓我們回到電商應用程式,假設我們決定同時執行負載測試與壓力測試。
對於負載測試來說,我們已經知道預期工作負載,例如特定的每秒請求數或同時使用者數。現在我們想驗證應用程式是否能在維持可接受效能的情況下承受這個負載。
一些最重要的指標包括:
- 回應時間,特別是 p95 或 p99 等百分位數。
- 錯誤率——有多少百分比的請求失敗。
- 吞吐量——應用程式是否真的處理了預期數量的請求。
- 資源使用率——CPU、記憶體、資料庫連線、連線池與其他相關資源。
例如,如果某個端點的 p95 回應時間明顯高於預期,我們就可以開始調查瓶頸在哪裡。同樣地,如果錯誤率超過我們可接受的上限,我們就需要找出哪些請求失敗,以及原因為何。
對於壓力測試來說,我們的目標略有不同。我們會刻意把負載提高到超出預期水平,嘗試找出應用程式開始退化的點。在這裡,我們會觀察隨著負載增加,回應時間與錯誤率如何變化,同時也會看 CPU、記憶體、資料庫連線、佇列及其他受限資源。我們要找的是系統何時達到飽和、何時開始產生過多錯誤,或何時無法再維持所需吞吐量。
同樣值得觀察的,是在負載下降之後應用程式的行為。某個系統在極端負載下雖然變慢,但之後能恢復,這與一個卡住不動或需要重新啟動的系統,表現是非常不同的。
下方圖片顯示我們在範例中監控的指標,也強調為什麼我們需要同時觀察多張圖表,才能找出特定瓶頸或飽和點。
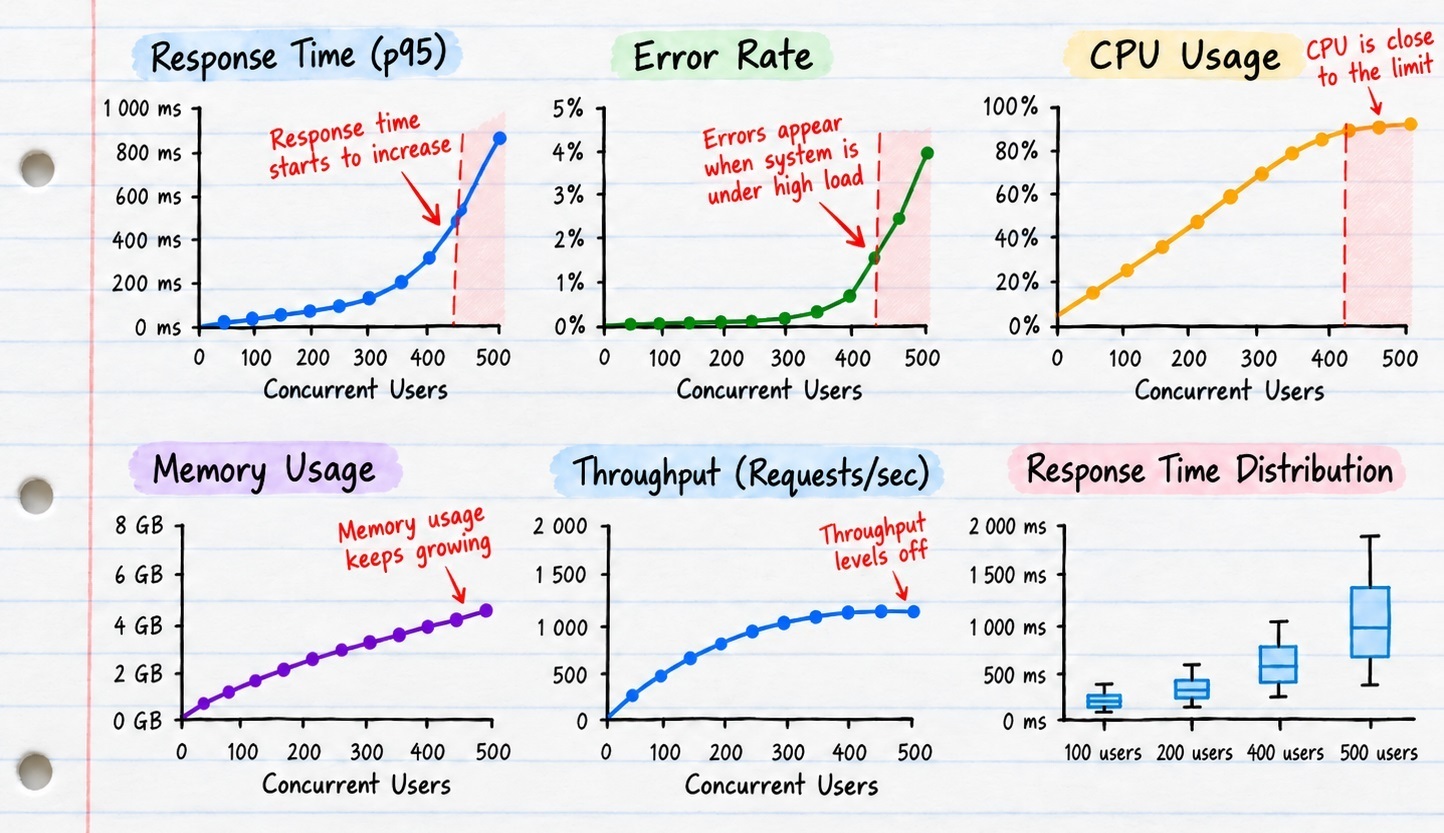
因此,最終報告不應只包含像平均回應時間這樣的單一數字。它應該把產生的工作負載、延遲、吞吐量、錯誤與資源使用率連結起來,讓我們不只能理解應用程式是否未達到預期,也能知道原因是什麼。
總結
在這篇文章中,我們先介紹了效能測試的基本概念,接著著重於如何針對真實世界情境設計測試。
關鍵在於理解應用程式實際如何被使用、準備貼近真實的測試環境、產生具代表性的工作負載,並監控正確的指標。當這些部分都設計得當時,效能測試就能提供關於瓶頸、系統極限,以及應用程式在負載下整體行為的有用資訊。
市面上已經有很多很棒的文章在解釋效能測試理論與各種測試類型。這篇文章的目的不是重複所有內容,而是從更實務的角度來看效能測試,並分享我如何設計貼近真實的測試。
歸根究柢,只有當效能測試的工作負載、環境與指標足夠真實,讓結果具有意義時,這個測試才是有用的。
原文出處:https://dev.to/gramli/api-performance-testing-how-to-design-realistic-tests-59gn
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

