

想要讓 Claude Code 輸出完美的 Figma
只要請 Claude Code「把這個畫面重現成 Figma」,幾分鐘內 Figma 裡就會出現一個 frame。
但即使乍看之下像成品,對設計師來說往往還不算完成。
它常常忽略排版和既有畫面的資訊架構;就算考慮到了,也可能沒有把色彩套用到設計 token 的變數,而是直接寫死 color code。
另外,按鈕和表格也常常不是既有元件的 instance,而是乍看很像、仔細看卻只是原生 frame。
無論從外觀還是從設計維運的角度來看都不夠,甚至會讓人連發修正指示都覺得麻煩。
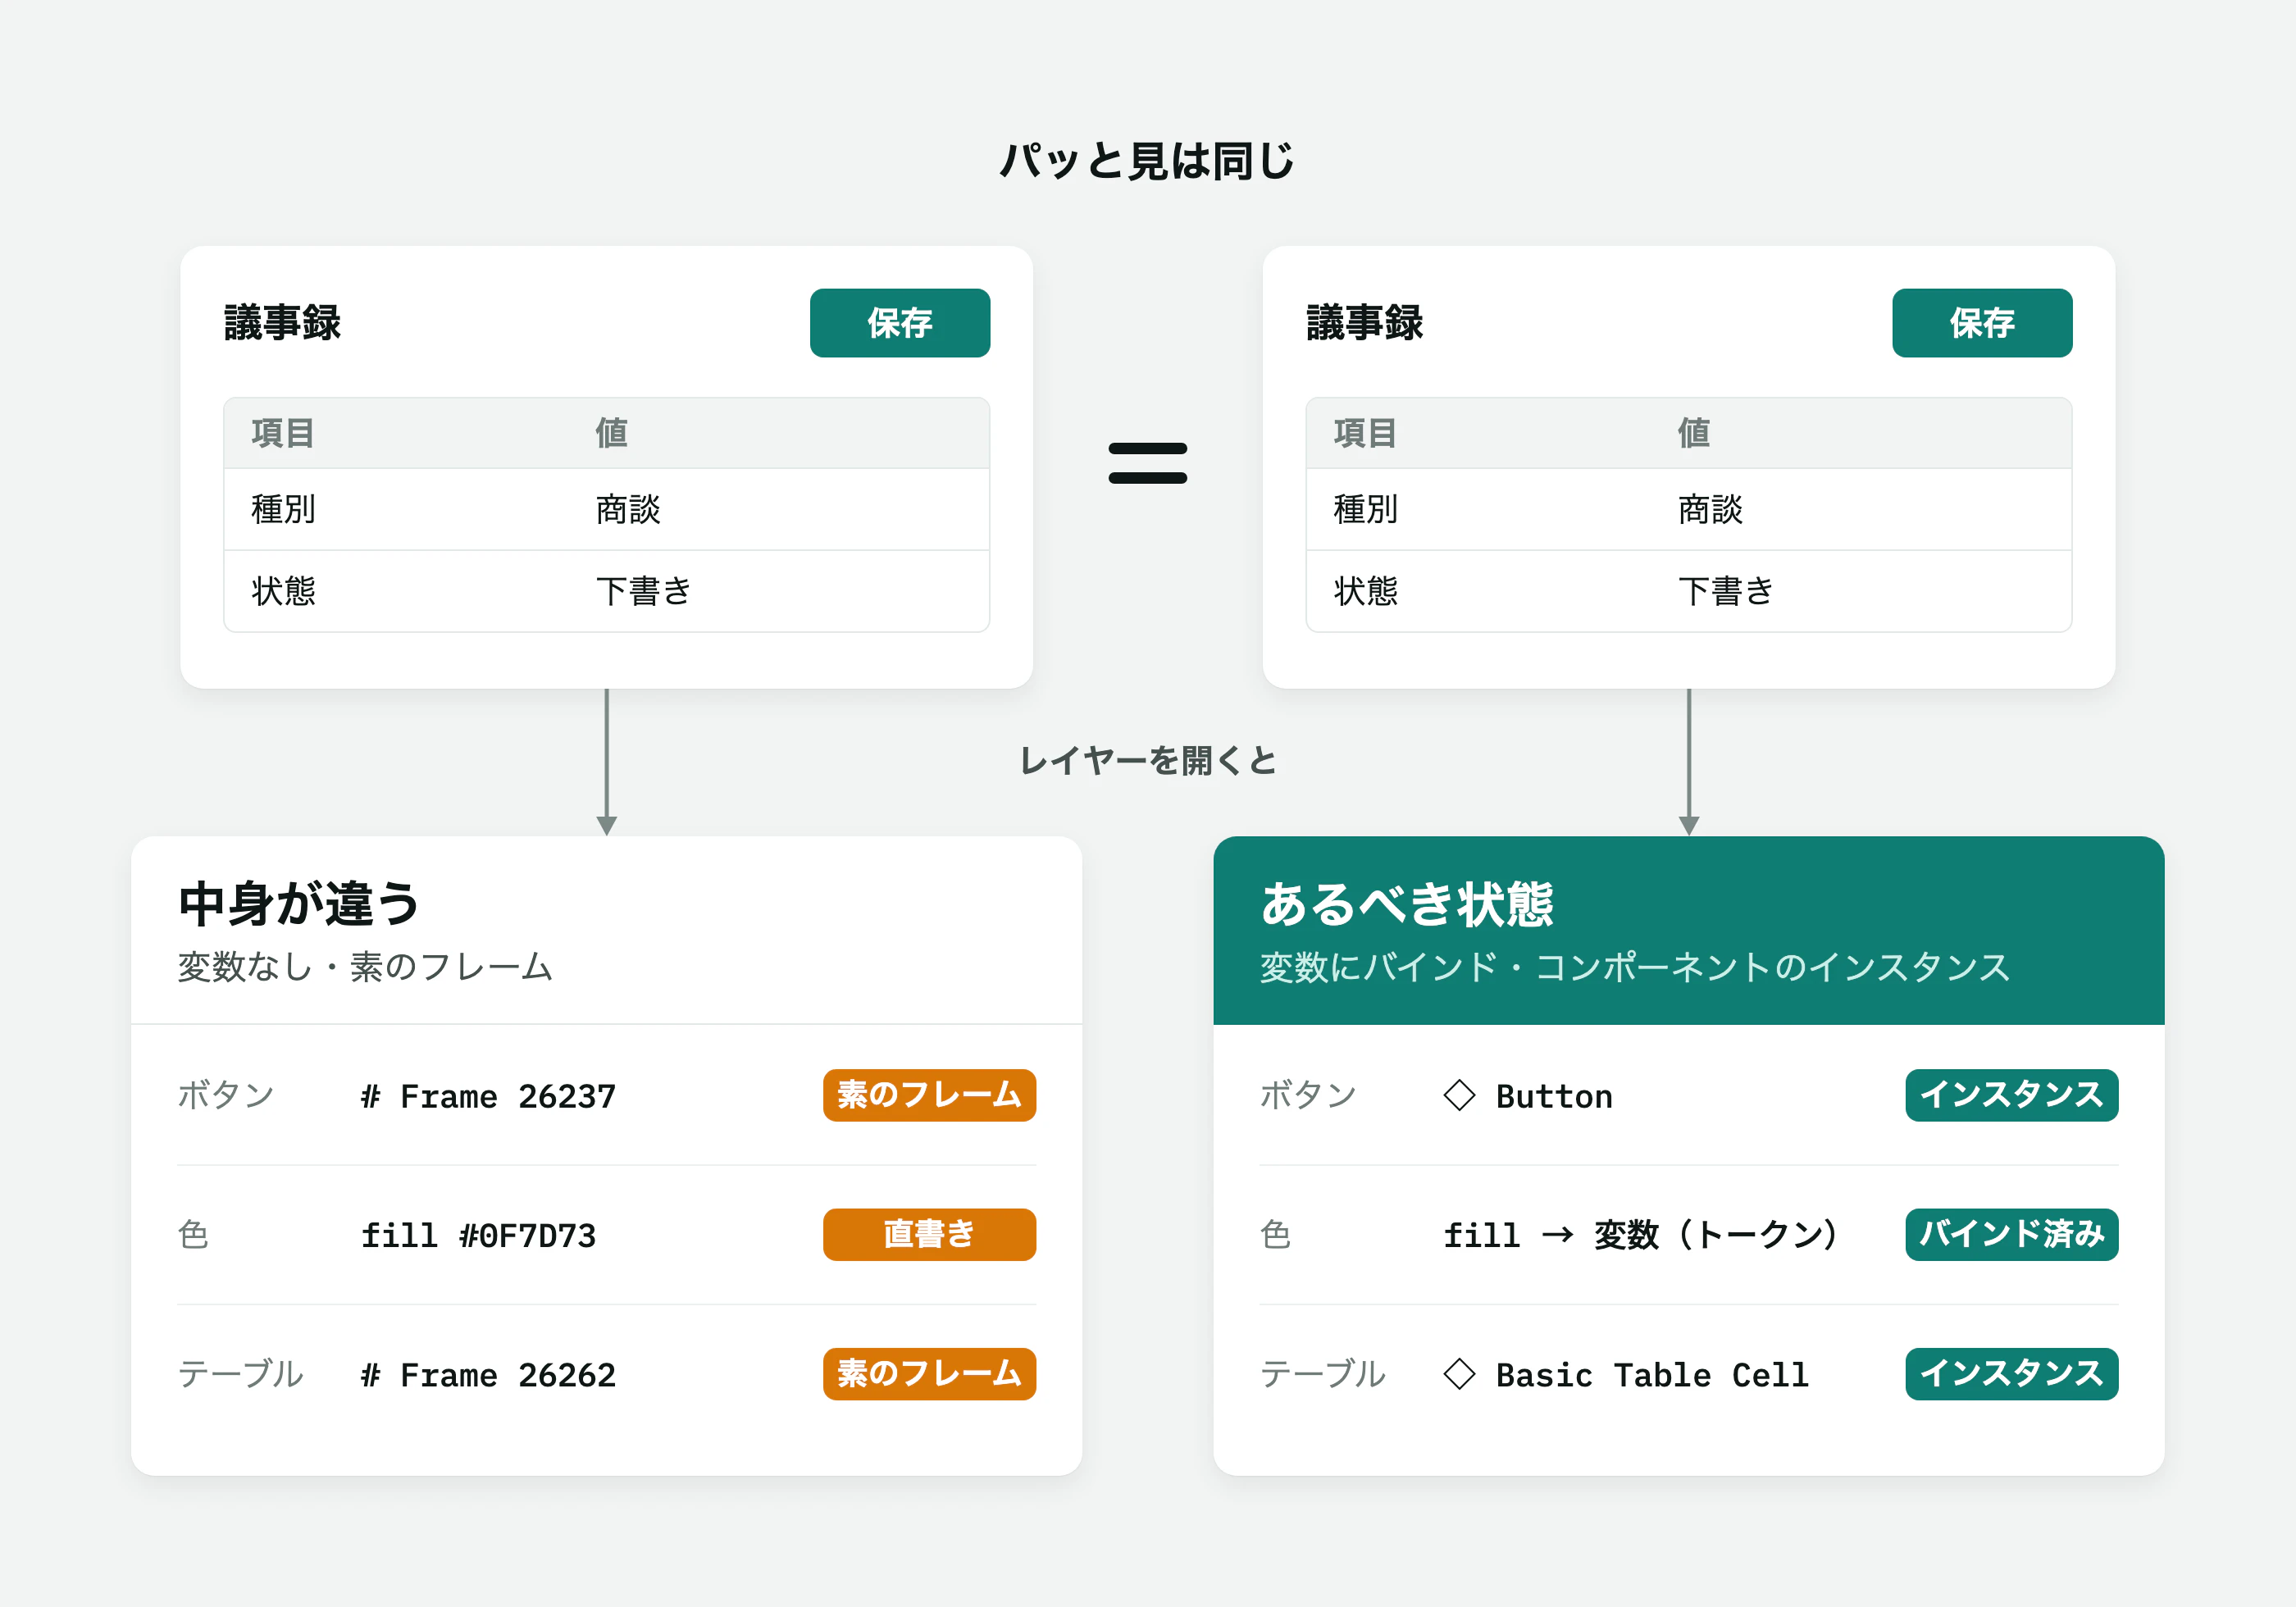
就算乍看之下沒問題,究竟困擾在哪裡?
等於白白失去在 Figma 裡管理設計系統的意義。
- 當你想更改品牌色或狀態色時,如果有綁定變數,只要改一處,全畫面就會跟著更新;如果是直接寫死,就得一個一個手動改
- 也無法跟著深色模式或不同租戶的配色調整
- 如果不是元件 instance,之後就算把按鈕高度改掉,那個 frame 也會被單獨留在那裡
最後,單一元素也許還能接受,但若要讓產品設計持續保持一致,就得一個一個檢查並手動修正。
生成只要幾分鐘,但修正要花好幾倍,那就會讓人搞不清楚到底為什麼要生成。
前提是,UX 觀點上的理想狀態與美學層面的審查,仍然應該由人來做。
但如果要交給 AI,那麼像是套用 instance、套用變數、frame 結構等等這些非本質性的部分,我希望它輸出的 Figma 比人手製作的還要完美。
這篇文章要談的,就是為了把連同檢查與修正的流程也交給 Claude Code,而搭建出的機制。
(至於「乾脆根本不需要 Figma 吧?」這個討論,會在後半段提到。)
先從結果說起
我把透過 Claude Code 剛清稿完成的畫面,交給另一個不同的 AI agent 做全數檢查。
這裡說的清稿,是指把草稿依照設計系統整理過,變成可以交給工程實作的狀態。
結果,檢查出 31 處沒有套用變數的原始色彩指定。
這是我已經反覆對照截圖、自己判斷「應該沒問題了」之後的畫面。
之後又連續從已經通過檢查的清稿裡找出 10 處、2 處問題。
「乍看正確,但不符合 token」這種狀態,用眼睛是看不出來的。
就算叫做出它的 AI 自己「再確認一次」,它也很容易對自己的工作打分打得太鬆。嗯,跟人類也差不多。
要看見看不見的東西,就只能另外找一個人來看。
我把這次試驗直接固化成機制。
結果,我的角色從「把所有 layer 打開逐一確認的人」,變成了「裁定檢查結果的人」。
手動修正並不是完全沒有,但因為系統會用帶有實測數值的清單告訴你該改哪裡,所以確認的成本差很多。
UX 和美學層面的審查,依照前提我現在也還是自己做。改變的是前面那一段可機械判斷的部分。
以下是這套機制,以及實際跑過後的心得。
在程式世界裡,loop 之後接著是 graph
相信很多人都知道,但我還是再把這套機制的源頭概念寫一次。
今年 6 月上旬,帶領 Claude Code 的 Anthropic 的 Boris Cherny 表示,他已經不再親自對 Claude 下 prompt,而是「寫 loop 才是我的工作」。Peter Steinberger 的「不要再對 coding agent 下 prompt 了,去設計一個讓 agent 自己下 prompt 的 loop」這則貼文被大量轉傳,Addy Osmani 進一步把這件事命名為Loop Engineering。
人不再每次都親自下指令,而是把「交辦工作、確認結果、決定下一步」設計成一個系統。
這就是這種思路。「不要讓寫出來的人自己打分」這個原則也包含在內(中文可參考這篇文章,裡面連實作步驟都解釋了)。
隔月,接著又出現了Graph Engineering 的討論。
重點不是只跑一條 loop,而是把不同職責的節點排開,並設計什麼條件下把工作送到哪個節點。節點可以是 LLM、決定性函式,或人類都可以。

loop 並不是不需要了。
節點內部由 AI 思考並行動的部分,還是跟以前一樣是 loop;只是外層多了一個設計對象,也就是「節點之間該怎麼串接」。
這篇文章做的事情,只是把這個「負責確認結果」的角色拆給另一個 AI,並套用到設計中可機械判斷的部分而已。
出處與時間線(2026 年 6~8 月)
- 6 月上旬:Boris Cherny(Anthropic,帶領 Claude Code)表示「已經不再自己下 prompt,寫 loop 才是工作」
- 6 月 7 日:Peter Steinberger 的貼文廣為流傳。同日,Addy Osmani 公開Loop Engineering,名稱就此定著
- 6 月 9 日左右:0xCodez 的14 步驟路線圖。日文解說文章介紹的就是這個
- 7 月 4 日:Josh Simmons 的We are entering the graph engineering phase
- 7 月 18 日:Steinberger 發文說「還在講 loop?已經進到 graph 了吧」,graph engineering 的討論擴散開來
- 8 月 5 日:日文解說Graph Engineering とは。8 月 13 日為Hexabase 的文章
把製作與檢查分開
登場的 AI 只有兩個:負責設計的 Claude Code,以及負責檢查的另一個 AI。
製作端負責生成,檢查端列出違規項目,製作端再裁定並修正。通過就交付實作;如果繞兩圈還無法收斂,就交回我手上。
如果用 graph 的語彙來說,職責就是 node,交接條件就是 edge,而我也是終端 node 之一。我只做了這些。
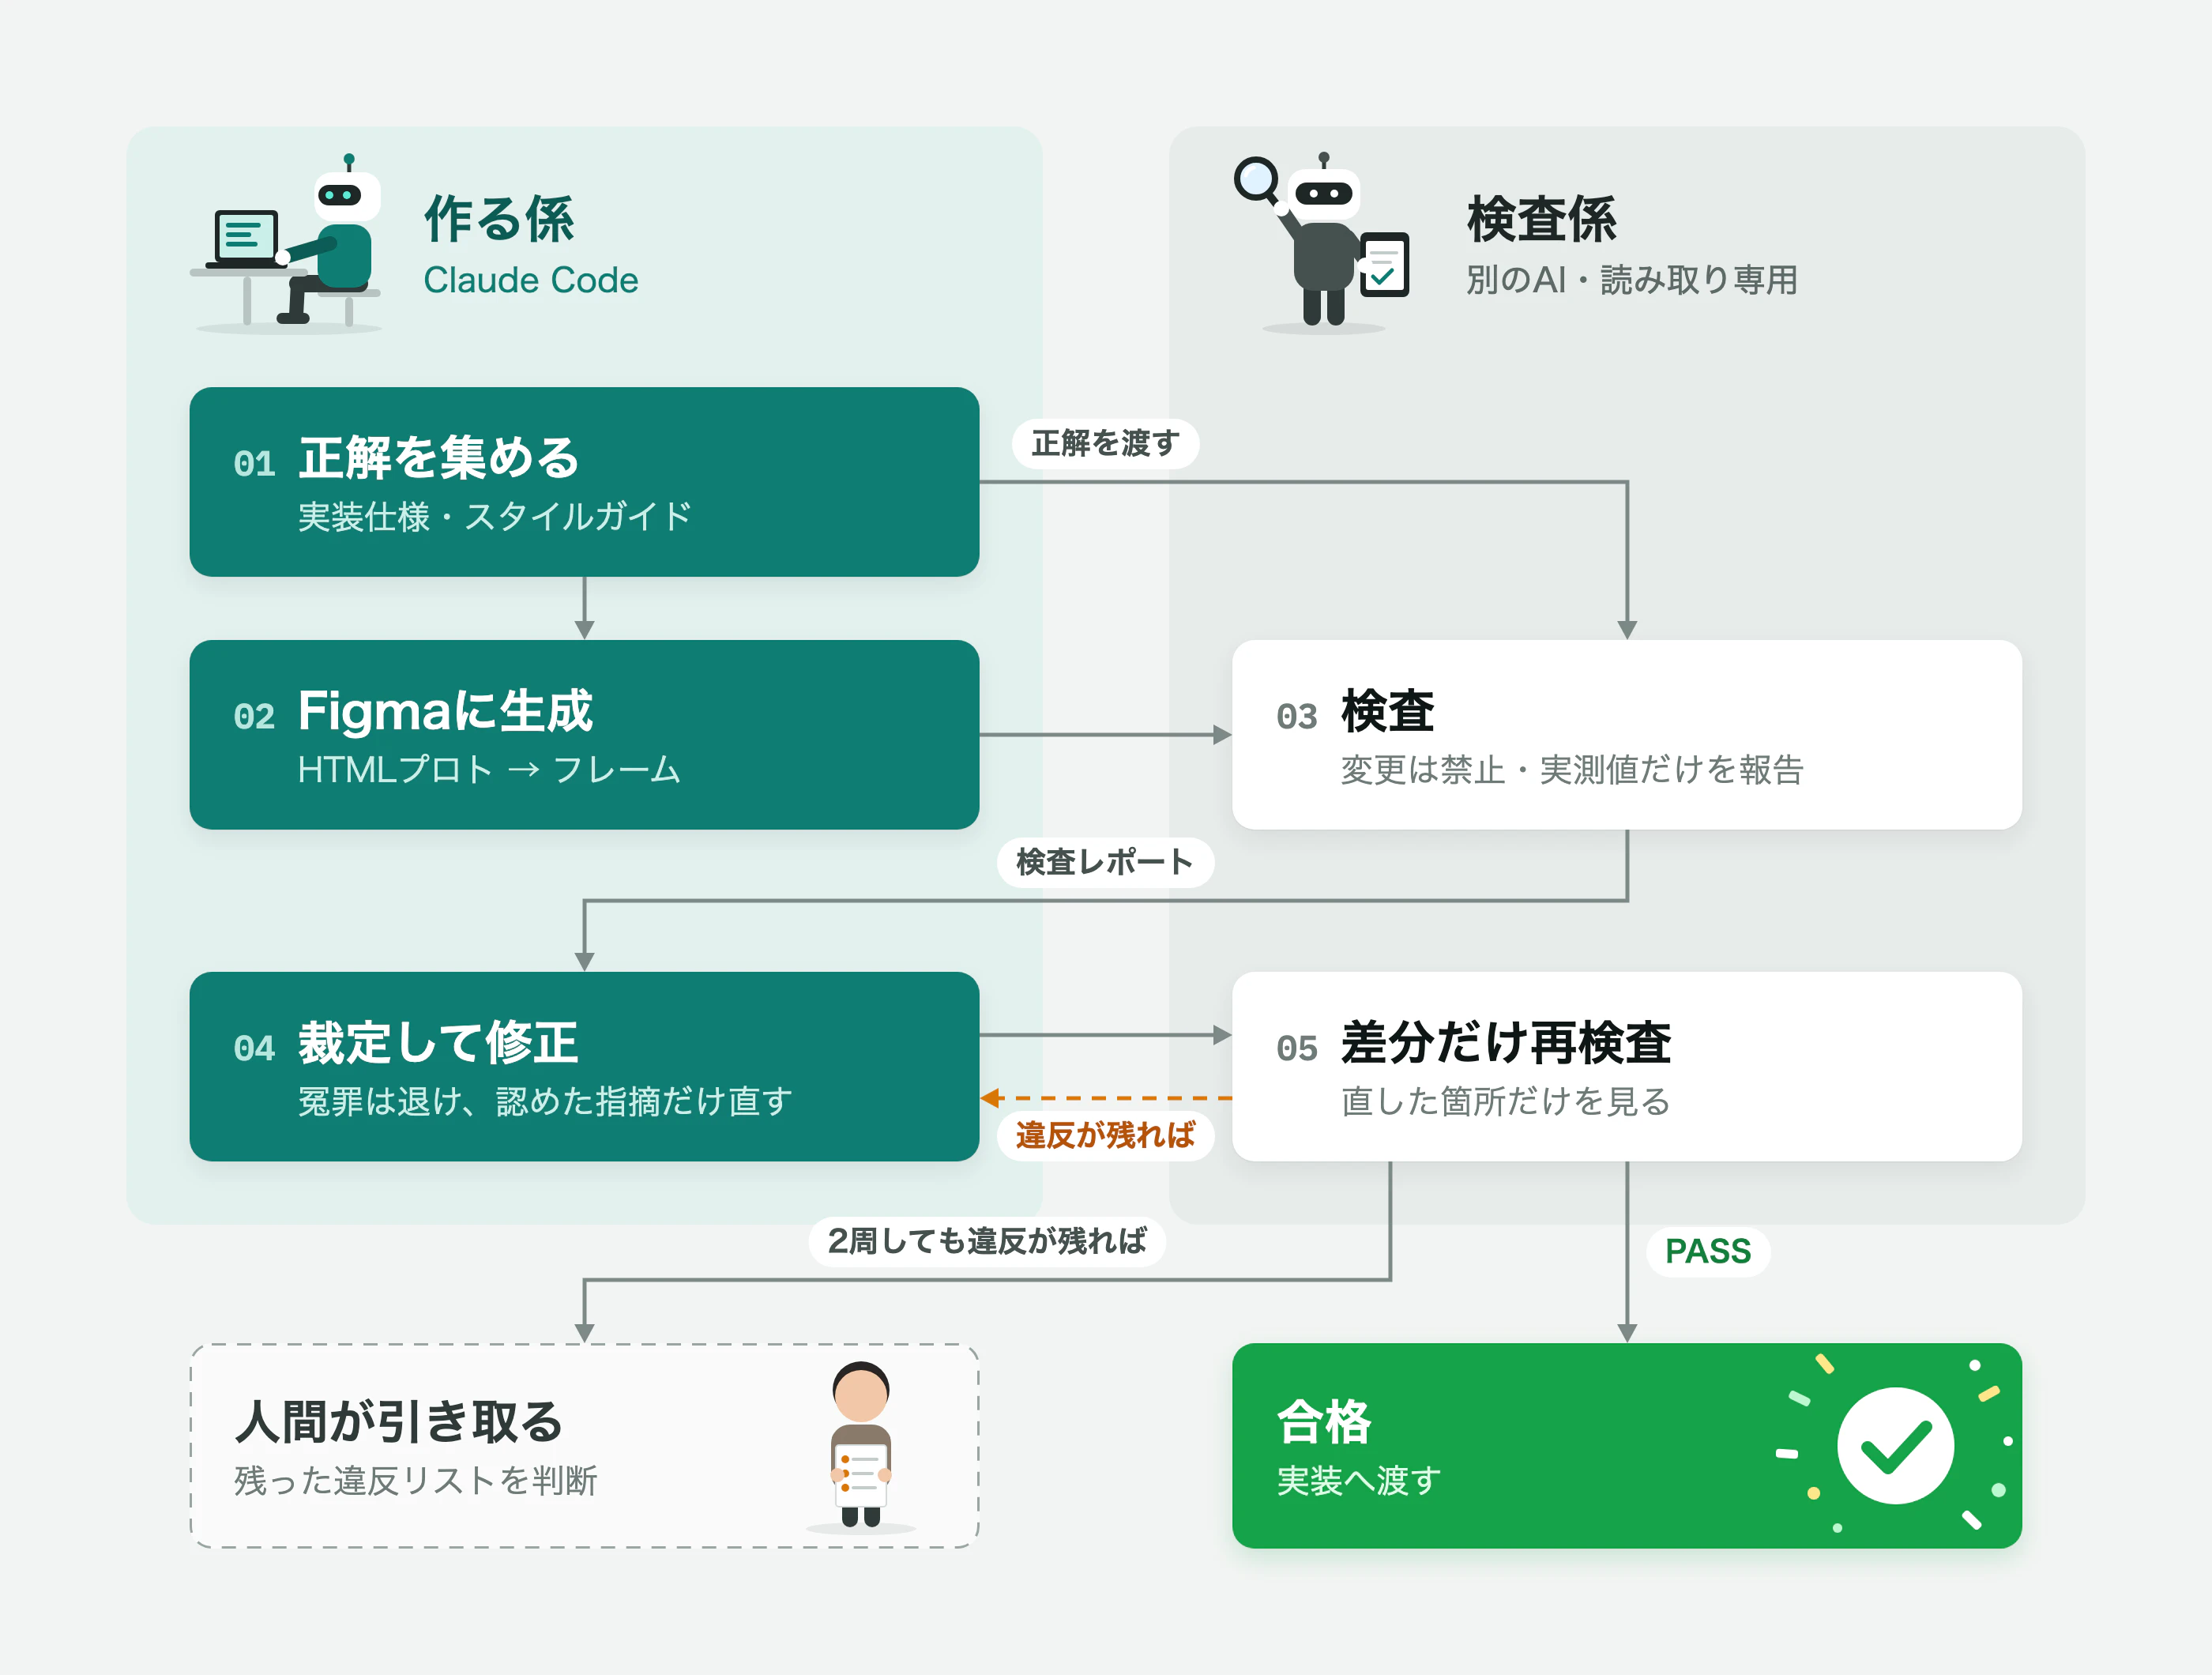
檢查端是獨立於製作該畫面的會話脈絡之外建立的另一個 agent。
給檢查端看的,只限於是否有綁定變數、是否是 instance、間距與圓角是否符合 token 值等可以機械判斷的項目。UX 好壞與美學判斷,依照前提仍由人類主導。
這個檢查端,我設了三條規則。
規則 1:檢查端不能直接修改
我禁止檢查端變更、建立或刪除檔案,只允許它回報。
每一條指摘都必須附上「對象、實測值、期望值」,並且只接受透過 Figma API 讀取到的實測值作為證據;不允許根據截圖外觀來判斷,也不允許寫「可能違規」這類推測。
規則 2:不要全盤照單全收檢查端的話
檢查端因為不知道前因後果,反而可以比較公平地看,但也正因如此,會誤判。
它可能把照著實作規格放的元素說成「規格裡沒有」,也可能把刻意貼近 prototype 的部分說成「跟實作不同」。甚至連實測值本身,也可能混入解讀。
照單全收後把畫面弄壞的例子
有一次它指控半透明填色「透明度疊了兩次」,我照著修之後,橫幅反而變成實心填色。其實只是變數端本來就帶有透明度,而 Figma 只是把它在畫面上鏡射顯示;同一份檔案裡其他地方也全都同樣的值。
所以,這些指摘會先交由知道前因後果的 Claude Code 裁定,分成「要修」與「要駁回」兩類。
我還加了一個步驟:在修正前,先在其他正常位置讀取同樣的屬性,確認它真的是離群值。被駁回的理由也會回報給我。
規則 3:兩圈內沒結論就交回人類
把指摘修正後,讓同一個檢查端只重新檢查差異部分。因為這比整份重看更快。
如果通過就結束;如果繞兩圈後還有違規,就停下來,剩餘違規清單交給我處理。
因為轉了幾圈都消不掉的指摘,通常不是機械修正,而是需要判斷的問題。

設計沒有 test
在程式世界裡,這類做法之所以能成立,是因為有 test 這種對答案的裝置。但設計沒有這種東西。
如果不把這一點補起來,就讓 AI 彼此檢查,最後只會變成一堆看起來很像那麼回事的指摘,實際上卻空洞無物。
Carlos E. Perez 把這稱為「有秩序的廢話(organized nonsense)」,而在解說 graph engineering 的這篇文章中,這被列為最棘手的陷阱。
所有 loop 都在看其他 loop,但沒有任何一個 loop 真的踩在地面上
— Carlos E. Perez(引自上文翻譯)
所以,如果要把 agent 的評估交給另一個 agent,就必須在系統外部準備一個決定性的證據。
我把 test 的要素替換成了以下內容。
如果用 test 來對照,我們的檢查就是:期望值是實作規格或 style guide 的描述;作為「正解」交給檢查端的是用 Figma Plugin API 讀出的實測值;「證據」則是這些可直接判定的事實,例如 fills 是否綁定了變數、padding 是否與 token 值一致。這裡不是感想,而是只要讀取就能判斷。
反過來說,那些就算讀了也無法分辨黑白的東西,也就是 UX 與美學判斷,我沒有放進這個檢查裡。把可替代 test 的部分,限定在外部能準備出確定性證據的範圍內,這就是把這套思路帶進設計時必要的改寫。
實際上我是怎麼操作的
工具組合很簡單。只要把 Claude Code 接上 Figma 官方的 MCP server,就能從對話中讀寫 Figma 檔案的 node(MCP 是把外部工具接到 AI agent 的規格)。
我們的方法是先用 HTML 做 prototype 固定外觀,再轉成 Figma 的 frame。
把 HTML 轉成 frame 的是 generate_figma_design,而執行 Plugin API 程式碼來讀寫 node 的是 use_figma。檢查端讀取實測值用的也是後者。
在生成階段,會把轉換後 frame 裡原生的矩形替換成設計系統元件,並將色彩與字體綁定變數。模型平常會視情況在 Fable 5.1 與 Opus 5 之間切換。
關於使用的模型
這個方法是在 Opus 5.5 出來之前做的,並且調整成即使不用 Fable、只用 Opus 5 也能跑。寫作期間 Opus 5.5 上線、模型本身能力提升後,檢查時的錯誤也變少了,清稿流程也更順。文章中的實測值,都是在 Opus 5.5 上線之前測得的。
雖然前面寫了 graph、node 之類的詞,但其實沒有用任何專用 framework。 需要的只有 3 樣東西:
- Claude Code 與 Figma 官方 MCP server 的連接
- 「檢查交給不共享脈絡的另一個子 agent,而且只能讀取」這個約定
- 作為「正解」的資料。如果沒有實作規格,style guide 或 design token 清單也足夠
在草稿做完後,透過下列指示就能實現。
請將 Figma 的以下 frame 整理到可交付實作的狀態(清稿)。
對象: https://www.figma.com/design/xxxx?node-id=10059-144587

■ 步驟
1. 先自己完成清稿。原生矩形請替換成設計系統元件的 instance,
   色彩、文字樣式、間距、圓角請綁定變數(token)。
2. 清稿完成後,請把檢查交給另一個子 agent。
   不要把這段對話的脈絡帶給這個子 agent。
3. 收到檢查結果後,逐條裁定「要修/要駁回」,並進行修正;若駁回,請寫明理由。
   在修正前,先在其他正常位置讀取同一個屬性,確認它是否真的是離群值。
4. 修正後,讓同一個檢查端只重新檢查差異部分。
5. 總判定若為 PASS 就結束;若兩圈後仍有違規,則停止並把剩餘違規清單回傳給我。

■ 檢查端指示中一定要包含
- 禁止建立、修改、刪除、移動檔案,只能回報
- 檢查觀點:
  A 排版配置(與既有畫面的資訊架構一致性)
  B token 遵循度(色彩、文字樣式、間距、圓角、gap。間距也一定要看)
  C 實作忠實度(以下實作規格視為正解)
  D 視覺品質(裁切、重疊、溢出)
- 證據只能是從 Figma Plugin API 讀到的實測值;不要根據截圖印象判斷
- 不要寫沒有實測依據的推測
- 輸出格式:[重要度] / 對象 node ID / 事實(實測值)/ 期望值 / 修正建議。最後附上總判定 PASS / FAIL

■ 正解(實作規格・style guide)
這裡把從實作程式讀出的規格,以及記載於 claude.md 的 design token 清單,當作正解。
我做的事情,其實就是把前一節的 3 條規則原封不動改寫成文字而已。
只是,每次都要手動寫這些很麻煩,而且也容易漏掉。實際上,我確實曾因為少了某個檢查觀點而吃過苦頭,後面一節會提到。
所以我把這整段指示直接搬進 Claude Code 的 Skill。Skill 是一份寫在 Markdown 裡、提供給 AI 的流程與判斷標準手冊。現在只要在草稿完成後這樣丟給它就好:
請透過檢查與改善 loop,將這個 Figma 檔案的 frame 清稿完成。上面那段很長的指示,全部都放在 skill 裡面,由 Claude Code 讀取並執行。「正解」資料也連同從實作程式萃取規格的步驟一起放進 skill。沒有 skill 的話,直接丟前面那一長版指示也可以做到同樣的事。
回傳的裁定報告裡,會列出被駁回的指摘與其理由。我只要看那一部分就夠了。
我不再檢查全部了
一旦有一次成功,就會想把任何東西都加上檢查。
但實際試過之後,我最後還是放棄了。
原因是等待時間和成本。
每跑一輪檢查,AI 的消耗量大約是 8 萬到 13 萬 tokens。這是以一個畫面大小實測得出的數字(這裡的 token 指的是 AI 讀寫文字的單位,不是 design token)。
如果連發想階段的畫面也每次都這樣跑,時間和 token 都會白白浪費。
現在我把原則定成:只有在交付實作前的清稿階段才跑。發想階段不需要全數檢查,因為細節在那個階段並不是重點。
不只是在清稿時,loop / graph 也有其他用法
除了逐畫面檢查之外,如果剛好接近 Claude 的每週使用上限重置,而額度還有剩,我也會把較重的工作一次丟出去。例如:「用 loop 形式檢查並修正整個頁面的 style 規則違反」、「從可用性角度檢查資訊架構,並輸出多種方案」這類工作。
這時我會把思考量調到 ultracode。這是一種在提高思考深度後,還能讓 Claude Code 自動組出多 agent 工作流程的模式;對單一畫面的清稿來說太重,但若是整個頁面要處理,就剛剛好。
比起 graph 本身長什麼樣子,更有用的是決定在哪個流程跑、在哪裡不要跑。
檢查裝置與評分標準要分開養
只有機制還不夠。若不把「什麼算有問題」交給檢查端,它就只會成為一個看得到東西、卻無法把它判成違規的角色。
今年 8 月,我就因此吃了苦頭。
不在檢查觀點內的東西,即使看得見,也不會被判成違規
我當時在檢查觀點裡放了色彩和字體,卻漏了間距。檢查端確實讀到了 padding 14,18,16,18 並且回報,但它只是把這件事寫成「事實」,沒有列成違規。結果有 47 張卡片的間距偏離 token,卻直接通過了。
這個評分標準,我已經寫進前面提到的 skill 裡了。
- 變數的綁定方式
- 元件的使用方式
- 過去踩過的失敗清單。每發現一個新失敗,就在這裡多加一行
由 node 的連線負責檢查,由 skill 負責定義「什麼叫合格」,這是一種分工。
不管 graph 的形狀設計得多巧,單一 node 的判定精度仍然是另一個變數。
把判斷基準寫到對話之外、並以 skill 形式保存的想法,同事的這篇文章也有更詳細的說明,可以一起參考。
試著把檢查改成並行
如果讓一個檢查端背負所有觀點,觀點越多,一次檢查就越重。
於是我試著把檢查端按觀點拆開,讓它們同時運作,再把結果彙整後交給裁定。這就是 graph engineering 語彙中的 fan-out 與 fan-in(分岔與匯流)。

我挑了一個剛交付實作的畫面,對同一個 frame 用兩種方式檢查:一種是把 3 個觀點交給 1 個檢查端,另一種是拆成 token 遵循、版面整合、元件規範 3 個檢查端。
因為這只是單一 frame、各做一次,所以以下請把它當作實例,而不是趨勢。
合併成 1 個/拆成 3 個
違規件數 21 件/130 件
消耗 tokens 18 萬/40 萬(2.2 倍)
實際時間 10 分鐘/8 分鐘(因為並行,所以只看最慢的那個檢查端)
件數差異其實沒那麼重要。拆開後的版本是把間距違規按屬性逐一計數,而合併版則是把相同內容收斂成 1 件。重點不是件數,而是內容不同。
只有拆開的版本才找到的東西
差異最明顯的是漏檢。
負責版面配置的檢查端發現,有一個 tab 的寬度被固定成 160px,導致議事錄格式名稱顯示成「営業向け(次アクシ…」,但右邊明明還空著 882px。
合併版沒有抓到這件事。光是漏掉還不算嚴重,但它在報告裡還這樣寫,並且直接宣告合格:
所有文字的繪製範圍(absoluteRenderBounds)都在 node 內。沒有因裁切而造成文字缺失
被截斷的字會變成省略號,所以只看繪製範圍時會以為沒問題。做出一套看似完整的檢查,然後看似完整地放行。 這正是前面提過的「有秩序的廢話」在本地端出現的樣子。
另外,按鈕卡進卡片 24px,以及某個 section 的內文只有一處向右偏了 4px,也都是拆開版才找到的。
合併版也有比較好的地方
我給的評分基準裡有兩項其實是錯的,而合併版自己把它們駁回了。
我寫著「卡片圓角是 12」,但這份檔案裡的卡片元件實測是 8,而且符合設計系統 kit 的反而是現況。這是它指出的內容。
token 担當的檢查端把同一個地方列為違規,並把判斷丟回給我:「如果規範正確,那就是綁定目標選錯;如果 8 才正確,那就是規範紀錄過時。」它沒有再去看職責外的元件實值,所以無法自己定論。
觀點拆開之後,也會有掉在邊界上的東西。像是 6 個 frame 名稱亂掉的案例,因為元件擔當只看「instance 名稱是否被覆寫」,所以只有合併版有抓到。
結論互相相反的地方
在某個 frame 上,合併版說「因為和元件名稱太像,所以改名」,元件擔當則說「這是已經 detach 的殘骸,所以應該恢復成 instance」。
像這種情況一出現,裁定就得回到人類手上。
在這一輪裡,拆開版的確漏檢比較少,但也讓裁定工作增加了。因為我把沒有脈絡的檢查端增加到 3 個,前面提過的「不要照單全收」也就跟著更重要了;而且消耗 tokens 也變成 2.2 倍。
前面提到的 graph engineering 解說文章,也有建議先從一條 loop、真正的驗證器與強制停止開始。
目前的折衷
只有在交付實作前的最後一輪才做並行;平常的周回仍維持 1 個檢查端。
說到底,真的需要 Figma 嗎
讀到這裡,應該也有人會想:都做到這種程度了,乾脆不要透過 Figma,直接生成程式碼不就好了嗎?
作為中介產物,Figma 或許已經不需要了,這樣的討論也確實存在。
對這個議題,我是中立的。 老實說,我也覺得沒有 Figma 也能做設計與開發,甚至也有「也許 Figma 已經不需要了?」這種感覺。
即使如此,我現在還在用 Figma,原因有兩個。
第一,是它方便任何人把資料和既有實作攤開來一起看,也方便個人發散想法,作為白板非常好用。
第二,是它可以直接手動調整細節,而不用一項一項叫 AI 去改。
就目前來看,像 Claude Design 這類工具,或是不經過設計、直接用 vibe coding 的形式,對這兩件事都還不太好處理。
考量目前的團隊狀況與自身能力,我認為把 Claude Code 與 Figma 組合起來是最好的,所以我仍然採用繼續用 Figma 的做法。
最終產品的品質與達成它的速度感,才是最重要的。
在這個前提下,如果有整體來看更好、而且不需要 Figma 的方法,我也希望能立刻採用。
所以,如果你是在用 Figma 維運設計系統,並且想減少在 Figma 上做設計與維護所花的時間,這篇文章可以當成其中一種方法來參考。
正在尋找能一起設計的人
我所屬的 Sapeet,除了 solution delivery 和產品開發之外,也日常在做這種「如何把事情交給 AI」的設計。
以開發脈絡來看,我感覺設計師、PdM、工程師之間的界線未來會越來越模糊。越來越多事情交給 AI 之後,「怎麼交辦」本身就會變成一項重要工作。
如果你覺得有趣,歡迎從徵才頁面聯絡我們 👇
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

