

你的 Codex 日誌檔案看起來沒問題,但你的 SSD 計數器不是這麼說的
那個檔案很小。
這正是關鍵。
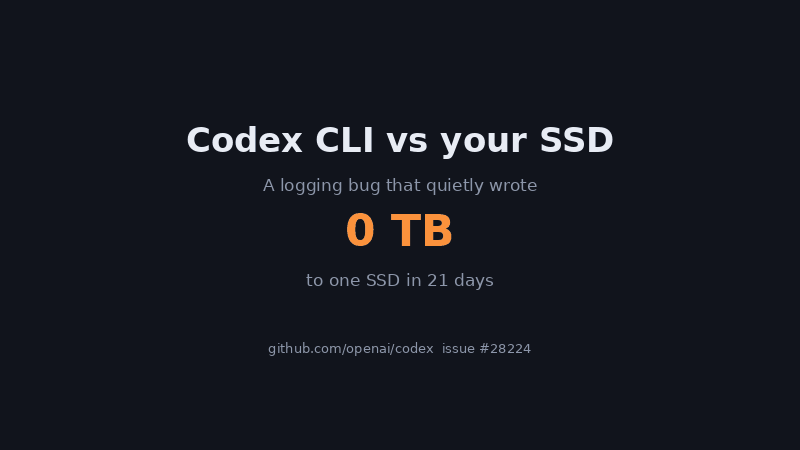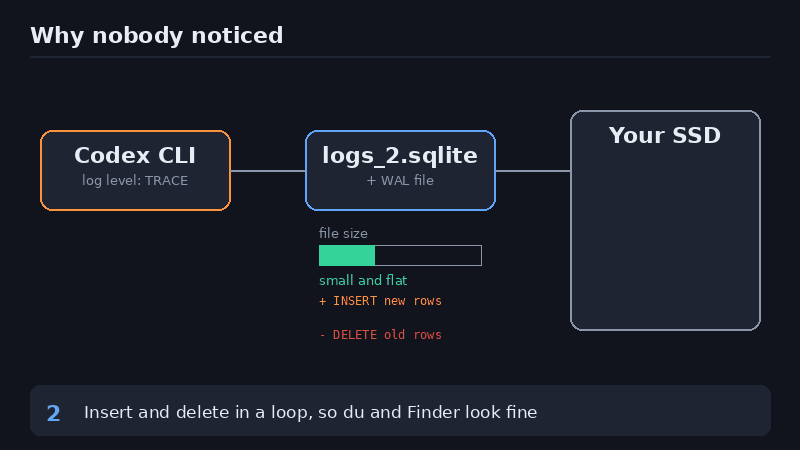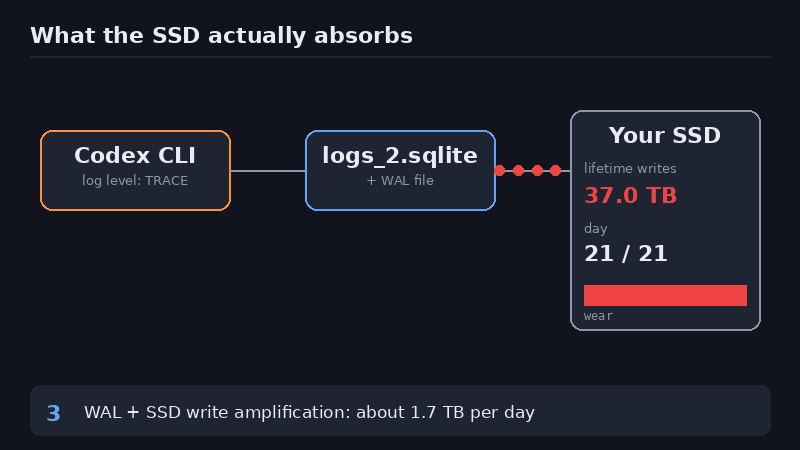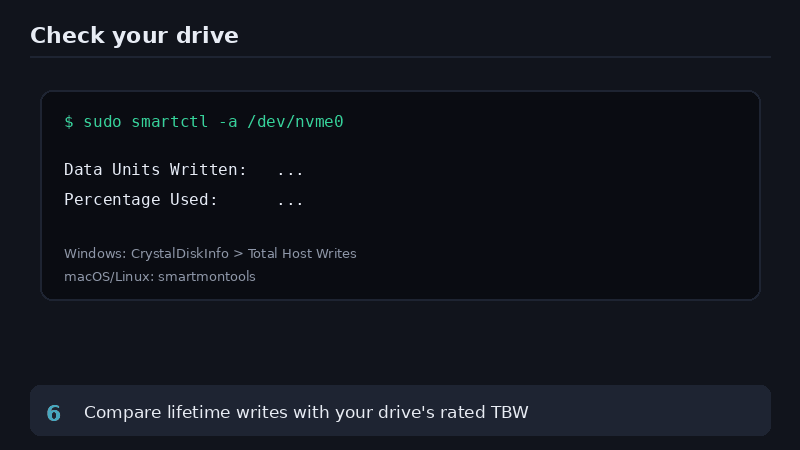
如果你打開 <code>~/.codex/</code>,會看到一個名為 <code>logs_2.sqlite</code> 的 SQLite 資料庫。它不大,也沒有吞掉整顆磁碟。Finder、Explorer、<code>du</code>,以及所有一般的儲存空間檢查,都看不出什麼異常。
與此同時,有位開發者的 SSD 記錄了大約 21 天內寫入 37 TB 的資料。
這相當於每天約 1.7 TB。如果把這樣的高負載、連續使用情境外推到整整一年,大約會是 640 TB。
這個數字並不是每位 Codex 使用者的預測,而是來自一台長時間運作的機器。但它揭露了一個很容易被本機開發工具忽略的問題:
檔案可以一直維持很小,但底下的儲存裝置卻會持續被不斷寫入。
這是一個關於吵雜 TRACE 日誌 sink、完全照指示工作的 SQLite 資料庫,以及單靠檔案大小根本看不見的 SSD 磨耗的故事。
快速摘要
- 有使用者回報本機磁碟寫入異常偏高,追查後發現與 Codex CLI 的 <code>logs_2.sqlite</code> 資料庫及其 WAL 輔助檔有關。
- 回報的機器在 21 天的運作期間累積了約 37 TB 的寫入。
- 這個檔案之所以維持有限大小,是因為新日誌持續寫入,同時舊日誌持續刪除。
- 回報的原因是過於冗長的 TRACE 日誌路徑,且未完全遵守預期的 <code>RUST_LOG</code> 覆寫。
- 這份調查指出,0.142.0 版本已大幅減少惱人的寫入量,早期測試回報約有 85% 更少的日誌寫入。
- 如果你曾經大量使用舊版,請先更新,再檢查實際寫入活動與 SSD 的累積寫入計數器。
讓人多看一眼的數字
21 天 37 TB,這不是一般「開發工具寫了一些日誌」會出現的故事。
| 測量專案 | 數值 |
|---|---|
| 回報的寫入量 | 約 37 TB |
| 回報期間 | 21 天 |
| 每日約略速率 | 約 1.7 TB/天 |
| 以此速率年化 | 約 640 TB/年 |
年化數字需要脈絡。它是假設每天都以相同工作負載持續一年,但真實情況通常不是這樣。短時間使用的人會少得多;長時間保持工具開啟、進行長會話,或把它用在自動化流程的人,則可能比自己預期的多很多。
重點不在於「每顆 SSD 都會在一年內壞掉」。
重點在於,這種程度的寫入活動已經屬於你應該注意並加以控制的等級。
<!-- 視覺放置:請在此放一張乾淨的 SMART 儀表板截圖,並將所有序號與可辨識的磁碟細節模糊處理。 -->
為什麼檔案大小幾乎沒有告訴你任何事
我們多半是這樣檢查磁碟問題的:
du -sh ~/.codex
ls -lh ~/.codex/logs_2.sqlite*
這些指令只回答一個問題:
目前存了多少資料?
它們不會回答這個問題:
過去一段時間內總共寫入了多少資料?
Codex 的日誌資料庫設計上,就是要保留一個有上限的診斷資訊量。新的資料列會被寫入,舊的資料列會被刪除,而資料庫大小可以大致維持不變。
所以,資料夾看起來很平靜,但磁碟其實一直在忙碌。
想像一家只有四張桌子的咖啡廳。中午你從窗外看進去,裡面坐著四個人。下午 6 點再看,還是四個人。桌子數量完全無法告訴你,是不是其實有八位客人來過,或者是八百位。
SQLite 檔案也是一樣。大小穩定,周轉卻極高。
到底是什麼在產生那些寫入?
回報的問題指出,有一條日誌路徑預設為 TRACE,也就是 Rust tracing 生態中最詳細的層級。
TRACE 日誌對於釐清特定故障很有幫助。它可能包含平常在日常使用時過於吵雜的低階事件,例如:
- 檔案開啟事件
- 原始網路或 WebSocket 活動
- 傳輸細節
- 遙測管線
- 被橋接到應用程式 tracing 系統的相依函式庫訊息
這份提供的分析估計,TRACE 等級的專案占了保留日誌內容大小的 70.7%。最高量的目標包括 WebSocket 處理、與 OpenTelemetry 相關的日誌、一般性的相依項日誌橋接,以及客戶端傳輸程式碼。
那是診斷用的廢氣。少量沒問題;但如果預設就持續把它存到本機 SQLite,那就是另一種工作負載了。
三個疊加在一起的部分
這個設計中的每一部分,單獨看都不一定是壞的。
1. TRACE 在本該採用 opt-in 的地方被啟用
TRACE 並不是一個適合長時間工具預設開啟的正常模式。它是你在主動除錯時才會打開的等級。
這份回報的行為是 Codex 初始化了一個 TRACE 等級的回饋日誌 sink。這會把每次常規互動都轉成大量診斷細節。
2. RUST_LOG=warn 並沒有完全讓它安靜下來
Rust 開發者通常會先這樣做:
RUST_LOG=warn codex這本來應該能把輸出音量調低。但根據這份問題分析,它並沒有完全套用到相關的 sink。若某個目標沒有明確覆寫,Codex 的內部預設仍然允許嘈雜日誌輸出。
這比明顯缺少設定更糟。使用者會以為自己已經降低日誌量,但磁碟仍然持續承受相同的寫入負載。
3. SQLite 把事件噪音變成儲存體 churn
SQLite 很優秀,但它不是魔法。
對於小型、結構化的本機資料,SQLite 是很好的選擇;但對於持續湧入的細粒度 TRACE 事件、插入、刪除、索引與 checkpoint,它即使不把資料庫變大,也可能產生大量寫入。
問題不是「SQLite 很爛」。問題是:把一個高寫入、會保留資料的迴圈,拿來當作本來就不該永久啟用之日誌等級的 sink。
作業系統不會直接告訴你的那一部分
這個故事裡有兩種放大量。
SQLite 寫入放大
SQLite 常常使用 WAL 模式,WAL 是 write-ahead logging 的縮寫。
簡化來說:
1. 一筆日誌事件會被附加到 WAL 檔。
2. SQLite 稍後把變更 checkpoint 到主資料庫。
3. 為了維持保留資料量上限,較舊的資料列會被刪除。
4. 期間索引與資料庫頁面也會被更新。
因此,一筆邏輯上的日誌事件,可能在檔案系統層面造成不只一次寫入。
WAL 本身沒問題,checkpoint 也沒問題。問題出在這個迴圈被持續不斷地餵入細碎、吵雜的事件。
SSD 寫入放大
SSD 內部也有自己的生命週期。
它以小頁面寫入資料,但會以更大的區塊進行抹除。當某個區塊的一小部分變更時,SSD 控制器通常會把新資料寫到新的位置,將舊資料標記為無效,之後再搬移仍然有效的頁面,並抹除舊區塊。
這種搬移叫做垃圾回收。磨耗平均分配會把寫入分散到各處,避免某個實體區域先磨損。
兩者都有其用途,也都意味著快閃記憶體可能承受比作業系統要求更多的實體寫入。
這個比例稱為寫入放大因子(write amplification factor)。實際數值會因硬碟、保留空間、可用空間、工作負載與控制器而異。這份分析沒有量測受影響硬碟的倍數,所以不要把任何臆測出的實體磨耗數字當作精確事實。
方向已經足夠:
高變動量、小型隨機寫入,是 SSD 最費力處理的工作負載之一。
640 TB 真的危險嗎?
有可能。
SSD 通常會有耐用度規格,稱為 TBW,也就是總寫入位元組數(terabytes written)。一般 1 TB 消費級 SSD 可能標示為幾百 TBW;企業級 SSD 可能高得多。實際數字取決於型號、容量、NAND 類型與保固條件。
這不代表 SSD 一到額定 TBW 就會立刻壞掉。這些數值是保固與耐用度指引,不是午夜一到就歸零的計時器。很多硬碟都能活得更久。
但一個背景開發工具可能消耗掉數百 TB 寫入,這仍然值得嚴肅看待。它可能在不把磁碟塞滿、也不出現明顯故障的情況下,就吃掉硬碟預期寫入預算中的很大一部分。
如何檢查你自己的機器
順序很重要。
先更新。再看真實 I/O。最後再檢查硬碟本身怎麼說。
第 1 步:更新 Codex
本文所附調查指出,0.142.0 是包含降噪寫入修正的版本。請先確認目前釋出說明與你已安裝的版本,然後先更新,再開始量測。
也請記住,Codex CLI、桌面應用程式與編輯器整合可能會以不同節奏發佈或內建元件。更新其中一個,不代表所有本機相關程序都已更新。
第 2 步:找出日誌檔案
在 macOS 與 Linux 上:
ls -la ~/.codex/logs_2.sqlite*在 Windows PowerShell 上:
Get-Item "$env:USERPROFILE\.codex\logs_2.sqlite*"你可能會看到資料庫本體、<code>-wal</code> 檔,以及 <code>-shm</code> 檔。
不要只看檔案大小就下結論。這次事件之所以容易被忽略,正是因為資料庫本身看起來很小。
第 3 步:監看實際寫入量
在 Linux 上,<code>pidstat</code> 可以顯示是哪個程序在寫入:
pidstat -d 5若要查看某個程序是否打開了該資料庫:
sudo lsof ~/.codex/logs_2.sqlite在 macOS 上,打開 活動監視器,選擇 磁碟 分頁,並在工作時觀察與 Codex 相關程序的寫入位元組數。
在 Windows 上,使用 資源監視器 或工作管理員的磁碟欄位。重點是看持續性的每程序寫入,而不是啟動時的短暫尖峰。
第 4 步:檢查硬碟自己的累積寫入計數器
這才是最接近真相的依據。
在 Linux 或 macOS 上,如果安裝了 smartmontools,NVMe 硬碟通常可以這樣檢查:
sudo smartctl -a /dev/nvme0請找以下專案:
- Data Units Written
- Percentage Used
- 警告或嚴重健康指標
在 Windows 上,CrystalDiskInfo 會顯示 Total Host Writes 與健康資訊。PowerShell 也能顯示部分裝置健康資料:
Get-PhysicalDisk | Get-StorageReliabilityCounter |
  Select-Object DeviceId, Wear, Temperature
將累積寫入量與你那顆硬碟的 TBW 規格比對。不要拿搜尋結果裡隨便一顆 SSD 的數字來比。
<!-- 視覺放置:請在此加入一張 SMART 頁面的加註圖片。只高亮 Data Units Written 或 Total Host Writes、Percentage Used 與健康狀態。 -->
如果我已經用舊版好幾個月了怎麼辦?
先不要恐慌,也不要只靠檔案大小猜測。
先看硬碟計數器。如果硬碟的 Percentage Used 很低,且總寫入量對它的年齡與工作負載來說合理,那就更新後繼續使用即可。若硬碟磨損異常偏高、有警告,或寫入量相對於 TBW 額定值已經很大,請先備份重要資料,並在故障逼近排程前規劃更換。
即使你的硬碟看起來健康,這也很適合提醒自己做一次備份。SSD 通常是在沒有太大戲劇性的情況下突然出問題。
如果暫時無法更新,可先用的權宜作法
更新才是正解。以下只是暫時降低持續寫入壓力的方法,讓你有時間安排更新。
把可丟棄的日誌放到暫存儲存空間
對 CI 工作與容器來說,最乾淨的方法通常是使用暫時性的家目錄,或把相關設定目錄掛載到暫存儲存空間。
例如,對可丟棄的 CI 環境可以這樣:
export HOME="$(mktemp -d)"若是容器工作負載,且環境可接受在工作結束後失去本機診斷資料,則可將 tmpfs 掛載到適當的 Codex 狀態目錄。
這對於本來就會建立並銷毀環境的建置執行器特別有用。
小心 /tmp
把日誌檔移到 <code>/tmp</code> 只有在你的環境裡 <code>/tmp</code> 確實是記憶體支援的檔案系統時才有用。在許多 Linux 系統上它可能是 tmpfs;但在 macOS 上,<code>/tmp</code> 預設並不是自動的 RAM disk。
在假設寫入負載消失前,先檢查掛載點:
mount | grep ' /tmp '接著再用真正的 I/O 監視工具確認。不要因為某個留言串裡看起來合理,就相信某個權宜作法真的有效。
除非真的必要,否則不要做不受支援的資料庫手術
有些社群權宜作法會修改 SQLite 日誌資料庫,讓插入操作被忽略。緊急時這可能有用,但這屬於對內部應用程式檔案的不受支援修改。
未來版本可能會更改 schema,或假設資料庫維持正常行為。如果你決定這麼做,請先停止 Codex、複製一份資料庫、記錄你修改了什麼,並在修正版釋出後移除這個權宜作法。
對工具開發者來說,更大的教訓
這個 bug 不只是一個 CLI 的問題。
量測的是寫入位元組數,不只是用了多少磁碟空間
每一個本機持久化功能,都應該在真實使用情境下有 I/O 預算。請測試每小時、每會話、每天寫入了多少位元組。對資料庫、快取、索引或日誌輪替系統來說,檔案大小不是足夠的指標。
TRACE 必須是刻意選擇
詳細日誌需要明確 opt-in,並且要有清楚的退出方式。若預設就把它送出,等於讓每位使用者都變成除錯環境。
標準控制項必須端到端生效
如果你的生態系有標準的日誌覆寫機制,就必須對每個 sink 都生效。部分覆寫很危險,因為它會讓有經驗的使用者產生錯誤的安全感。
結構化日誌有儲存成本
SQLite、RocksDB、本機搜尋索引與快取都是好工具,但高頻率寫入是有成本的。設計上需要背壓、批次處理、速率限制、保留規則,以及對異常冗長情境的測試覆蓋。
隱私與磨耗其實有關聯
工具記錄的原始操作細節越多,寫入越多,也越可能保留越敏感的本機資料。記錄檔案路徑、原始傳輸框架與低階事件負載,應該是刻意的除錯選擇,而不是背景噪音。
對使用者來說,更大的教訓
有一個很值得保留的簡單習慣:
安裝一個新的長時間執行開發工具時,先看一次它的寫入速率。
在活動監視器、資源監視器或 <code>pidstat</code> 裡花兩分鐘,就能抓到不少意外狀況。
偶爾檢查 SSD 的累積寫入量。保持工具更新。把穩定的檔案大小當成儲存量指標,而不是 I/O 指標。
日誌檔案很小,但它讓 SSD 做的工作並不小。
已確認的部分,以及仍不確定的部分
這份調查對其限制說得很清楚,而這些限制很重要:
- 37 TB 的測量來自一位高負載使用者的機器。它是一個資料點,不是普遍速率。
- 關於最高日誌詳細度何時開始,回報之間存在分歧。確切起始日期仍不確定。
- 年化成 640 TB 的數字,是根據回報的 21 天樣本做的算術推估,不是預測。
- SSD 寫入放大是真實存在的,但這起事件沒有量測實際的 NAND 實體倍數。
- 版本 0.142.0 後觀察到的 85% 降幅,是早期觀測結果,不保證每個平台或工作負載都一樣。
這些不確定性並不削弱主要結論。正確的回應仍然很簡單:更新、量測程序,並檢查硬碟計數器。
來源與延伸閱讀
- openai/codex 的 GitHub issue #28224
- OpenAI Codex 官方文件
- 本文所依據的公開報導與技術分析,包括 Notebookcheck、Windows Report、Lilting.ch、yage.ai,以及 Daniel Vaughan 的撰文
原文出處:https://dev.to/varshithvhegde/codex-was-torching-your-ssd-and-nobody-noticed-for-months-4c5h
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式


