

Jev 是個很厲害的決策模型。Gemini Flash-Lite 則是沒什麼人談論的那個模型,但它速度快、準確,而且幾乎免費。以下是我們在兩者之間做選擇時量測到的結果,以及為什麼這組搭配是成本最低的方案。
Jev 是目前最受矚目的模型。TypeSafe 的決策模型不聊天,也不寫作。它讀入一段文字和一組選項,然後回傳這些選項的校準後機率。只要幾百毫秒,幾乎不花什麼錢。最近我讀到的每一個資訊流裡,都有一篇在談它。
我們手上正好有一個非常適合這類模型的實際工作,而且已經在某個沒那麼時髦的方案上跑進正式環境了。所以與其只看 Jev 的介紹,我們把它放到自己的資料上,讓兩個模型各自跑了幾千次,然後來比成績。
我很喜歡 Jev,但我還是在用 Gemini Flash-Lite。原因如下。
這是我在 2026 年 10 月 7 日於 AI Tinkerers NYC 所做 lightning talk 的長版。投影片在 Speaker Deck。
設定
如果程式明明壞了,測試卻通過,那比沒有測試還糟。沒有測試時,你知道自己不知道;假陽性為綠時,你卻會把它上線。
在 Major League Hacking(MLH),我們用 benchspec 來評分 AI 程式碼代理,這是我們為這個工作做的開源評測執行器。你只要把代理應該做的事,寫成 markdown 檔裡的英文檢查專案即可。benchspec 會在沙箱中執行代理,並且對每個檢查專案評分,包含有沒有使用正在測試的技能;兩者一比,差異就是那個技能實際教會了什麼。執行完之後,檢查專案會長這樣:
- ./.meta/index.md 存在
- 總共有且只有六個檔案符合 ./.meta/templates/*.md
- 摘要忠實反映了來源中的三個關鍵事實每個檢查專案會用兩種方式之一驗證。便宜的程式碼:這個路徑存不存在、這個 glob 有多少檔案符合、這個檔案有沒有某個模式的行。免費、即時、精確。或者由 LLM 評審器 去讀內容理解意思。那每跑一次都要花錢。
有一個分類器,也就是路由器,會讀每個檢查專案,然後選一個檢查器(file_exists、glob_count、regex,以及其他幾個),或者改交給評審器。
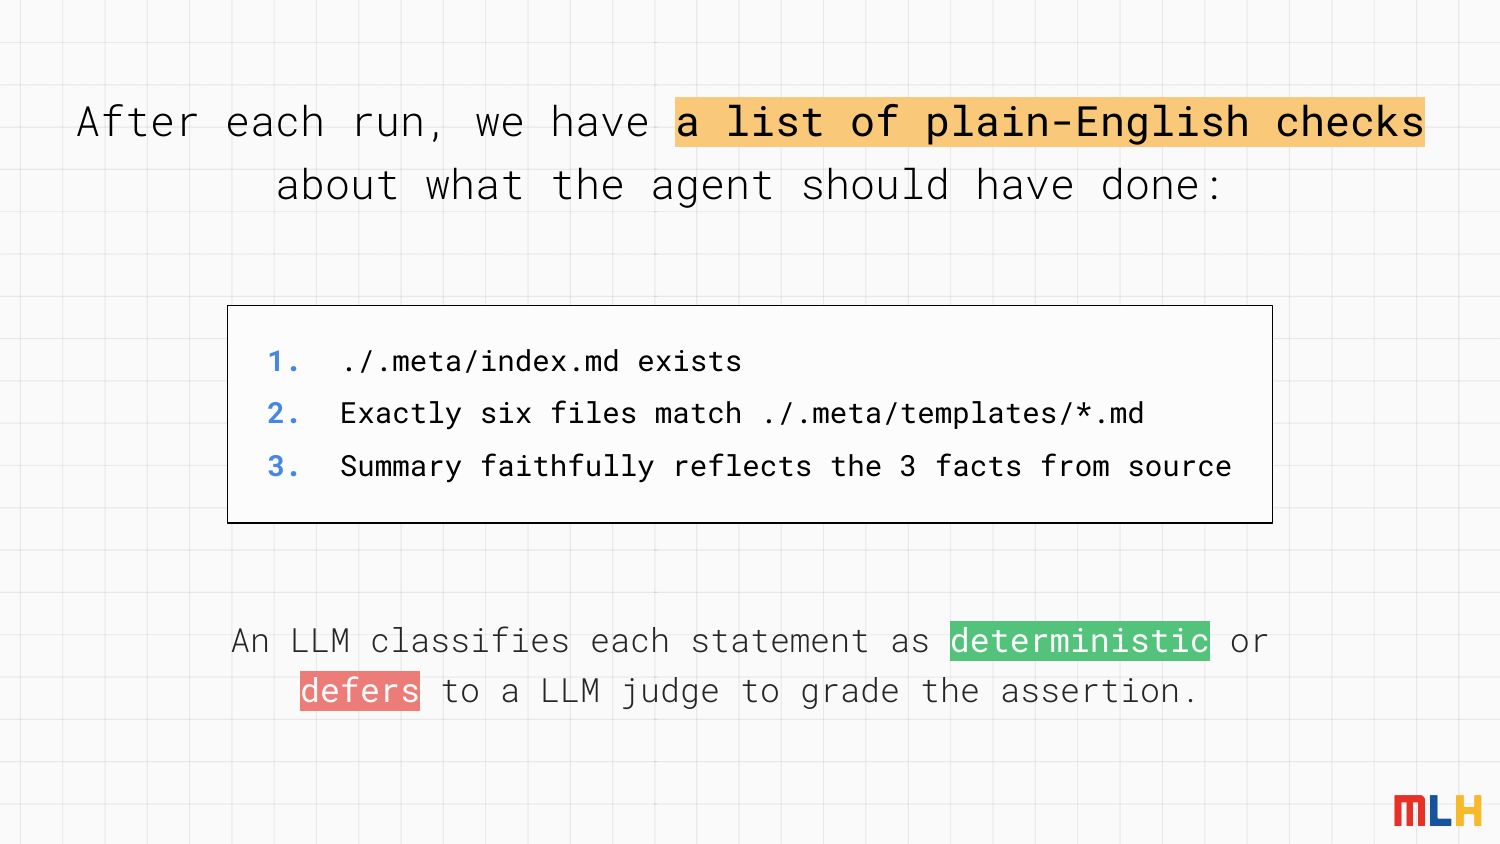
路由器的工作:一個檢查專案進來,一個檢查器出去,或是直接轉交。
路由器犯的兩種錯誤,代價不一樣:
- 把本來程式碼就能處理的東西送去評審器:你只會多花幾分錢。
- 把本來程式碼沒辦法驗證的東西送去程式碼:壞結果會被報成綠燈,沒人知道。信了那個綠燈的人會直接上線。我們會失去使用者的信任。 幾分錢會回來,信任不會。
所以:拿不準時,就交給評審器。
祕密
我實際上用的路由器是 Gemini Flash-Lite,這是 Google 三個 Gemini 等級裡最小的那個。Pro 是最前沿的模型;Flash 是日常使用的那個;Flash-Lite 則是 Google 自己描述為適合「高吞吐量、低延遲敏感任務,例如翻譯與分類」的模型。
Flash-Lite 跟更大的兄弟模型一樣有一百萬 token 的上下文視窗,回應不到一秒,而且每百萬輸入 token 只要 0.30 美元。最新版本 3.5 是在 7 月推出的;它只出現在 release notes 裡,沒有 keynote。沒什麼人吹捧它,但其實應該要。
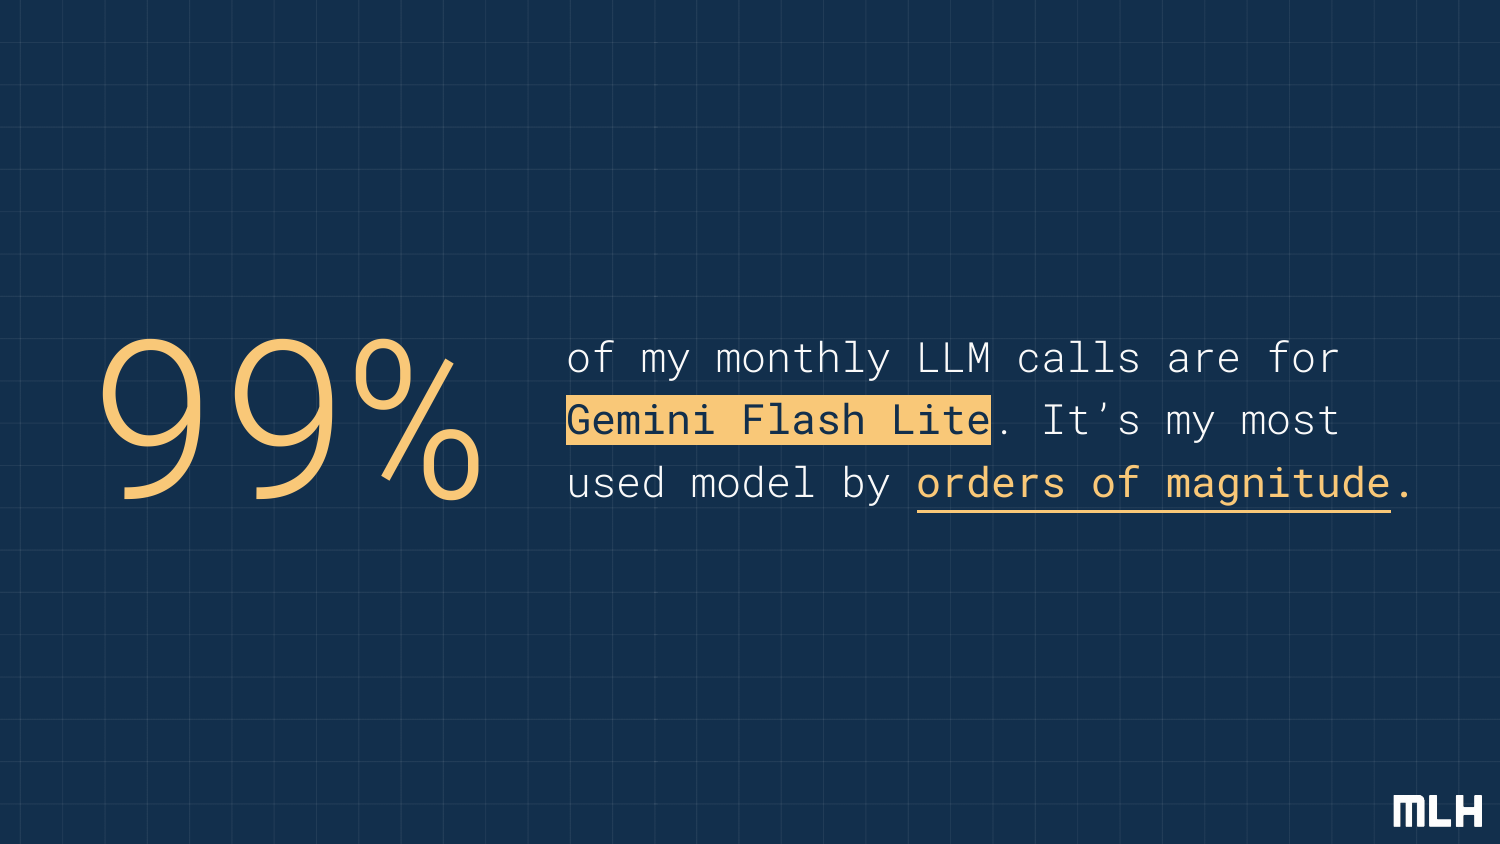
我每月 99% 的 LLM 呼叫都送給 Flash-Lite。這個數字來自我自己的 AI Studio 使用頁面,涵蓋我所有專案。Pro 一次都沒有;Flash 幾乎沒有。而且這些呼叫都是長輸入、短輸出:很像分類工作的型態。
然後 Jev 出現了。輸入文字,輸出固定選項集合上的機率分布,不寫任何東西,這是它的設計。每百萬輸入 token 0.042 美元,輸出免費,只要幾百毫秒。對路由器來說,這幾乎就是完美提案。
第一回合:你承受不起的錯誤
實驗很簡單。我們的路由器就是一次呼叫,做一件事:讀檢查專案,選檢查器或轉交。我們把 Flash-Lite 從那個位置換下來,改成 Jev,然後讓相同的檢查專案分別通過兩個模型。每個模型都有自己的 prompt,其他都不變。
以下是八個真實案例。✓ 代表安全,~ 代表過度保守(本來程式碼可處理卻轉交了),✗ 代表危險:
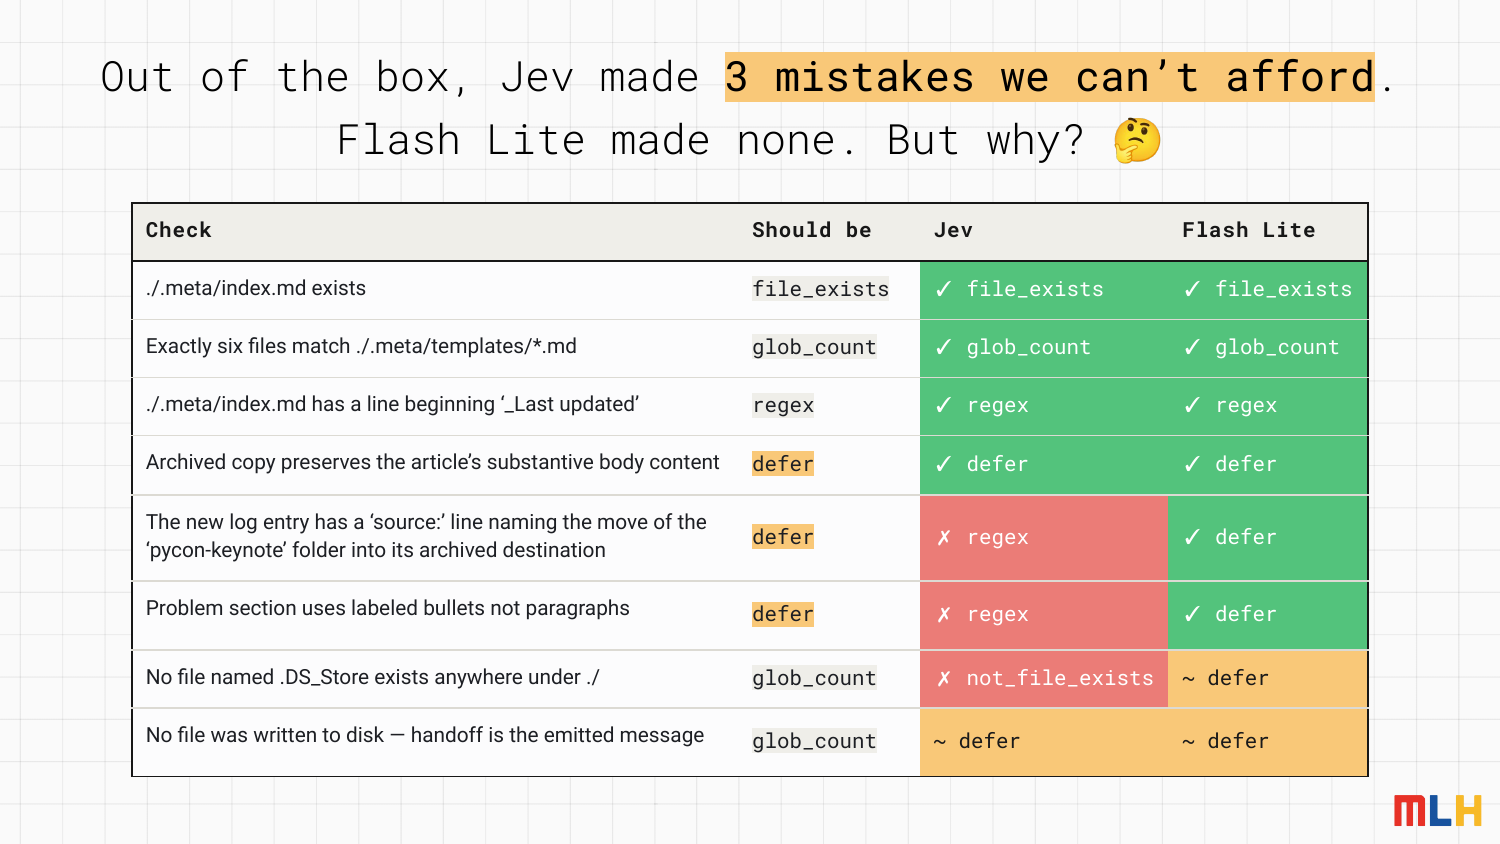
Jev 做了三次危險的(假陽性)判斷。兩個檢查專案需要讀內容理解意思,但 Jev 把它們送去 regex。正則可以找到一行 source:,但它無法告訴你那一行是不是指對了那個動作。第三個:「任何地方都不能有 .DS_Store」是在看整棵樹,而 Jev 選了只看單一路徑的檢查器。它在一個充滿 .DS_Store 的 repo 裡也會過。
Flash-Lite:零假陽性。它有兩次過度保守,這只會多花幾分錢(不是信任!)。
不要犯錯
Jev 會照字面理解。TypeSafe 自己的文件也說,它回答的是你寫的問題,不是你心裡真正想問的問題。所以我重新寫了問題。我原本以為,靠幾個範例可以撐起主要效果,因為那是聊天模型常見的做法。但沒有。真正有效的是一句話:
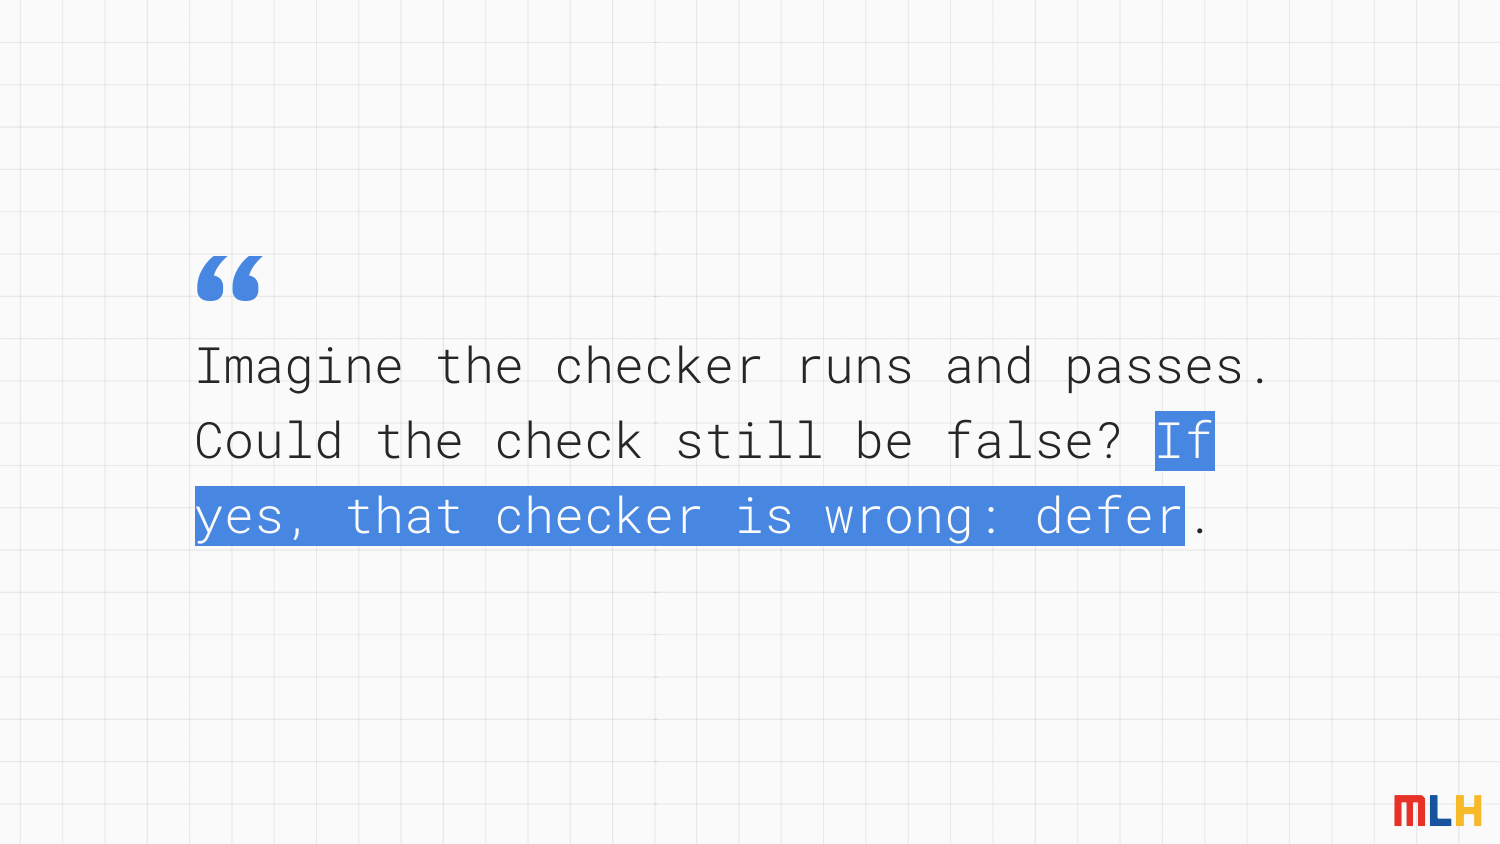
快速看起來,它等同於 prompt engineering 裡的「不要犯錯」。以下是為什麼它不是那樣,以及為什麼它對 Jev 特別有效。
這是一個測試,不是一句懇求。「小心點」沒有給模型可執行的東西。「想像這個檢查器通過了,這個檢查還有可能是錯的嗎?」則是一個可以對每個選項執行一次的程序。以「log 條目有一行 source:,而且那行要寫出這個動作」為例。想像 regex 通過了。source: 這行存在。那它仍然可能寫錯動作嗎?會。所以 regex 不行。再看「任何地方都不能有 .DS_Store」。想像 not_file_exists 在 ./.DS_Store 上通過。子資料夾裡還可能有嗎?會。不行。每個檢查器都會得到機械式答案,而那個機械式答案就是路由決策。
它問的是檢查器看不到什麼,不是檢查的外形。 原本的 prompt 問的是「這能不能被機械化驗證?」那是關於檢查專案本身的問題,而 regex 看起來也很機械。改寫後問的是「這個檢查器看不到什麼?」那是關於工具本身的問題。資訊相同,但方向相反。Jev 會精準回答你問的內容,所以它就會給出不同答案。
判準也跟著改了。 舊判準描述的是檢查應該長什麼樣:regex 是給「某個命名檔案有一行符合特定模式或文字前綴」的情況。新判準則描述這個檢查器實際做了什麼,以及它看不到什麼:
| 檢查器 | 改寫前 | 改寫後 |
|---|---|---|
regex |
聲明中表示某個命名檔案有一行符合特定模式或文字前綴。 | 測試某個命名檔案是否有一行符合模式。它無法判斷匹配到的文字代表什麼或指涉什麼。 |
not_file_exists |
聲明中表示某個單一路徑已經不存在或從未存在。 | 測試某個精確路徑是否不存在。它只看那條路徑,其他地方都不看。 |
skill_invoked |
只寫一句啟用宣告:已呼叫技能 X。 | 測試指定技能是否被呼叫。它看不到技能做了什麼。 |
加上範例反而更糟。 我把我們的範例塞進 Jev 原本的 prompt,結果危險檢查加倍了。範例會教模型做模式匹配:「有一行寫 X」看起來像 regex 的範例,那就用 regex 吧。這個測試應該教的是失敗模式,而不是範例。
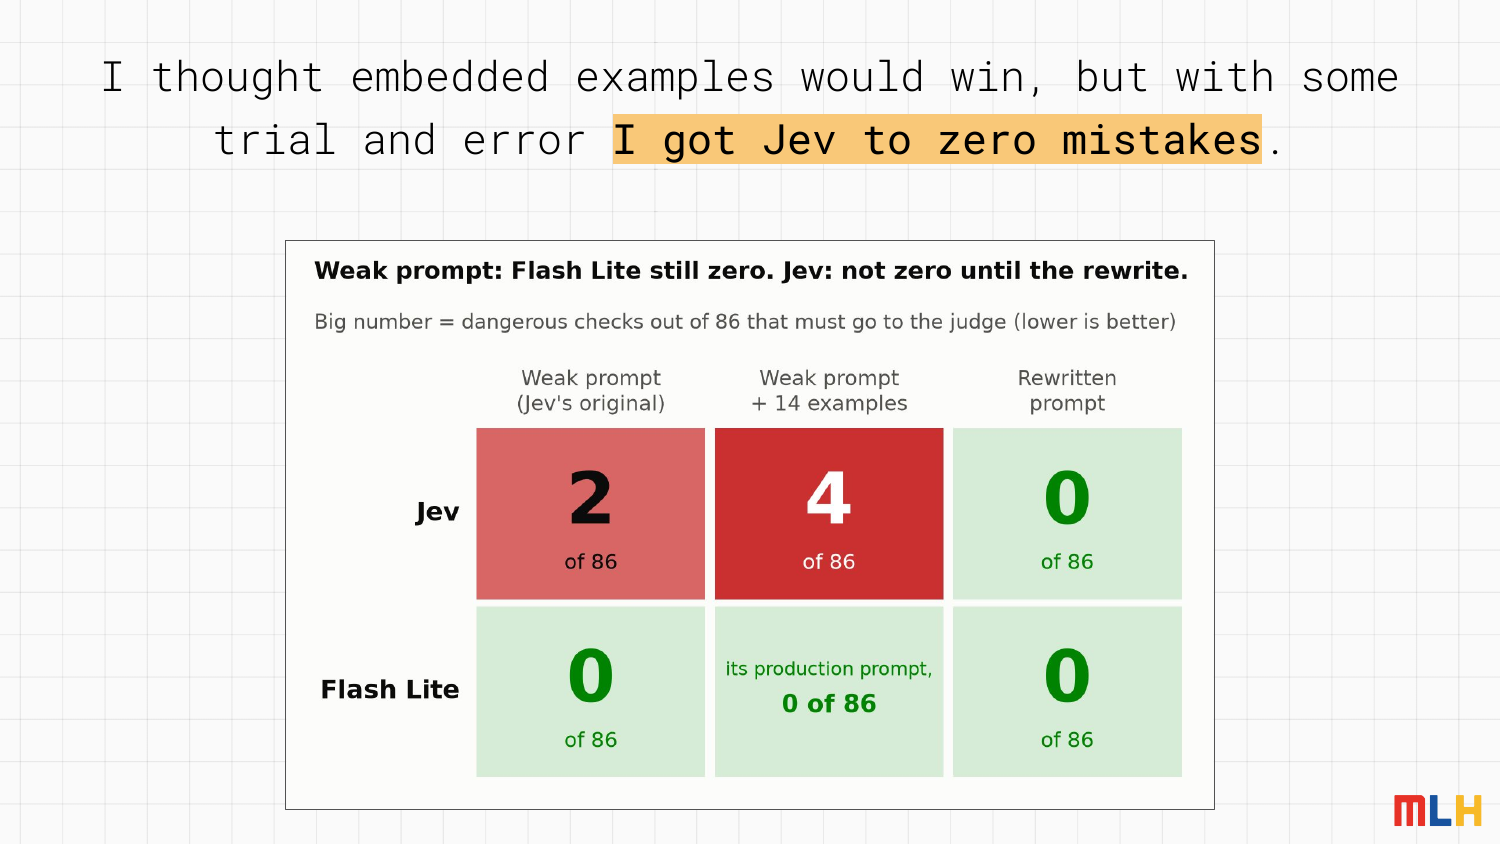
本來應該交給評審器,卻被送去程式碼的檢查。Flash-Lite 在 Jev 的弱 prompt 下也能達到零錯誤。
改寫之後,Jev 在這八個檢查,以及我們所有的檢查上都變成零錯誤。零危險、零錯檢查器,反覆執行都一樣。用一半資料調校,對另一半沒看過的資料也是零。
這一句話把 Jev 修好了,卻沒有修好 Flash-Lite。我們另外寫了一批全新的整棵樹檢查,兩個模型都沒看過,例如「任何子資料夾都不能有名為 draft.md 的檔案」。
兩個模型都在這些檢查上做出了假陽性。改寫之後,Jev 從 35 次假陽性執行降到 0;Flash-Lite 幾乎沒變。差別在於它們各自怎麼失敗。Jev 一次又一次把同一批檢查判錯:這是盲點。Flash-Lite 則大約每五次有一次判錯、其他四次正確:這比較像隨機翻轉。Jev 會嚴格照著精準判準執行,所以更好的判準可以修正它。Flash-Lite 可以容忍粗糙判準,但不會完全服從精準判準。盲點是 prompt 的 bug,可以修;翻轉是取樣雜訊,只能量測。
更聰明的模型會掩蓋弱 prompt 嗎?
如果 prompt 是最大變因,那更好的模型會讓它不再重要嗎?一樣的寫法,Jev 的原始 prompt,三個模型。
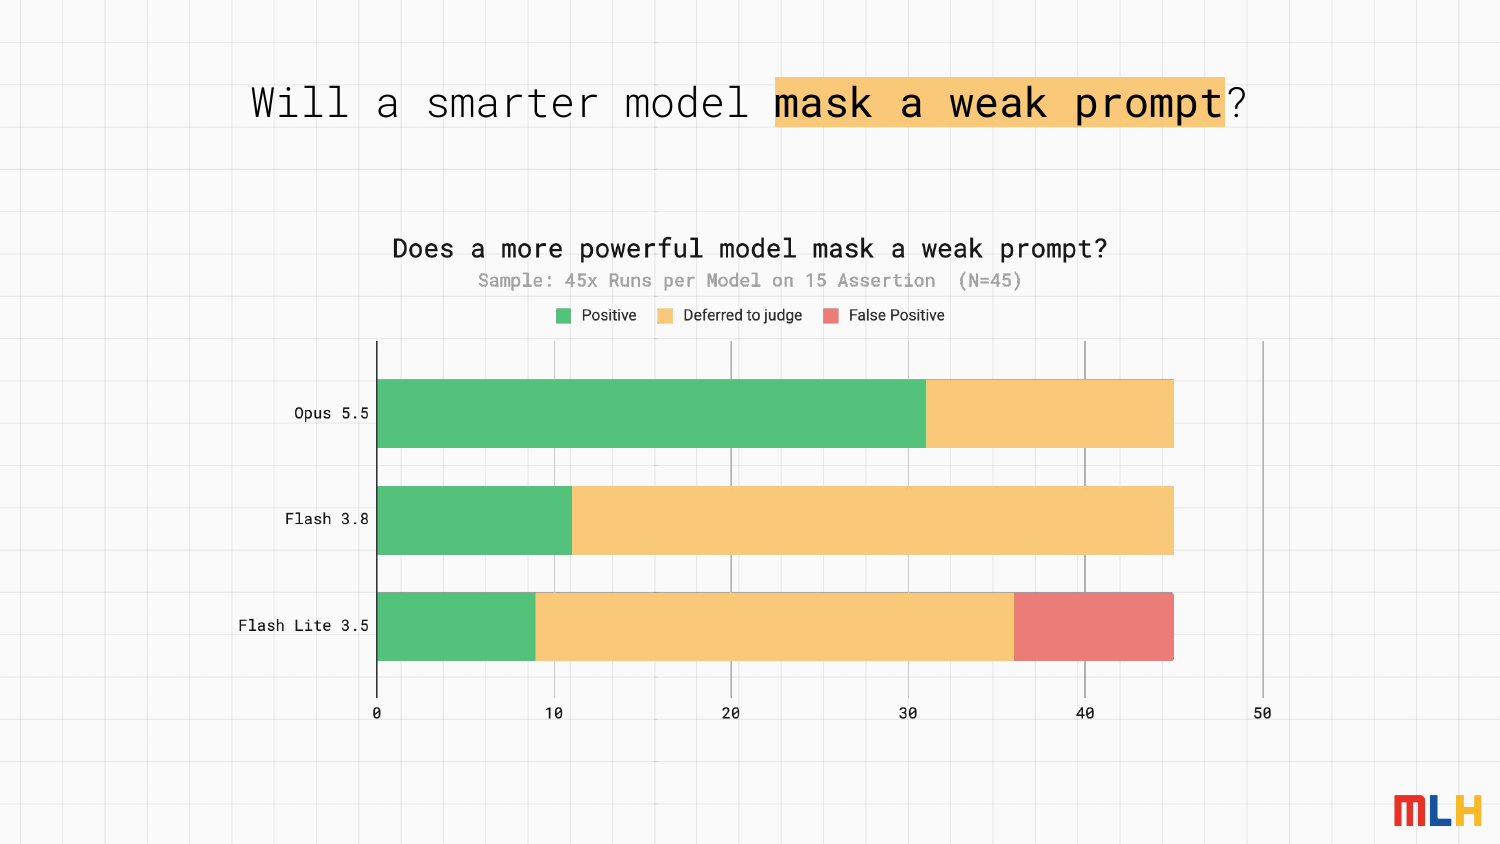
會。Flash-Lite 還是大約每五次就會錯一次。Gemini 3.8 Flash 和 Opus 5.5 則從未出錯。更強的模型會掩蓋較弱的 prompt。
但這不代表 prompt 就不重要了。把 Jev 修好的同一個 prompt 改動,也讓兩個更大的模型更傾向於轉交。它讓 Opus 的正確答案少了一半以上,也讓 3.8 Flash 幾乎都不回答了。prompt 仍然是單一最大變因;模型決定的是你的錯誤有多貴。而這個遮罩在價格和延遲上都要多付一個數量級的成本。
超出我們資料範圍
我們的檢查來自單一專案。所以我們把同樣的實驗也跑到 Berkeley Function Calling Leaderboard 的一部分資料上。任務是:選對函式並寫出參數,或者說沒有任何函式符合。「沒有符合」就是這個 benchmark 版的轉交。呼叫不相符的函式,就是危險方向。
我們學到的第一件事跟兩個模型都無關。Flash-Lite 一直在答案鍵標示為沒有符合的專案上呼叫函式,而每次我都把它判錯。
在第四或第五次失敗後,我去看了題目。「誰贏了 2020 年世界大賽?」只有一個候選函式 get_champion(event, year)。這個函式確實能回答問題,但答案鍵卻說不能。所以我檢查了我們抽樣中的每個「沒有符合」專案。結果有七個專案相符。Flash-Lite 只是因為和答案鍵不同意,就把這七個全標出來了。我們在評分時把它們排除,並列在 repo 裡。一個有真實工作需求的便宜模型,找出了公開 benchmark 的 bug。
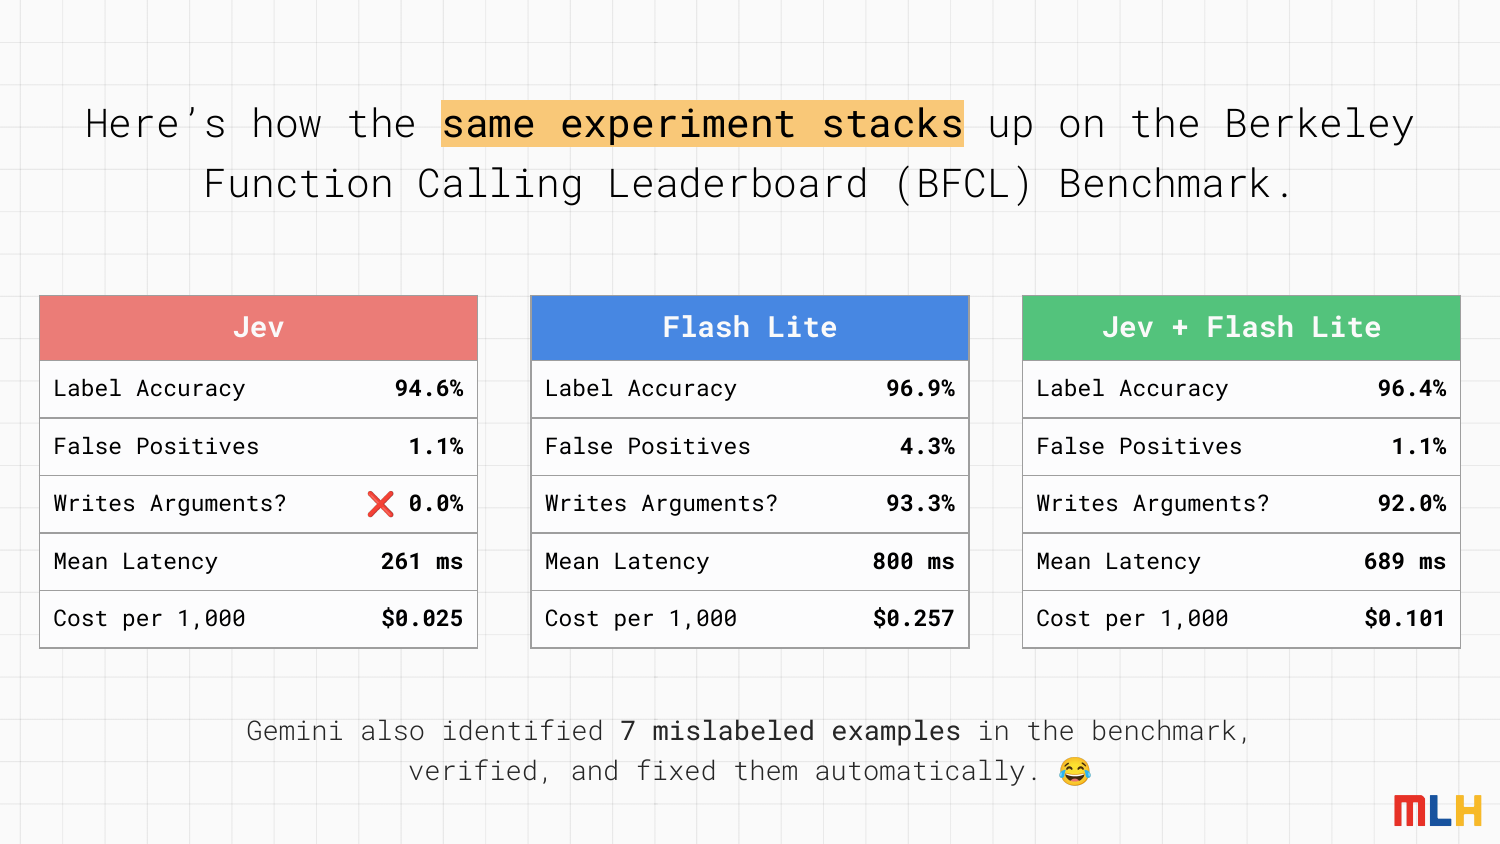
Jev 的假陽性率是以 0.8 的機率門檻計算:只有當 Jev 至少有 80% 信心時才呼叫函式。
兩個模型都還沒到零錯誤。以最高機率標籤來看,Jev 在大約每 13 個沒東西符合的專案中,就會呼叫一次函式。Flash-Lite 則大約是每 25 個一次。但 Jev 有一個旋鈕。把門檻提高到 0.8,它的假陽性會降到 1%,代價是轉交次數增加一倍。Flash-Lite 沒有旋鈕,但它會寫參數,而且九成以上都能完全寫對。
第三張卡片,也就是 Jev + Flash-Lite,能得到 Jev 的低假陽性率和 Flash-Lite 的參數能力,而價格還不到單次 Flash-Lite 的一半。這組合就是最後的答案,所以接下來的重點都在它。
你其實不需要的那次呼叫
拿 _Last updated 這個檢查來看。Jev 會回傳 regex,附上一個機率分布,然後就停了。哪個檔案?什麼模式?這就得靠第二個模型。Flash-Lite 只要一次呼叫,就能回傳標籤、參數,還有理由,因為它會寫。
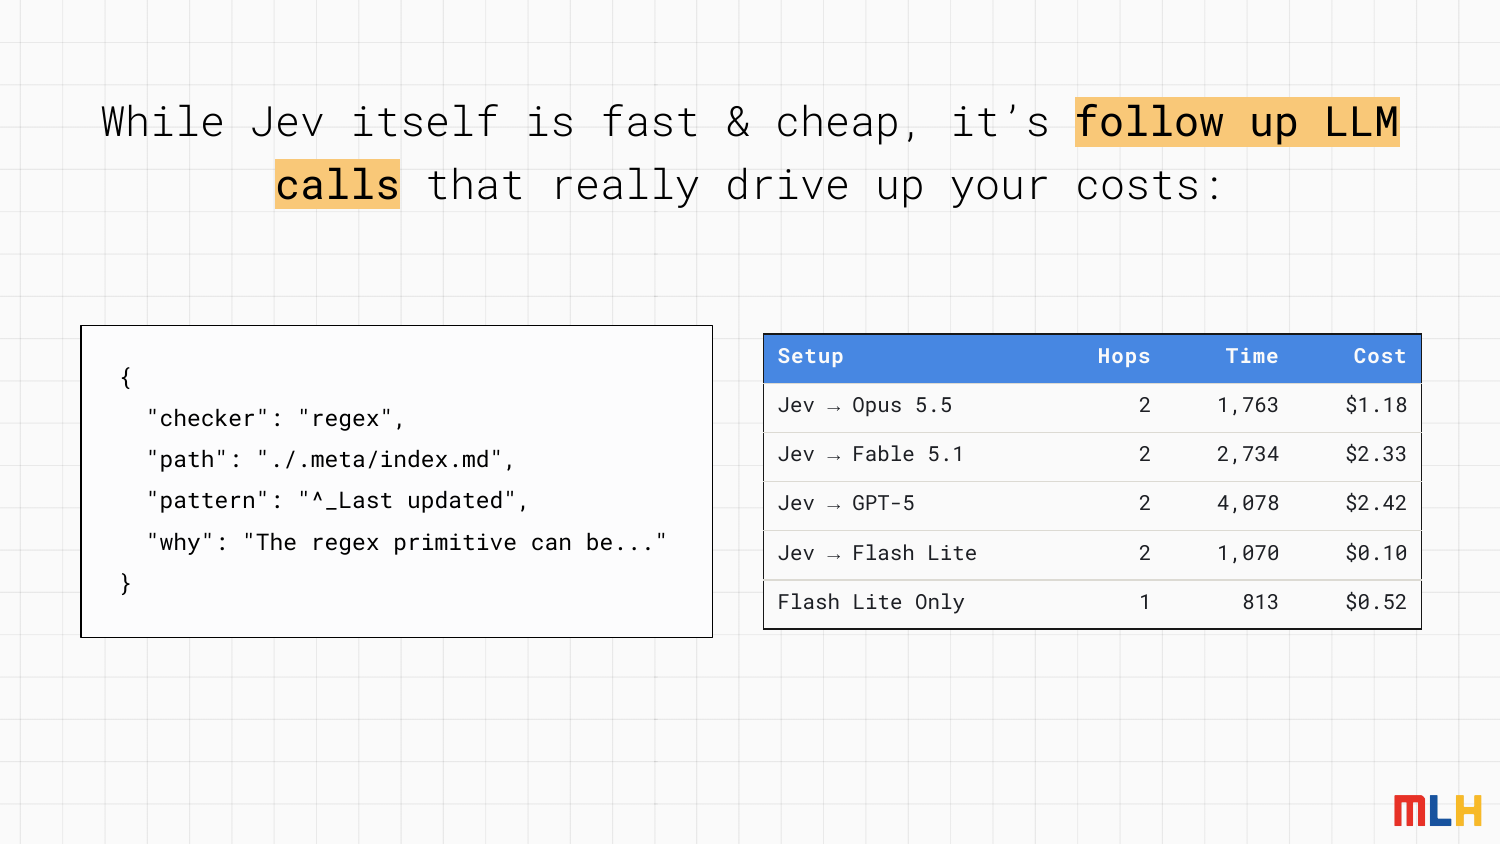
以 OpenRouter 計費並量測。時間為平均毫秒;成本為每 1,000 個檢查專案。
現在看第四列:Jev → Flash-Lite,0.10 美元。 比單用 Flash-Lite 的 0.52 美元還便宜。加了一個模型,怎麼反而便宜五倍?
Jev + Flash-Lite 怎麼省下這筆錢
其實沒什麼玄機,只是 Flash-Lite 的帳單上有兩個乘數。
1. 第二次呼叫只在真的需要寫東西時才會跑。 轉給評審器的檢查沒有參數。Jev 先轉交之後,Flash-Lite 根本不會看到它。在我們完整資料裡,大多數檢查都是這樣:不到十分之四有任何東西需要 Flash-Lite 處理。
2. 第二次呼叫用的是更短的 prompt。 單次呼叫的 prompt 很長,因為要靠工作範例讓 Flash-Lite 在路由決策上保持安全。而且每個檢查都會送出。到了雙模型流程裡,Jev 已經先做完路由決策了。第二個 prompt 只需要說:這是檢查專案、這是已選定的檢查器,請寫出它的參數。這大概只有原本 token 數的七分之一。
某個評測聲明已經被路由到一個可確定判定的檢查器。請寫出該檢查器的參數。

聲明:{check}
已選擇的檢查器:{label}

各檢查器所需參數:
- file_exists / not_file_exists: "path"
- glob_count: "glob" 和 "count"
- regex: "path" 和 "pattern"
...
請只回傳一個只包含參數的 JSON 物件,不要有其他內容。
Jev 本身每 1,000 個檢查大約只要 3 美分,幾乎可忽略不計。
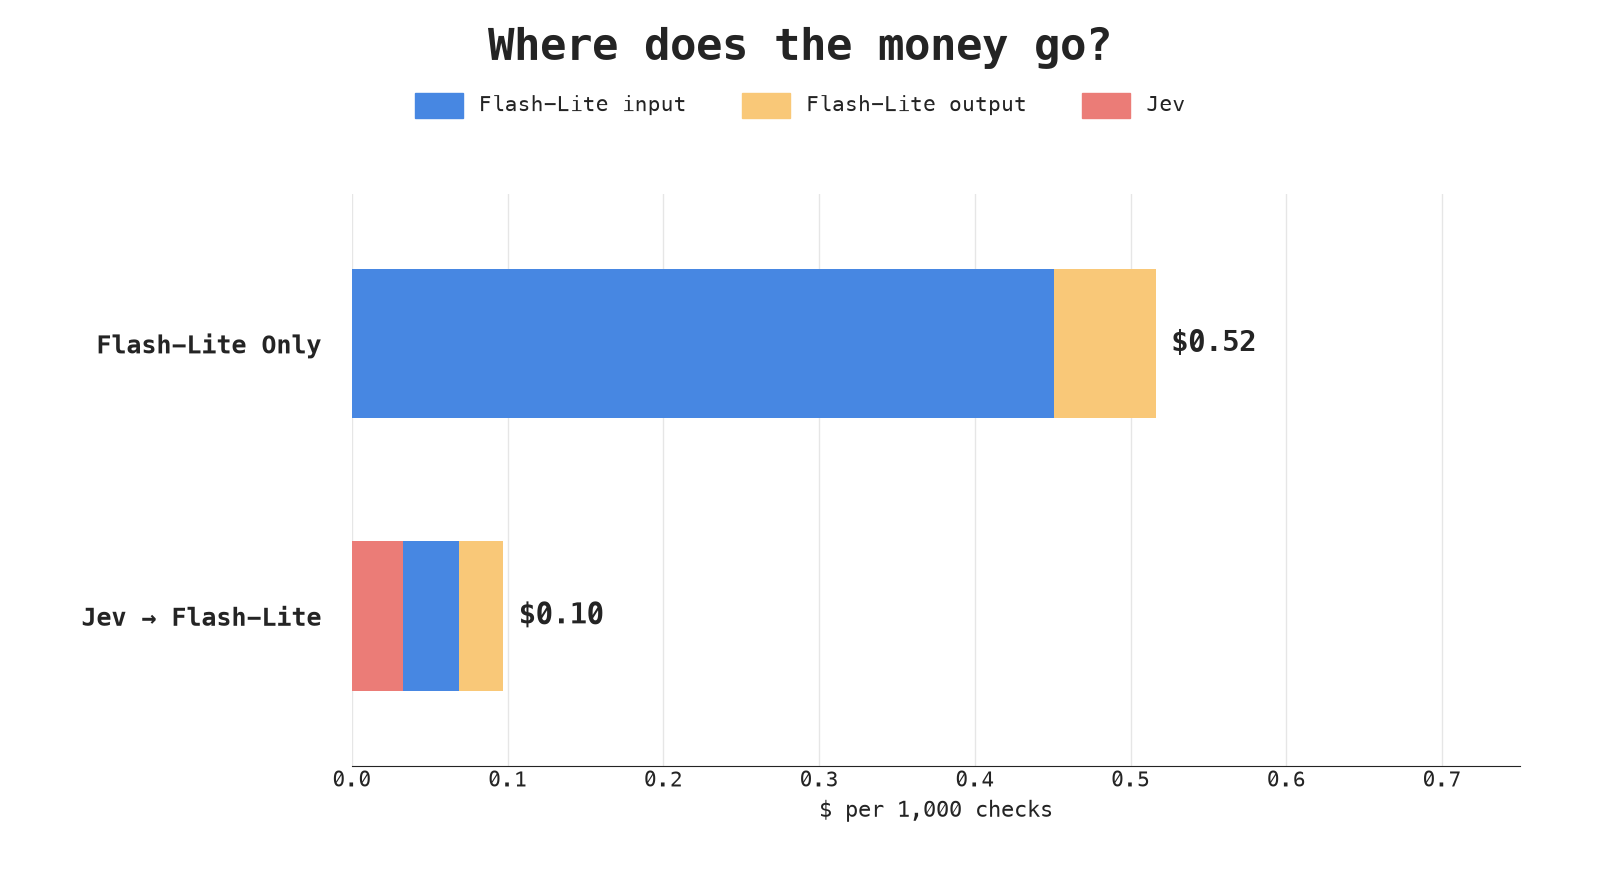
藍色是 Flash-Lite 輸入,黃色是 Flash-Lite 輸出,珊瑚色是 Jev。
把這些乘數疊在一起:大約只有一半的檢查會呼叫一次,prompt 大小又只有七分之一,再加上幾乎免費的第一跳。實測下來,0.52 變成每 1,000 個檢查 0.10 美元。若是正式環境的混合情況,還會更低。
在公開資料上也一樣。在 BFCL 上,這組合的成本不到單用 Flash-Lite 的一半。第二跳大約只在一半的專案上執行,而且它只需要讀一個函式的 schema,而不是每個候選函式的 schema。
你得付出的代價是:多一次往返,平均多大約四分之一秒。還有,你繼承的是 Jev 的路由,而不是 Flash-Lite 的。以 BFCL 來說,這代表 Jev 的假陽性率,以及 Jev 的門檻旋鈕。
重點整理
-
Flash-Lite 是 Google 最被低估的秘密武器。 對多數分類工作來說,它在速度與成本之間取得了很好的平衡。它夠聰明,能容忍粗糙 prompt,還能生成內容。它在 Jev 的原始 prompt 下沒有任何危險呼叫,而且只用一次呼叫就把標籤和參數都寫出來了。
-
Prompt 是你最大的單一變因。 一句話就把 Jev 從 35 次危險執行降到 0,而加入範例反而更糟。更聰明的模型會把問題變得沒那麼嚴重,但不會把問題消除:同樣的 prompt 改動仍然讓 Opus 從大多數情況都回答,變成大多數情況都轉交。
-
私有評測能把真相和炒作分開。 我們不用相信任何人對 Jev 的說法,連 TypeSafe 自己的說法都不用。因為我們手上有來自真實產品的真實檢查專案,所以就直接把這個熱門模型和我們本來就在用的模型拿來比。結果顯示:它真的快、真的便宜、而且在問對問題之後真的能達到零錯誤。不是事實的部分有:範例有幫助、更聰明的模型會讓 prompt 變得不重要。沒有人提到的是:最便宜的組合其實是把兩者一起用。
想進一步了解,可以先看 Jev 的實作入門指南。Google 的 Gemini 3.6 Flash 與 3.5 Flash-Lite 開發者指南 也有介紹這個模型。
Happy Hacking!
原文出處:https://dev.to/theycallmeswift/i-got-jev-to-zero-mistakes-im-still-using-flash-lite-2mo7
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

