

我最近在重構一些舊的 PHP 程式碼時,注意到同一個資料陣列竟然被以完全不同的方式使用!差異非常大!經過一些分析後,我得出的結論是:只要 PHP 陣列維持為緊湊清單(packed list),它就是非常高效的資料結構;但一旦變成雜湊表,記憶體消耗就會暴增,而且對大型資料集來說,關聯式陣列往往會比一般的型別化物件多吃將近兩倍的記憶體。
在這篇文章中,我想解釋為什麼會這樣,以及我得到的結論,因為正如我在 PHP 社群中聽說的,只有上帝知道記憶體到底跑去哪了 😀
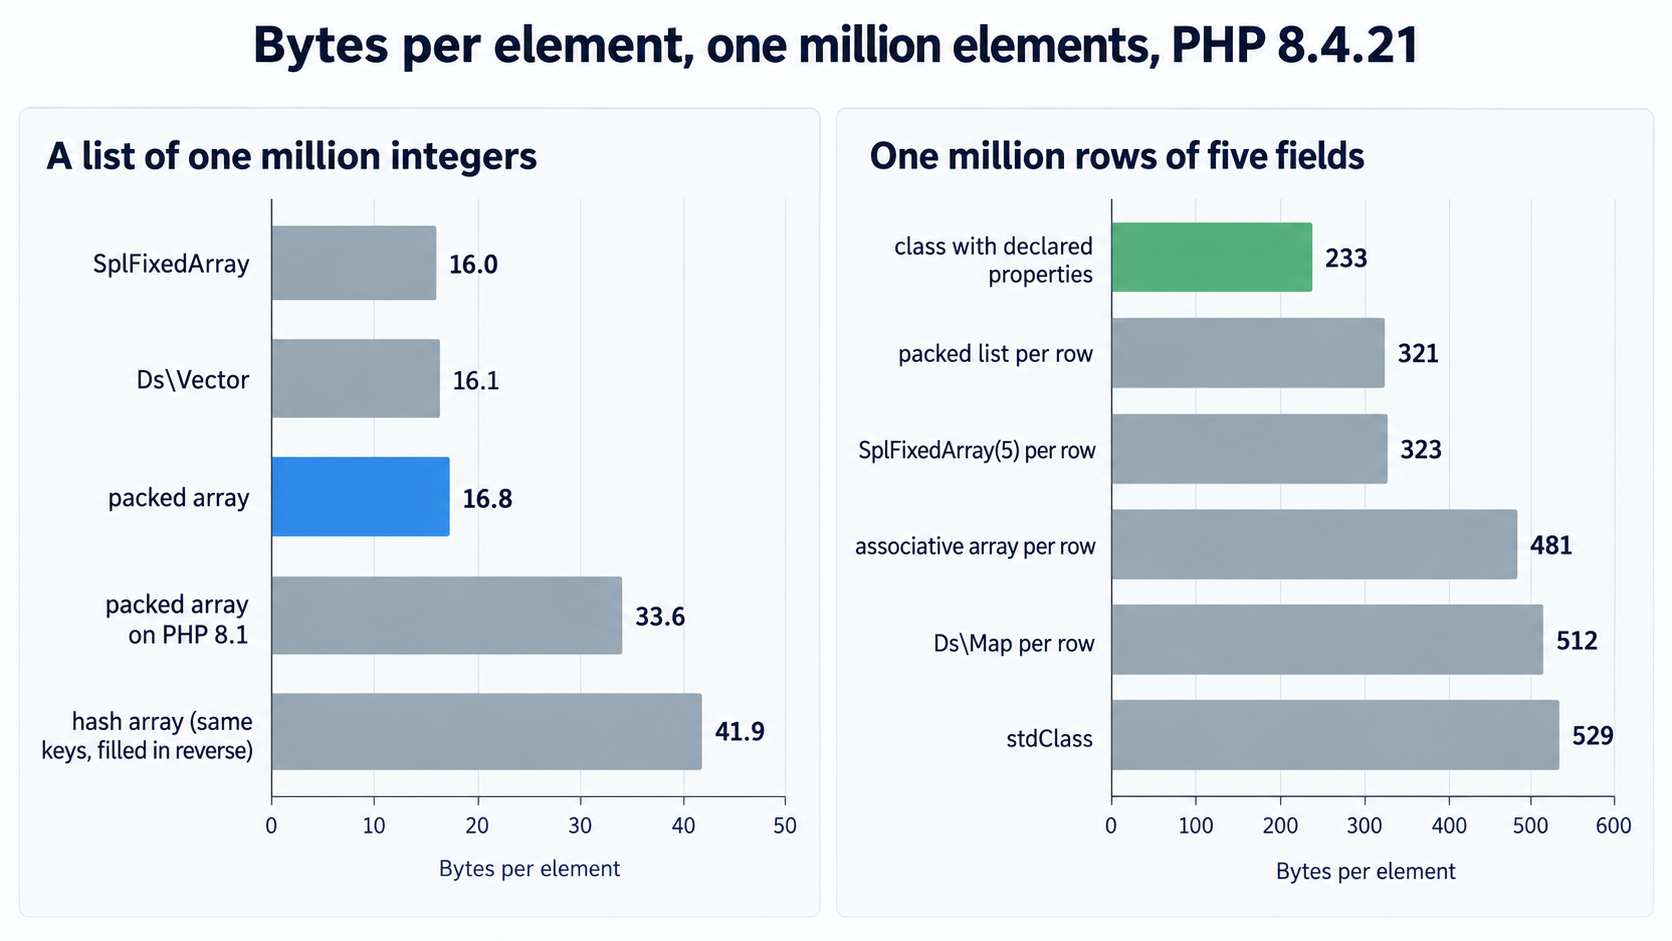
經過一些分析後,我發現,在 PHP 8.4 中,一個裝有一百萬個整數的 PHP 陣列會占用 16.8 MB。如果你加上一個單字元鍵,則會變成 41.9 MB。也就是說,一個鍵就吃掉了 25 MB。🤷♂️
我已經不知道聽過多少次「PHP 陣列就是雜湊表」這句話,聽到都麻木了,它就跟「浮點數不精確」放在同一個抽屜裡。所以我最後就建立了一百萬個元素的陣列,並在操作它們時觀察 memory_get_usage()。我先從 PHP 會最佳化的情境開始,再看那些讓這個最佳化悄悄失效的方式,接著是從查詢中拿到的一百萬筆資料列,每一列都是關聯式陣列,因為我接觸過的每個程式碼庫都是這樣存它們的。真正的成本其實就藏在這些資料列裡,而解法最後比問題本身還小。
下面所有測試都在官方 php:8.4-cli Docker 映像中的 PHP 8.4.21 上執行,環境是 64 位元 Linux,memory_limit 設為 -1,所以中途不會死掉;而在有版本差異的地方,我也在 8.1.34 上跑了同樣的腳本,因為 8.2 改變了其中一個數字很多,我想同時看到前後的差異。數值都是 memory_get_usage() 的差值。PHP 手冊說這些數字會被四捨五入到配置器的粒度,所以最後幾位請視為雜訊。
每個整數 16 位元組,直到你加上一個鍵
這是我用的範例程式碼;這段測量記憶體用的程式其實一點都不複雜。你也可以試著重現看看!測量的程式沒有什麼花俏技巧:建立陣列、用兩次 memory_get_usage() 相減,再除以元素數量。
bench.php
<?php
declare(strict_types=1);

const N = 1_000_000;

function report(string $label, int $bytes, int $n): void
{
    printf("%-42s %14s bytes  %6.2f bytes/elem\n", $label, number_format($bytes), $bytes / $n);
}

$before = memory_get_usage();
$a = [];
for ($i = 0; $i < N; $i++) {
    $a[] = $i;
}
report('packed list, keys 0..N-1 in order', memory_get_usage() - $before, N);

$before = memory_get_usage();
$r = [];
for ($i = N - 1; $i >= 0; $i--) {
    $r[$i] = $i;
}
report('same keys, filled in reverse order', memory_get_usage() - $before, N);
這兩個迴圈使用相同的鍵與相同的值。一個是遞增,另一個是遞減。
PHP 8.4.21 (Linux)
packed list, keys 0..N-1 in order          16,781,392 bytes   16.78 bytes/elem
range(0, N-1)                              16,781,392 bytes   16.78 bytes/elem
same keys, filled in reverse order         41,943,120 bytes   41.94 bytes/elem
SplFixedArray of N ints                    16,003,192 bytes   16.00 bytes/elem
同樣一百萬個整數,記憶體卻多出兩倍半,原因只是我反向填入。
說實話,整篇文章用一句話就能講完。剩下的內容只是為什麼。😃
第一個陣列是引擎所稱的 packed。鍵是 0、1、2……依序排列,所以 PHP 根本不儲存鍵,每個槽位就是一個 16 位元組的 zval,如此而已。反向填入的陣列雖然鍵相同,但它們不是依序到達,所以它變成了真正的雜湊表,包含鍵、雜湊值,以及每個槽位約 40 位元組的索引。
接著就是讓我坐直身子的地方。把那個 packed 的百萬元素陣列加上一個字串鍵。
$a['x'] = 0;after adding one string key to packed list +25,161,728 bytes
after adding key -1 to packed list +25,161,728 bytes
after unset of that string key +25,161,728 bytes (nothing came back)一個鍵。二千五百萬位元組。而且事實證明,刪掉這個鍵並不會把這個動作撤銷,因為在 unset 的路徑上並沒有把雜湊表轉回 packed(sort() 會,順帶一提,array_values() 會建立一個新的 packed 陣列,但單純的 unset 只會釋放值,並不會改變布局)。負數鍵和字串鍵的效果一樣,而我不太確定為什麼這會讓我意外,雖然以無號值來看它其實大得離譜,但確實如此。
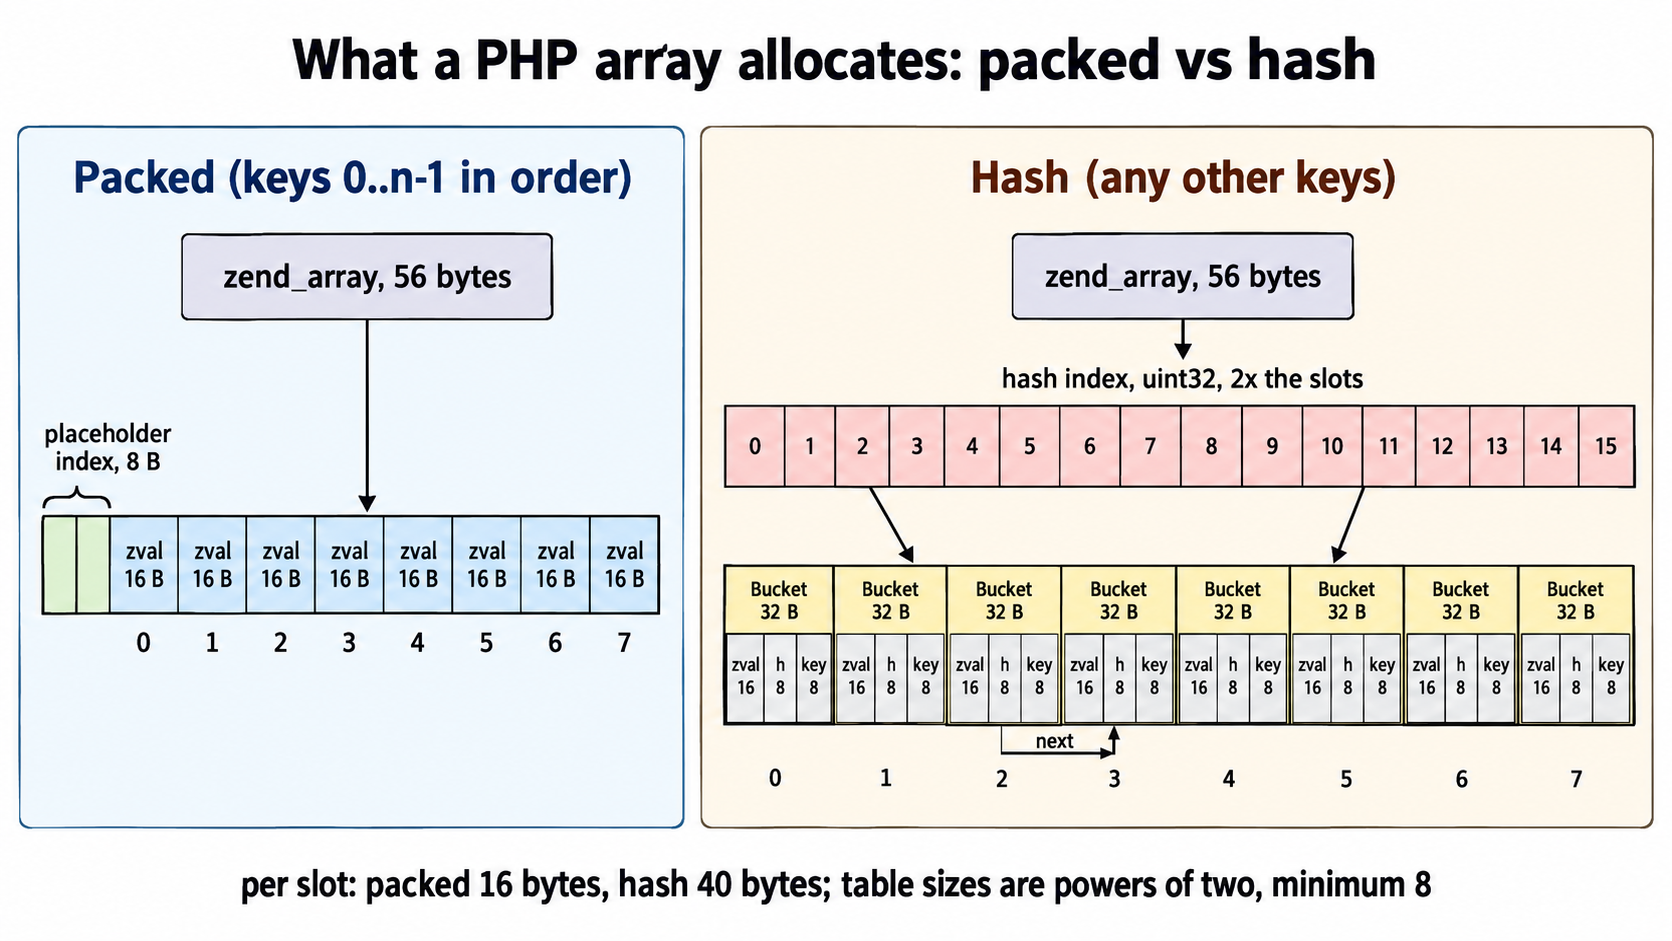
packed 陣列是扁平的 zval 陣列;雜湊陣列則是 buckets 加上索引
每個 PHP 陣列都是一個 zend_array,C 程式碼也把它稱為 HashTable。在 64 位元系統上它是 56 位元組。大部分都是管理資訊(引用計數標頭、旗標、表格大小、元素數量、下一個可用整數鍵、以及析構函式指標),然後有一個指向資料的指標,而這個指標是一個 union,而這個 union 就是全部故事的核心:
Zend/zend_types.h(php-src,PHP-8.4 分支)
union {
    uint32_t     *arHash;
    Bucket       *arData;
    zval         *arPacked;
};
在雜湊模式中,資料區塊有兩部分。前面是雜湊索引,這是一個 uint32_t 陣列,槽位數量是 bucket 數量的兩倍(遮罩是 -(nTableSize + nTableSize)),所以每個 bucket 會有 8 位元組的索引;後面則是 bucket 本體,每個 bucket 32 位元組:
Zend/zend_types.h(php-src,PHP-8.4 分支,註解為我加的)
typedef struct _Bucket {
    zval              val;   /* 16 bytes: the value */
    zend_ulong        h;     /* 8 bytes: the integer key, or the string key's hash */
    zend_string      *key;   /* 8 bytes: NULL for integer keys */
} Bucket;
查找時會先把鍵做雜湊,套用遮罩去索引表裡找出 bucket 編號,如果兩個鍵碰撞,則會追蹤 zval 內部儲存的 next 鏈結。迭代時根本不碰索引表,而是從頭到尾掃過 buckets,因為 buckets 是依插入順序追加的,所以 foreach 才能免費得到插入順序。
因此,一個雜湊槽位的成本是 32 + 8 = 40 位元組。一百萬個元素需要一個 1,048,576 個槽位的表(後面會再說),而 40 乘上去,和量到的數值只差 80 位元組。那是 56 位元組的結構體,加上配置器為這麼大的區塊保留的 24 位元組。
在 packed 模式下沒有索引(只有兩個佔位槽位,總共 8 位元組),資料是 zval *arPacked,也就是一個單純的 C 陣列,每個元素 16 位元組,位置就是鍵。以同樣的表格大小乘上 16,結果會比量到的 16.8 MB 少大約 4 KB。只是 slot 變小了,計算方式還是一樣。
有件事是我之前沒注意到的:packed 陣列直到 PHP 8.2 才變得這麼省。在那之前,它們和雜湊陣列一樣使用 32 位元組的 buckets,只是省略索引表,並讓 h 在每個槽位中重複該槽位的位置,且 key 永遠是 NULL。這個狀態一直持續到 Dmitry Stogov 的 PR #7491(「Use more compact representation for packed arrays」)在 2021 年 11 月合併,並於 2022 年 12 月隨 8.2.0 發布。這是內部實作層面的變更,所以 8.2 的 UPGRADING 說明完全沒提到它(我有特地去找)。下面是 8.1 的前情測試:
PHP 8.1.34 (Linux)
packed list, keys 0..N-1 in order          33,558,608 bytes   33.56 bytes/elem
same keys, filled in reverse order         41,943,120 bytes   41.94 bytes/elem
你的應用程式裡每個清單的槽位記憶體都少了一半,而這只是一個版本改變。Tideways 團隊在 8.2 發布時也量到了同樣的事情,在 100,000 元素的清單上,從 4.3 MB 降到 2.3 MB。如果你因為某些原因還停留在 8.1,這本身就足以成為升級理由。
另一個值得知道的規則是成長方式。表格大小是 2 的次方,最小為 8,而滿表會直接倍增(zend_hash_do_resize 中的 nSize = ht->nTableSize + ht->nTableSize),所以一百萬個元素會落在 1,048,576 個槽位的表裡。也就是說:
packed list of 1,048,576 ints              16,781,448 bytes   16.00 bytes/elem
packed list of 1,048,577 ints              33,558,664 bytes   32.00 bytes/elem
多一個元素,記憶體就翻倍。而且它不會往回縮。我刪掉了一百萬個元素中的 999,000 個,memory_get_usage() 只變動了 0 位元組。這些值是整數,所以沒有東西可釋放,而表格本身也不會縮小。陣列會記住自己曾經有多大。對 queue worker 來說,這正是記憶體只會往上升的一個原因,而長時間執行的 PHP 程序還會經歷其餘那些原因。
維持 packed 的規則比 array_is_list() 更嚴格
轉換邏輯在 Zend/zend_hash.c 的 _zend_hash_index_add_or_update_i。對於目前仍是 packed 的陣列,整數鍵會經過以下流程。
- 鍵小於高水位,但槽位已填滿。 原地覆寫。仍是 packed。
- 鍵小於高水位,但槽位是空洞。 轉成雜湊。原始碼中的註解寫著
/* we have to keep the order :( */,這就是整件事真正的原因。PHP 陣列保證以插入順序迭代,而 packed 陣列只能表達「遞增」,所以任何會破壞遞增順序的插入,都會迫使整個結構轉換。 - 鍵落在目前表格大小內。 追加,將任何缺口補成未定義槽位,維持 packed。寫入
$a[0] = 'a'; $a[5] = 'b';會得到一個中間有四個空洞的 packed 陣列。 - 鍵超過表格,但小於兩倍表格大小,且表格已超過一半滿。 擴容,維持 packed。
- 其他所有情況、每個字串鍵、以及任何負數鍵(以無號值來看它大得離譜)。轉成雜湊。
以下是兩個擁有相同兩個元素、但到達順序不同的陣列。
[0 => 'b', 1 => 'a'] built at runtime      216 bytes
[1 => 'a', 0 => 'b'] built at runtime      376 bytes
花 376 位元組的那個是雜湊表,裡面有 8 個 bucket 與 16 個索引槽位。對兩個值而言。216 位元組的那個則是 8 個 zval,別的都沒有。兩者都是最小表格大小。
真正會踩到的陷阱是 array_filter()。它會保留鍵,而且大家都知道這件事,因為 JSON 的症狀就是:過濾後的清單會被編碼成物件。但記憶體上的症狀沒那麼明顯。把一個 packed 的百萬元素陣列過濾成只保留偶數後,結果會逐個鍵建立(0、2、4、6),直到鍵 8 出現時,既不符合初始大小為 8 的表格,也不符合「超過一半滿」的條件,於是新的陣列在第五個元素時轉成雜湊,並在之後整個生命週期都維持那樣。
array_filter keeping every other element   20,971,600 bytes   41.94 bytes/elem
array_values() of that result               8,392,784 bytes   16.79 bytes/elem
array_is_list(filtered) = false
元素少了一半,記憶體卻比原本的 packed 百萬元素還多。array_values() 可以修正它,代價是複製一次,而如果結果之後還會活一段時間,我認為這通常是值得的。
而 array_is_list() 檢查的是鍵,不是布局。它在 8.1 出現,而我原本以為它就是這個判斷。它回答的是「鍵是否從 0 到 n-1 依序排列」,而雜湊表也能符合這個條件:
[1 => 'a', 0 => 'b']                       376 bytes   array_is_list = false
after unset($b[1])                         376 bytes   array_is_list = true
同樣是 376 位元組、同樣是雜湊布局,但現在這個函式說它是 list。直到 PHP 8.4 之前,使用者空間沒有任何呼叫能顯示出布局,而唯一誠實的工具就是 memory_get_usage()。從 8.4 開始,debug_zval_dump() 會在 packed 陣列旁印出 packed,而對這個例子,它什麼都不會印。
複製在第一次寫入前幾乎不花成本
引用計數存在 zend_array 標頭裡,不在變數本身。$b = $a 只是把引用計數加一,並讓兩個變數都指向同一張表;把陣列傳進函式也一樣。我記得看過某個規則說,我們只允許修改自己獨佔擁有的結構,也就是它們的引用計數必須是 1。否則引擎會先做分離(separate),而分離就代表複製整張表。
$copy = $a                                          0 bytes
$copy[] = 1 (first write)                  16,781,392 bytes
對陣列型資料列來說,有個細節對你有利。分離時會複製外層表格,並將每一列的引用計數加一,而不會深層複製這些列。對一個百萬列陣列的複製後再 append,成本是 16.8 MB(外層 packed 表格);而在這個複製品中的某一列只改動一個欄位,則只會再多花該列的 376 位元組雜湊表成本。引擎會精準複製你碰到的東西,而且一次只複製一層。
一百萬列陣列的成本是同樣資料列物件的兩倍
這才是我真正想知道的。查詢結果以關聯式陣列回傳,是我看過的每個 PHP 程式碼庫的預設做法(不是 fetchAll(PDO::FETCH_ASSOC),就是回傳相同形狀的 query builder)。我猜典型請求中存活著的大多數陣列,之所以長那樣,正是因為它們來自查詢或帶有字串鍵的 JSON body。所以這裡測的是一百萬列、每列五個欄位,且每個容器中的值都相同。
final class Row
{
    public function __construct(
        public int $id,
        public string $name,
        public string $email,
        public bool $active,
        public float $balance,
    ) {}
}

// 每種形狀都在迴圈中建立一百萬次,並保留在清單中
$row = ['id' => $i, 'name' => "user$i", 'email' => "[email protected]", 'active' => true, 'balance' => 1.5];
$row = new Row($i, "user$i", "[email protected]", true, 1.5);
$row = [$i, "user$i", "[email protected]", true, 1.5];
以下是一百萬列資料每列的位元組數,包含兩個字串與外層清單中的那個槽位:
| 形狀 | PHP 8.4.21 | PHP 8.1.34 |
|---|---|---|
| 具有 5 個已宣告型別屬性的類別 | 233 | 250 |
相同類別,readonly 屬性 |
233 | 250 |
每列為 packed list(FETCH_NUM 形狀) |
321 | 498 |
每列為 SplFixedArray(5) |
323 | 324 |
每列為關聯式陣列(FETCH_ASSOC 形狀) |
481 | 498 |
每列為 stdClass(FETCH_OBJ 形狀) |
529 | 546 |
這張表有個地方要注意:這六種形狀是在同一個程序中依序跑完的,所以物件列看起來比實際上稍微便宜一點。每個物件還會在引擎的物件儲存區中占用 8 位元組的專案,而這個儲存區在滿了之後會倍增,且永遠不會縮小;後面那些物件測試也重用了 stdClass 測試已經付過的專案(以及一些其他管理資訊)。如果每一種都在全新的程序中單獨量測,8.4 上的類別列是 241 位元組,8.1 上是 258 位元組,而 SplFixedArray(5) 的一列在 8.4 上是 340、在 8.1 上是 341。陣列列與 stdClass 的結果則相同。
那兩個字串在每一列都一樣。"user123456" 和 "[email protected]" 分別需要 40 與 48 位元組:24 位元組的 zend_string 標頭,加上字元與終止符,再向上四捨五入到配置器區塊。外層陣列中的槽位是 16.78。把這 105 位元組扣掉後,剩下的就是容器本體,而我也逐列量過,確認如下:
assoc row, 5 string keys                   376 bytes
stdClass row, 5 dynamic properties         416 bytes
packed row, 5 values                       216 bytes
SplFixedArray(5) row                       176 bytes
object row, 5 declared properties          128 bytes
376 就是前一節提過的數字:56 位元組的標頭,加上一個大小為最小 8 個 buckets 的雜湊區塊(bucket 8 x 32,再加上索引 16 x 4),總共 320 位元組。對五個欄位而言,每列都帶著自己的索引、自己的鍵雜湊與指標副本,以及三個空 bucket。
物件之所以是 128,是因為 zend_object 標頭是 40 位元組,而已宣告屬性會直接內嵌在後面,每個屬性一個 16 位元組 zval(所以是 40 + 5 x 16 = 120,再由配置器向上四捨五入到 128 的區塊)。屬性名稱根本不在物件裡,因為類別本身持有一張表,把每個名稱映射到槽位偏移量(在編譯時只建立一次),而每個實例就只是那些槽位。
有沒有型別、是不是 readonly,對位元組數都沒有影響。型別存在於類別中,而槽位不論如何都是 zval,所以從正確性角度你會寫的 readonly DTO,同時也是儲存一列資料最省記憶體的方式。
stdClass 是兩者的最糟組合。它有 40 位元組的物件標頭,但沒有已宣告屬性,所以每個欄位都進到物件自己的 properties 雜湊表,而那個表正是前面那個 376 位元組的陣列,只是外面包了一個物件。FETCH_OBJ 會一百萬次給你這種形狀。PHP 8.2 已經在一般類別上棄用了動態屬性,但 RFC 把 stdClass 標記成 #[AllowDynamicProperties],所以它不會消失。
每列為 packed list 的形狀很好地展示了 8.2 的改變。在 8.4 上它是 216 位元組:一個標頭,加上八個 16 位元組槽位,再向上四捨五入到 160 的區塊。在 8.1 上則是 376,與關聯式版本完全相同,因為當時 packed bucket 是 32 位元組,八個 bucket 加上那個很小的索引,會落在同樣的 320 位元組區塊。所以在 8.2 之前,FETCH_NUM 根本沒省到任何東西;現在則能省掉三分之一,但代價是你拿不到欄位名稱。
好吧,但 driver 給我的就是陣列啊。把一百萬筆資料轉成物件等於一百萬次建構子呼叫。沒錯,但相較於你已經付出的查詢成本,建構子其實很便宜。PDO 可以用 FETCH_CLASS 每列實例化一個類別(不過它會在呼叫建構子之前先指定屬性,除非你加上 FETCH_PROPS_LATE,而這會讓 constructor promotion 麻煩到我寧可自己寫那一行對映),但對「一百萬次建構子呼叫」更好的回答其實是:你根本不應該持有一百萬筆任何東西,而這就是最後一節。
SplFixedArray 在扁平清單上贏了,而 ext-ds 也沒有改變這件事
SplFixedArray 是一個 C 結構,裡面有一個 zend_long size 和一個 zval *elements 緩衝區,配置大小恰好是 size 乘上 sizeof(zval)。沒有雜湊、沒有索引、也沒有 2 的次方取整。一百萬個整數精確花費 16.00 位元組/元素,相較於 packed 陣列的 16.78(packed 陣列會把表格向上取整到下一個 2 的次方)還省一些。這 5% 就是全部的記憶體收益,而代價是你失去成長、字串鍵,以及所有 array_* 函式。對五欄資料列來說,它是 176 位元組(物件標頭加上結構,再加上一個獨立的 80 位元組元素緩衝區),比類別還大。
ext-ds(PHP 擴充套件)我其實也編譯來測了,因為每次談到 PHP 資料結構時大家都會提它;先講一個註解:pecl install ds 給我的是 2.0.0,而在這個建置上,它宣告了 Ds\Seq、Ds\Map、Ds\Set、Ds\Heap 和 Ds\Pair,完全沒有 Ds\Vector,所以下面的數字是來自 1.6.0。
PHP 8.4.21, ext-ds 1.6.0
Ds\Vector of N ints (push)                 16,085,160 bytes   16.09 bytes/elem
Ds\Map of N ints (reverse order)           37,748,960 bytes   37.75 bytes/elem
Ds\Map per row inside a Ds\Vector         512,457,608 bytes  512.46 bytes/row
Ds\Vector 是連續緩衝區,容量不綁定 2 的次方(手冊就是這麼寫的),所以它落在 16.09,而不是 16.78。Ds\Map 比雜湊陣列省大約 10%。每列用一個 Ds\Map 反而比一般關聯式陣列更糟。它是一個 API 很好、演算法保證也實在的資料結構,而且結構縮小時它會真的把記憶體還回去(陣列永遠不會)。但它不是資料列的記憶體解法,而我也不會為了清單省 4% 就把一個 C 擴充套件加進部署環境。
我實際會怎麼做
保持清單為 packed。照順序 append,不要倒著用索引填,不要把字串鍵塞進應該是 list 的東西裡,而且如果某個結果是從 array_filter() 出來的、而且會比下一行活更久,就對它呼叫 array_values();另外要記得,array_is_list() 在測試中是個不錯的斷言,只要你知道它檢查的是鍵。
你在記憶體中持有的資料列,應該放進一個小型 final 類別,並使用提升式型別屬性。它的記憶體成本只有關聯式陣列的一半,而且每個欄位都有名稱與型別,readonly 也不會額外增加成本。這是我對大多數看過的 fetchAll() 後又遍歷結果的程式,最想改的一件事。
而且,不要持有一百萬列資料。下面是把資料先 materialize 再迴圈,與直接對 generator 迴圈的比較;兩者分別在兩個不同程序中執行,因此 peak 數值是誠實的,而且資料列是用程式產生、沒有經過資料庫,所以量到的是持有它們的成本,而不是抓取它們的成本:
function rows(int $n): Generator
{
    for ($i = 0; $i < $n; $i++) {
        yield new Row($i, "user$i", "[email protected]", true, 1.5);
    }
}

function loadAll(int $n): array
{
    $all = [];
    foreach (rows($n) as $row) {
        $all[] = $row;
    }
    return $all;
}

// materialize: foreach (loadAll(N) as $row) { $sum += $row->balance; }
// stream:      foreach (rows(N) as $row)    { $sum += $row->balance; }
materialize all rows, then loop peak over start 241,157,928 bytes
stream rows through a generator peak over start 37,008 bytes同樣是一百萬列資料、同樣的迴圈,卻從 2.41 億位元組降到 3.7 萬位元組。搭配真正的 statement 時,generator 就是 while ($r = $stmt->fetch()),每次迭代 yield 一個 Row。不過 MySQL 有一個很大的注意事項:查詢預設是緩衝的,所以 driver 會在你的第一次 fetch() 之前就把整個結果集拉進 PHP 記憶體,而使用 mysqlnd 時,這個緩衝區也會計入 memory_limit。因此,對緩衝結果集使用 generator,只是把物件串流出去,底下仍然握著所有原始資料列。解法是把大型查詢的 Pdo\Mysql::ATTR_USE_BUFFERED_QUERY 設為 false(在 8.3 及更早版本則是 PDO::MYSQL_ATTR_USE_BUFFERED_QUERY,8.5 會將其棄用),或者改成以主鍵分頁。Laravel 的 cursor() 就是這個模式,只是名字比較好聽。
每個槽位 16 位元組,對清單來說是很合理的價格。真正昂貴的是陣列悄悄地不再是清單了。🙂
感謝閱讀!我的英文不是母語,所以我用 AI 來潤飾文法。除此之外——想法、程式碼、觀點——都是我自己的。
喜歡這篇嗎?我們保持聯絡吧——我在 LinkedIn,很樂意聊天、交換想法,或者只是打聲招呼。👋
原文出處:https://dev.to/nazar-boyko/i-added-one-key-to-a-php-array-it-cost-25-mb-of-memory-4b80
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

