

Jev 是來自 TypeSafe AI 的前沿 AI 模型,它回傳的是帶型別的機率性決策,而不是生成文字。 你送入程式狀態與帶型別的問題;它會在 70 到 500 毫秒內以一次平行推理回覆全部問題,輸入每百萬 token 收費 $0.042,輸出免費。它於 2026 年 9 月 15 日正式推出,由 DCVC 領投募得 $4,000 萬,開發者是 Diogo Almeida;他曾在 OpenAI 共同發明 RLHF 與 InstructGPT。
這是一篇實用指南:安裝設定、三個基本原語、五個值得借鑑的模式、會害你踩雷的失敗模式,以及前 48 小時大家做出了什麼。
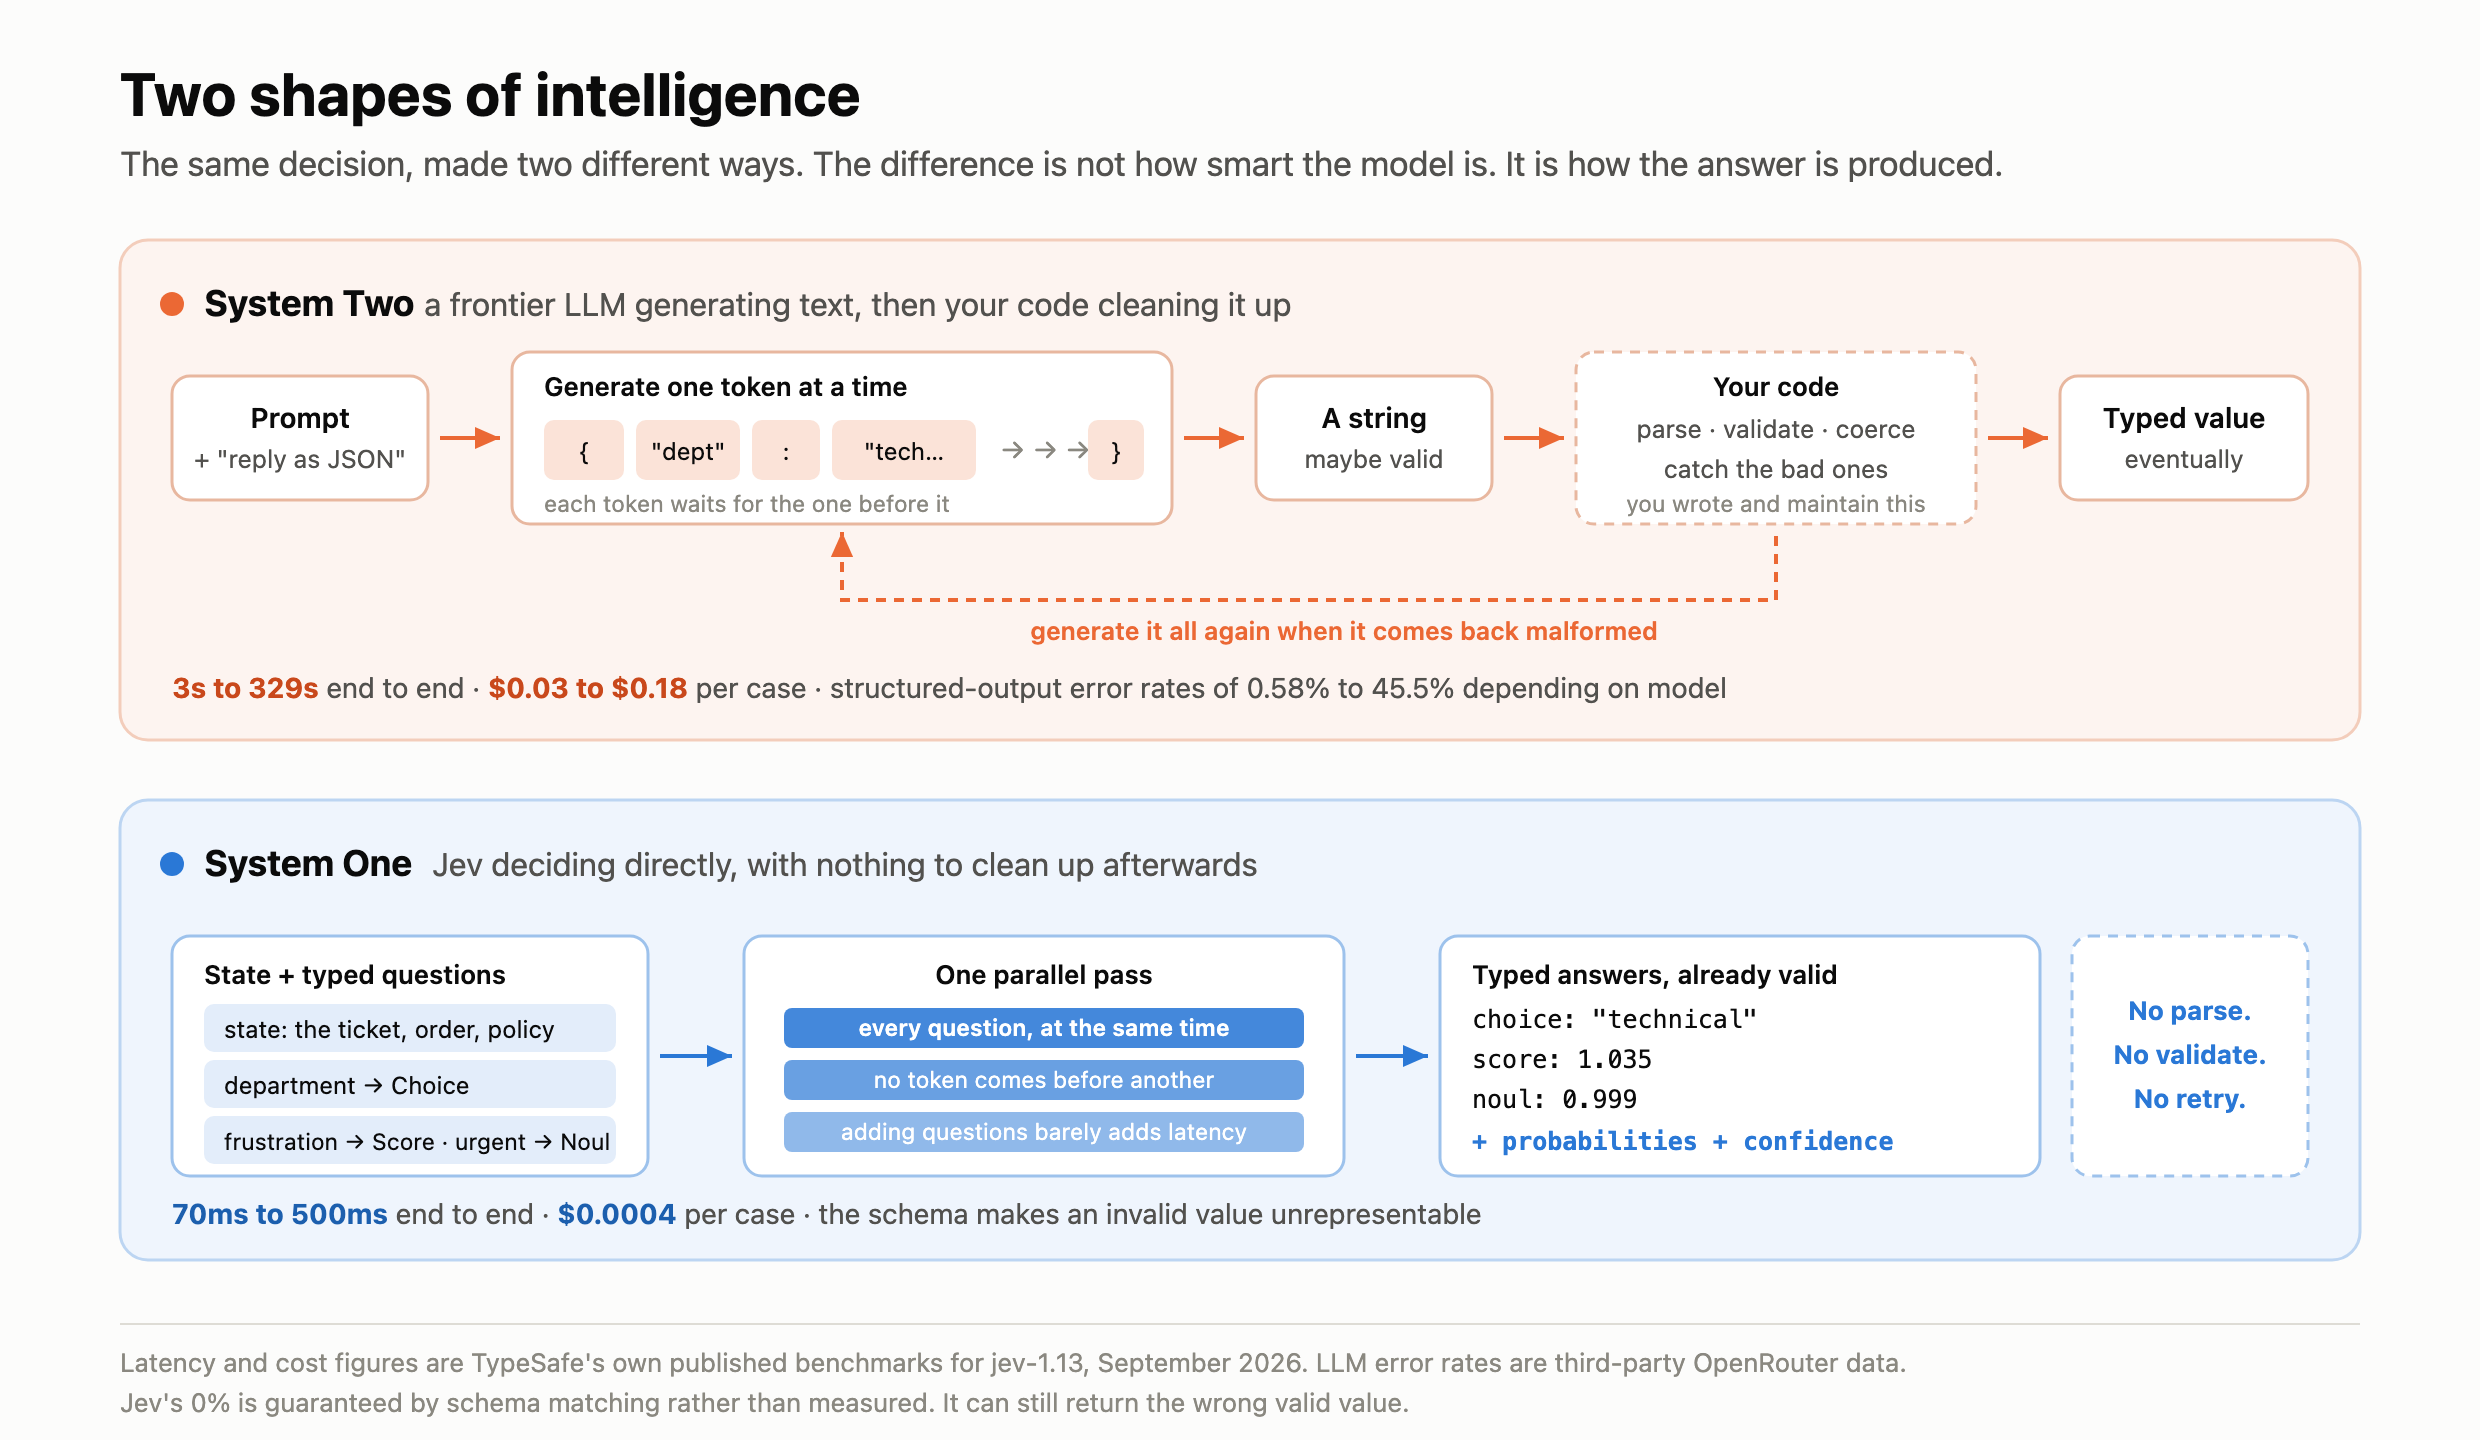
TypeSafe AI 把這類模型稱為 System One,借用 Kahneman 對快速、直覺式思考的命名。它的賭注是:軟體內的大多數決策其實都是 System 1 判斷(「這要歸到哪一類?」、「這很急嗎?」),而我們一直在租用 System 2 來做這些事。
| Jev | 前沿 LLM | |
|---|---|---|
| 端到端延遲 | 70ms 到 500ms | 3s 到 329s |
| 輸入價格 | $0.042 / MTok | $0.20 到 $10 / MTok |
| 輸出價格 | 免費 | 約輸入的 5 倍 |
| 結構化輸出錯誤 | 0%(設計上保證) | 0.58% 到 45.5% |
先提醒一點,最後我也會再提一次:這些數字是 TypeSafe 自己跑出來的,尚未經外部重現。
安裝設定
到 console.typesafe.ai/settings/keys 取得金鑰(早鳥存取需要排隊等候名單),或從 Vercel AI gateway 取得,然後匯出:
export TYPESAFE_API_KEY="sk-..."Python(3.10+):
pip install typesafe-sdk
# 或:uv add typesafe-sdkJavaScript/TypeScript(Node 20+):
npm install @typesafe-ai/sdk兩個 SDK 都會從環境變數讀取 TYPESAFE_API_KEY,並預設使用 jev-latest。如果你想直接呼叫,唯一的端點是 POST https://api.typesafe.ai/v1/systemone。
三個基本原語
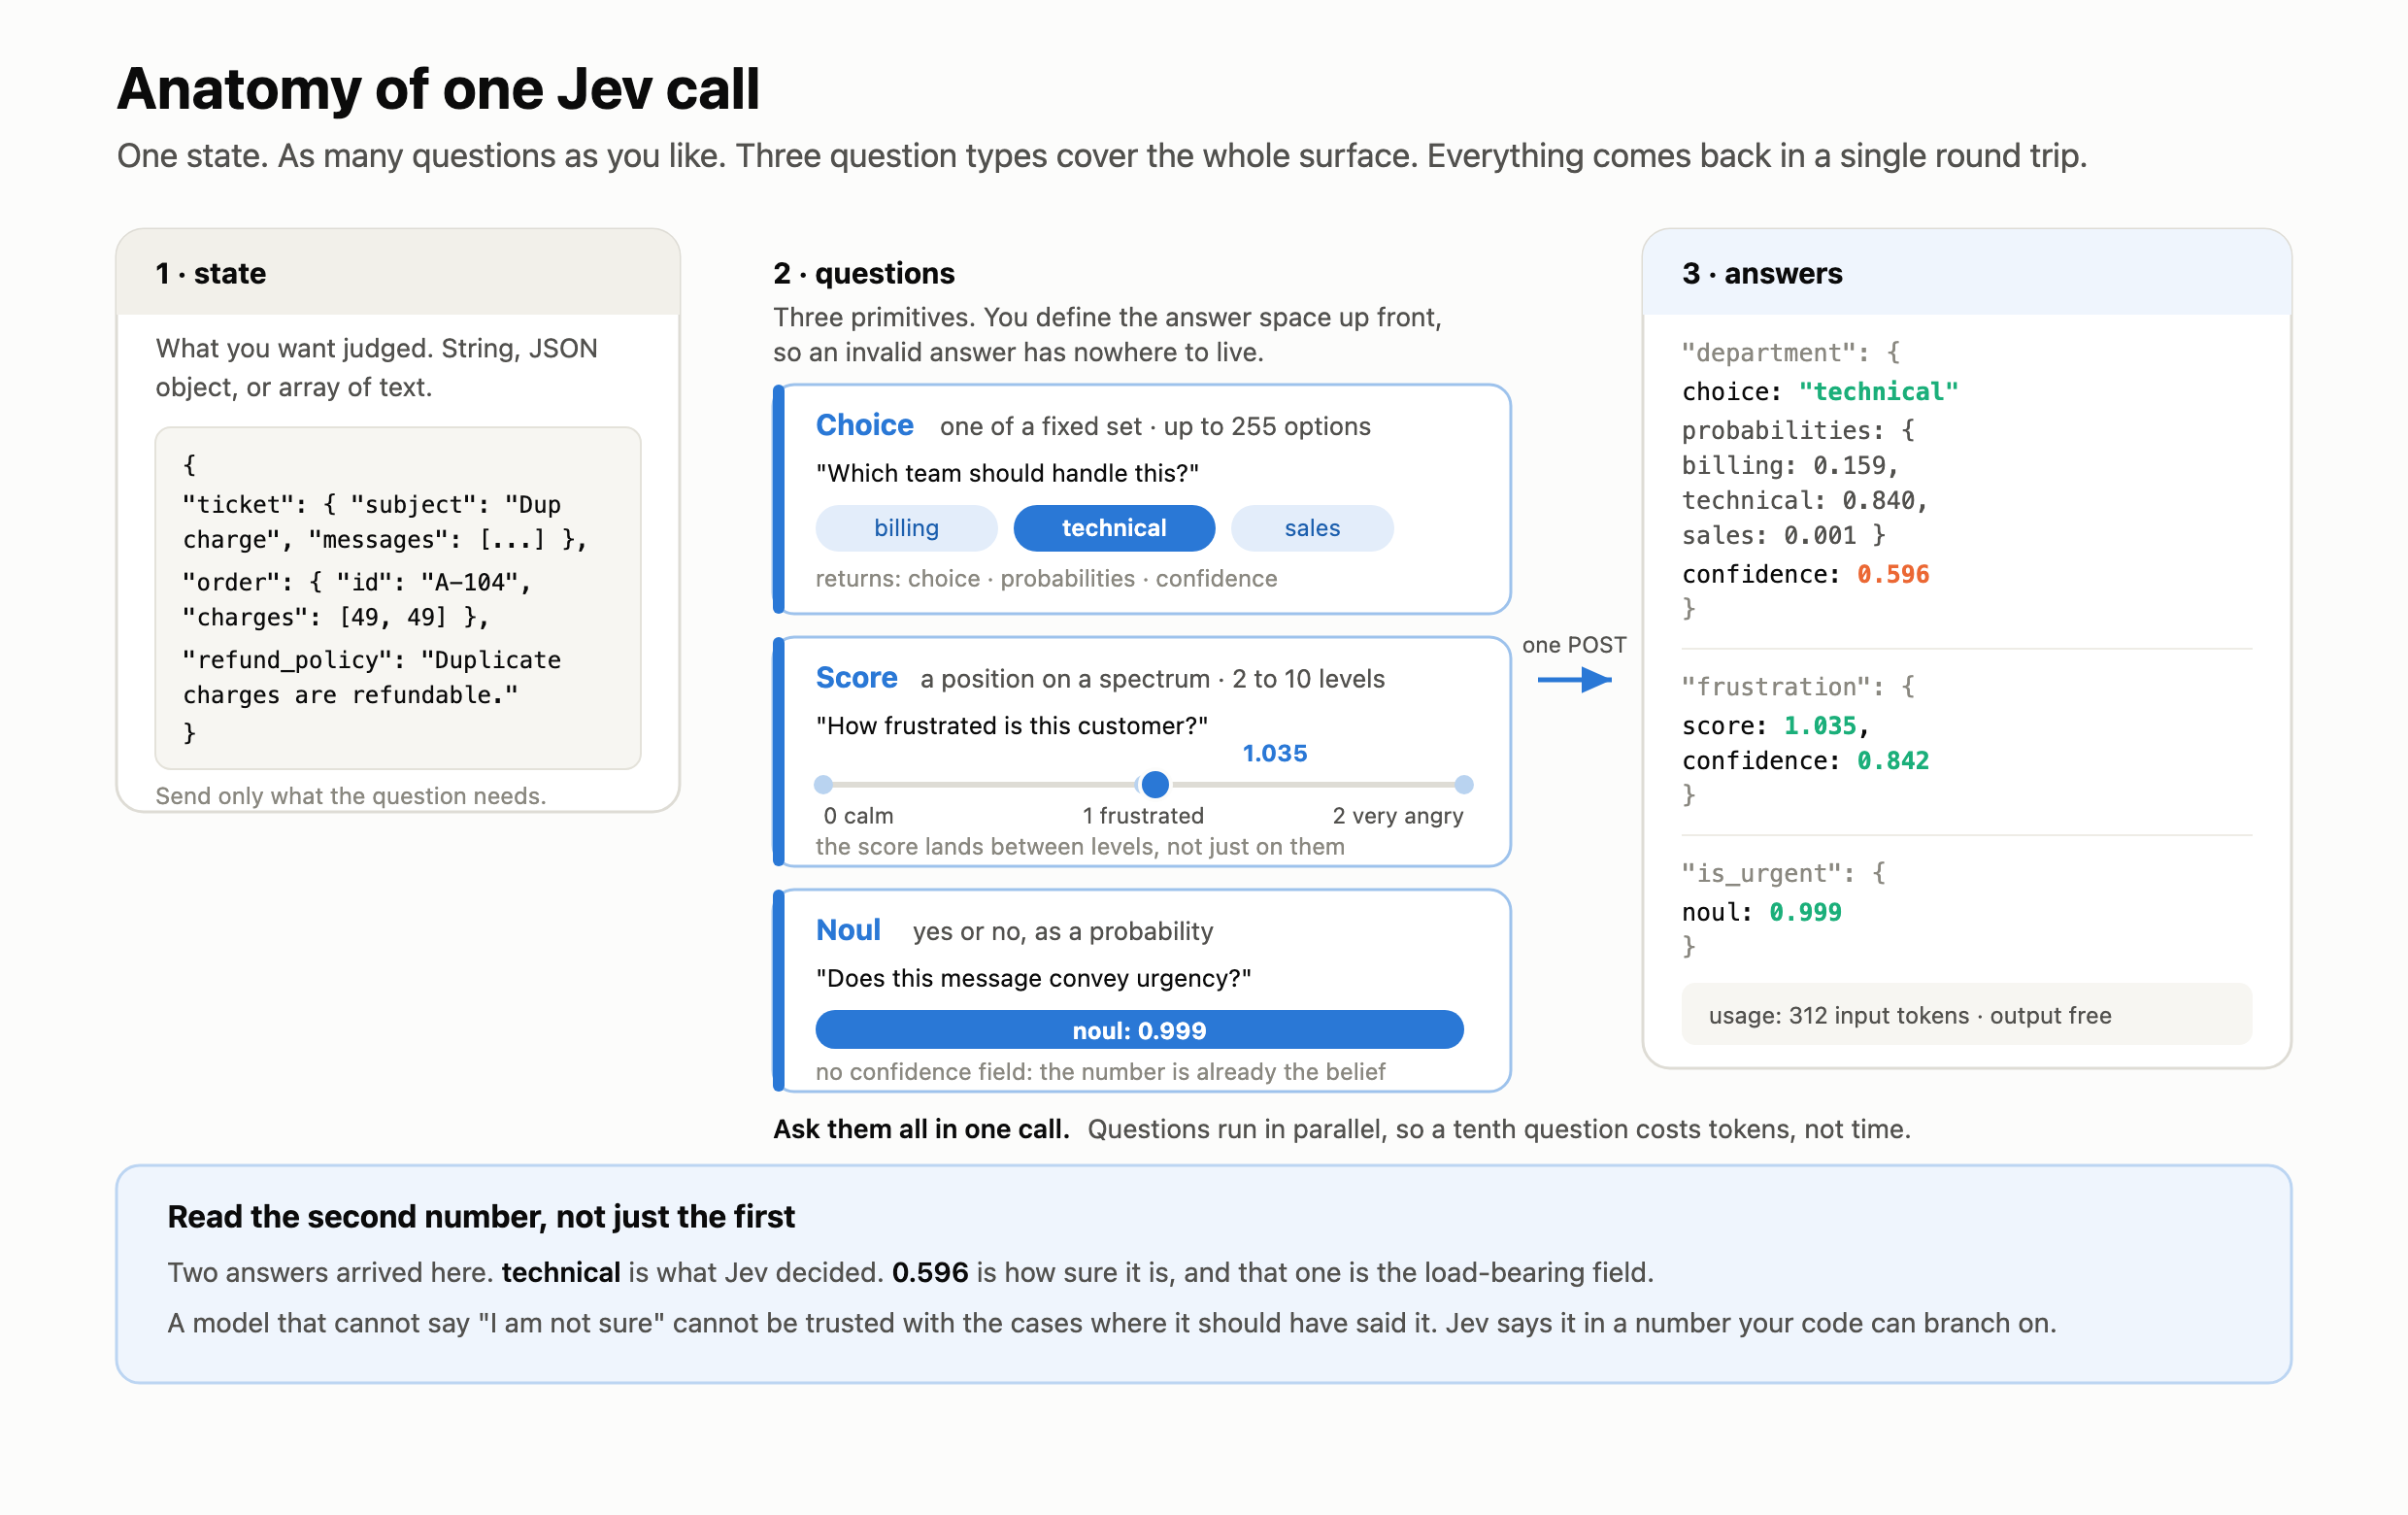
整個 API 就只有三種問題型別。這不是你要繞開的限制,而是它的設計本身。
Choice:從一組選項中選一個
Choice(
    instructions="Which team should handle this",
    criteria={
        "billing":   "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales":     "Pricing or account questions",
    },
)
會回傳 .choice、.probabilities(每個選項各一個),以及 .confidence。最多可支援 255 個選項,每個選項只會多吃一點 token,所以請直接傳完整團隊或分類清單,而不是只傳一小撮候選。建議加上一個明確的 other 選項,讓模型可以說「都不符合」,而不是硬選一個最接近但錯的答案。
Score:在一個尺度上的位置
Score(
    instructions="How frustrated the customer appears",
    criteria=[
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language",
    ],
)
兩到十個有順序的等級,以文字描述。會回傳 .score,這個分數可以落在等級之間(例如 1.035),另外還有 .probabilities 和 .confidence。等級索引由陣列順序決定,所以 level 0 就是第一個專案。
Noul:用機率表示是或否
Noul(instructions="The message conveys urgency or time-sensitivity")會回傳 .noul,一個介於 0 到 1 的單一數值:答案為 yes 的機率。沒有 confidence 欄位,因為這個數字本身就已經是信念程度。
實際組合起來
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state={
        "ticket": {
            "subject": "Duplicate charge",
            "messages": [
                {"from": "customer",
                 "text": "I was charged twice for order A-104. Please refund the duplicate."},
            ],
        },
        "order": {"id": "A-104", "charges": [
            {"amount_usd": 49, "status": "captured"},
            {"amount_usd": 49, "status": "captured"},
        ]},
        "refund_policy": "Duplicate charges are eligible for a refund.",
    },
    questions={
        "department":       Choice(instructions="Which team should handle this",
                                   criteria={"billing": "Payment or subscription issues",
                                             "technical": "Bugs or integration problems",
                                             "sales": "Pricing or account questions"}),
        "frustration":      Score(instructions="How frustrated the customer appears",
                                  criteria=["Calm, just stating facts",
                                            "Frustrated but civil",
                                            "Very angry, strong language"]),
        "refund_requested": Noul(instructions="The customer is explicitly asking for a refund"),
        "policy_supports":  Noul(instructions="The stated refund policy covers this situation"),
    },
)

dept = response.answers["department"]
print(dept.choice, dept.confidence)
print(response.answers["frustration"].score)
print(response.answers["refund_requested"].noul)
TypeScript 版本相同:
import { choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();

const response = await client.systemOne({
  state: { document: "I was charged twice. Please fix this ASAP." },
  questions: {
    category: choice("What is this ticket about?", {
      billing: "Payment or subscription issues",
      technical: "Bugs or integration problems",
      other: "Anything else",
    }),
    urgent: noul("The message conveys urgency"),
  },
});

console.log(response.answers.category.choice);  // 型別會根據你的問題推斷
state 可以是任何你需要的形式
可以是字串、JSON 物件或文字陣列。只要有超過一段上下文,就用物件。
state = "My card was charged twice."                               # 簡單情況
state = {"message": "...", "order_id": "A-104"}                    # 有命名欄位
state = ["Hi", "My customer number is TS1337.", "Charged twice."]   # 對話內容
只能是文字。沒有圖片、音訊或影片。先轉錄或加上字幕再說。
Context 限制 和 LLM 的作法不同,因為 state 只會被讀一次,而問題會在其上平行運算:
- state 與所有問題合計 64k tokens
- state 加上單一最長問題共 32k tokens
五個值得借鑑的模式
模式 1:投機式展開
問題會平行評估,所以 第十個問題會增加 token,但幾乎不增加時間。這顛覆了一般習慣:先丟一個便宜的請求,必要時再追問。正確做法是一次把所有問題問完,然後讓程式決定哪些答案有用。
response = client.system_one(
    state=ticket,
    questions={
        "category":       Choice(instructions="Broad category of this ticket",
                                 criteria={"bug_report": "Something is broken or erroring",
                                           "billing": "Charges, invoices, refunds",
                                           "feature_request": "Asking for new functionality",
                                           "account": "Login, permissions, security"}),
        # 只有在確實是 bug report 時才有意義。不管,先問。
        "bug_severity":   Score(instructions="How severe is the reported issue",
                                criteria=["Cosmetic; no impact",
                                          "Degraded feature; workaround exists",
                                          "Blocking; no workaround"]),
        "has_repro":      Noul(instructions="The user describes steps to reproduce"),
        # 只有在確實是 billing 時才有意義。不管,先問。
        "refund_wanted":  Noul(instructions="The user explicitly asks for a refund or credit"),
        "frustration":    Score(instructions="How frustrated the user appears",
                                criteria=["Calm", "Frustrated but civil", "Very angry"]),
    },
)

cat = response.answers["category"]

if cat.choice == "bug_report":
    if response.answers["bug_severity"].score > 1.5 and response.answers["has_repro"].noul > 0.6:
        escalate_to_engineering(ticket_id, severity="high")
    else:
        add_to_bug_backlog(ticket_id)
elif cat.choice == "billing" and response.answers["refund_wanted"].noul > 0.7:
    start_refund_flow(ticket_id)
TypeSafe 的 cookbook 用一篇很長的 Wikipedia 文章做 13 個問題的法規簡報,並指出把所有問題打包成一次呼叫,比起一次問一題,便宜 12.2 倍、速度快 10.0 倍,而且答案完全相同。
模式 2:以信心值為門檻的路由
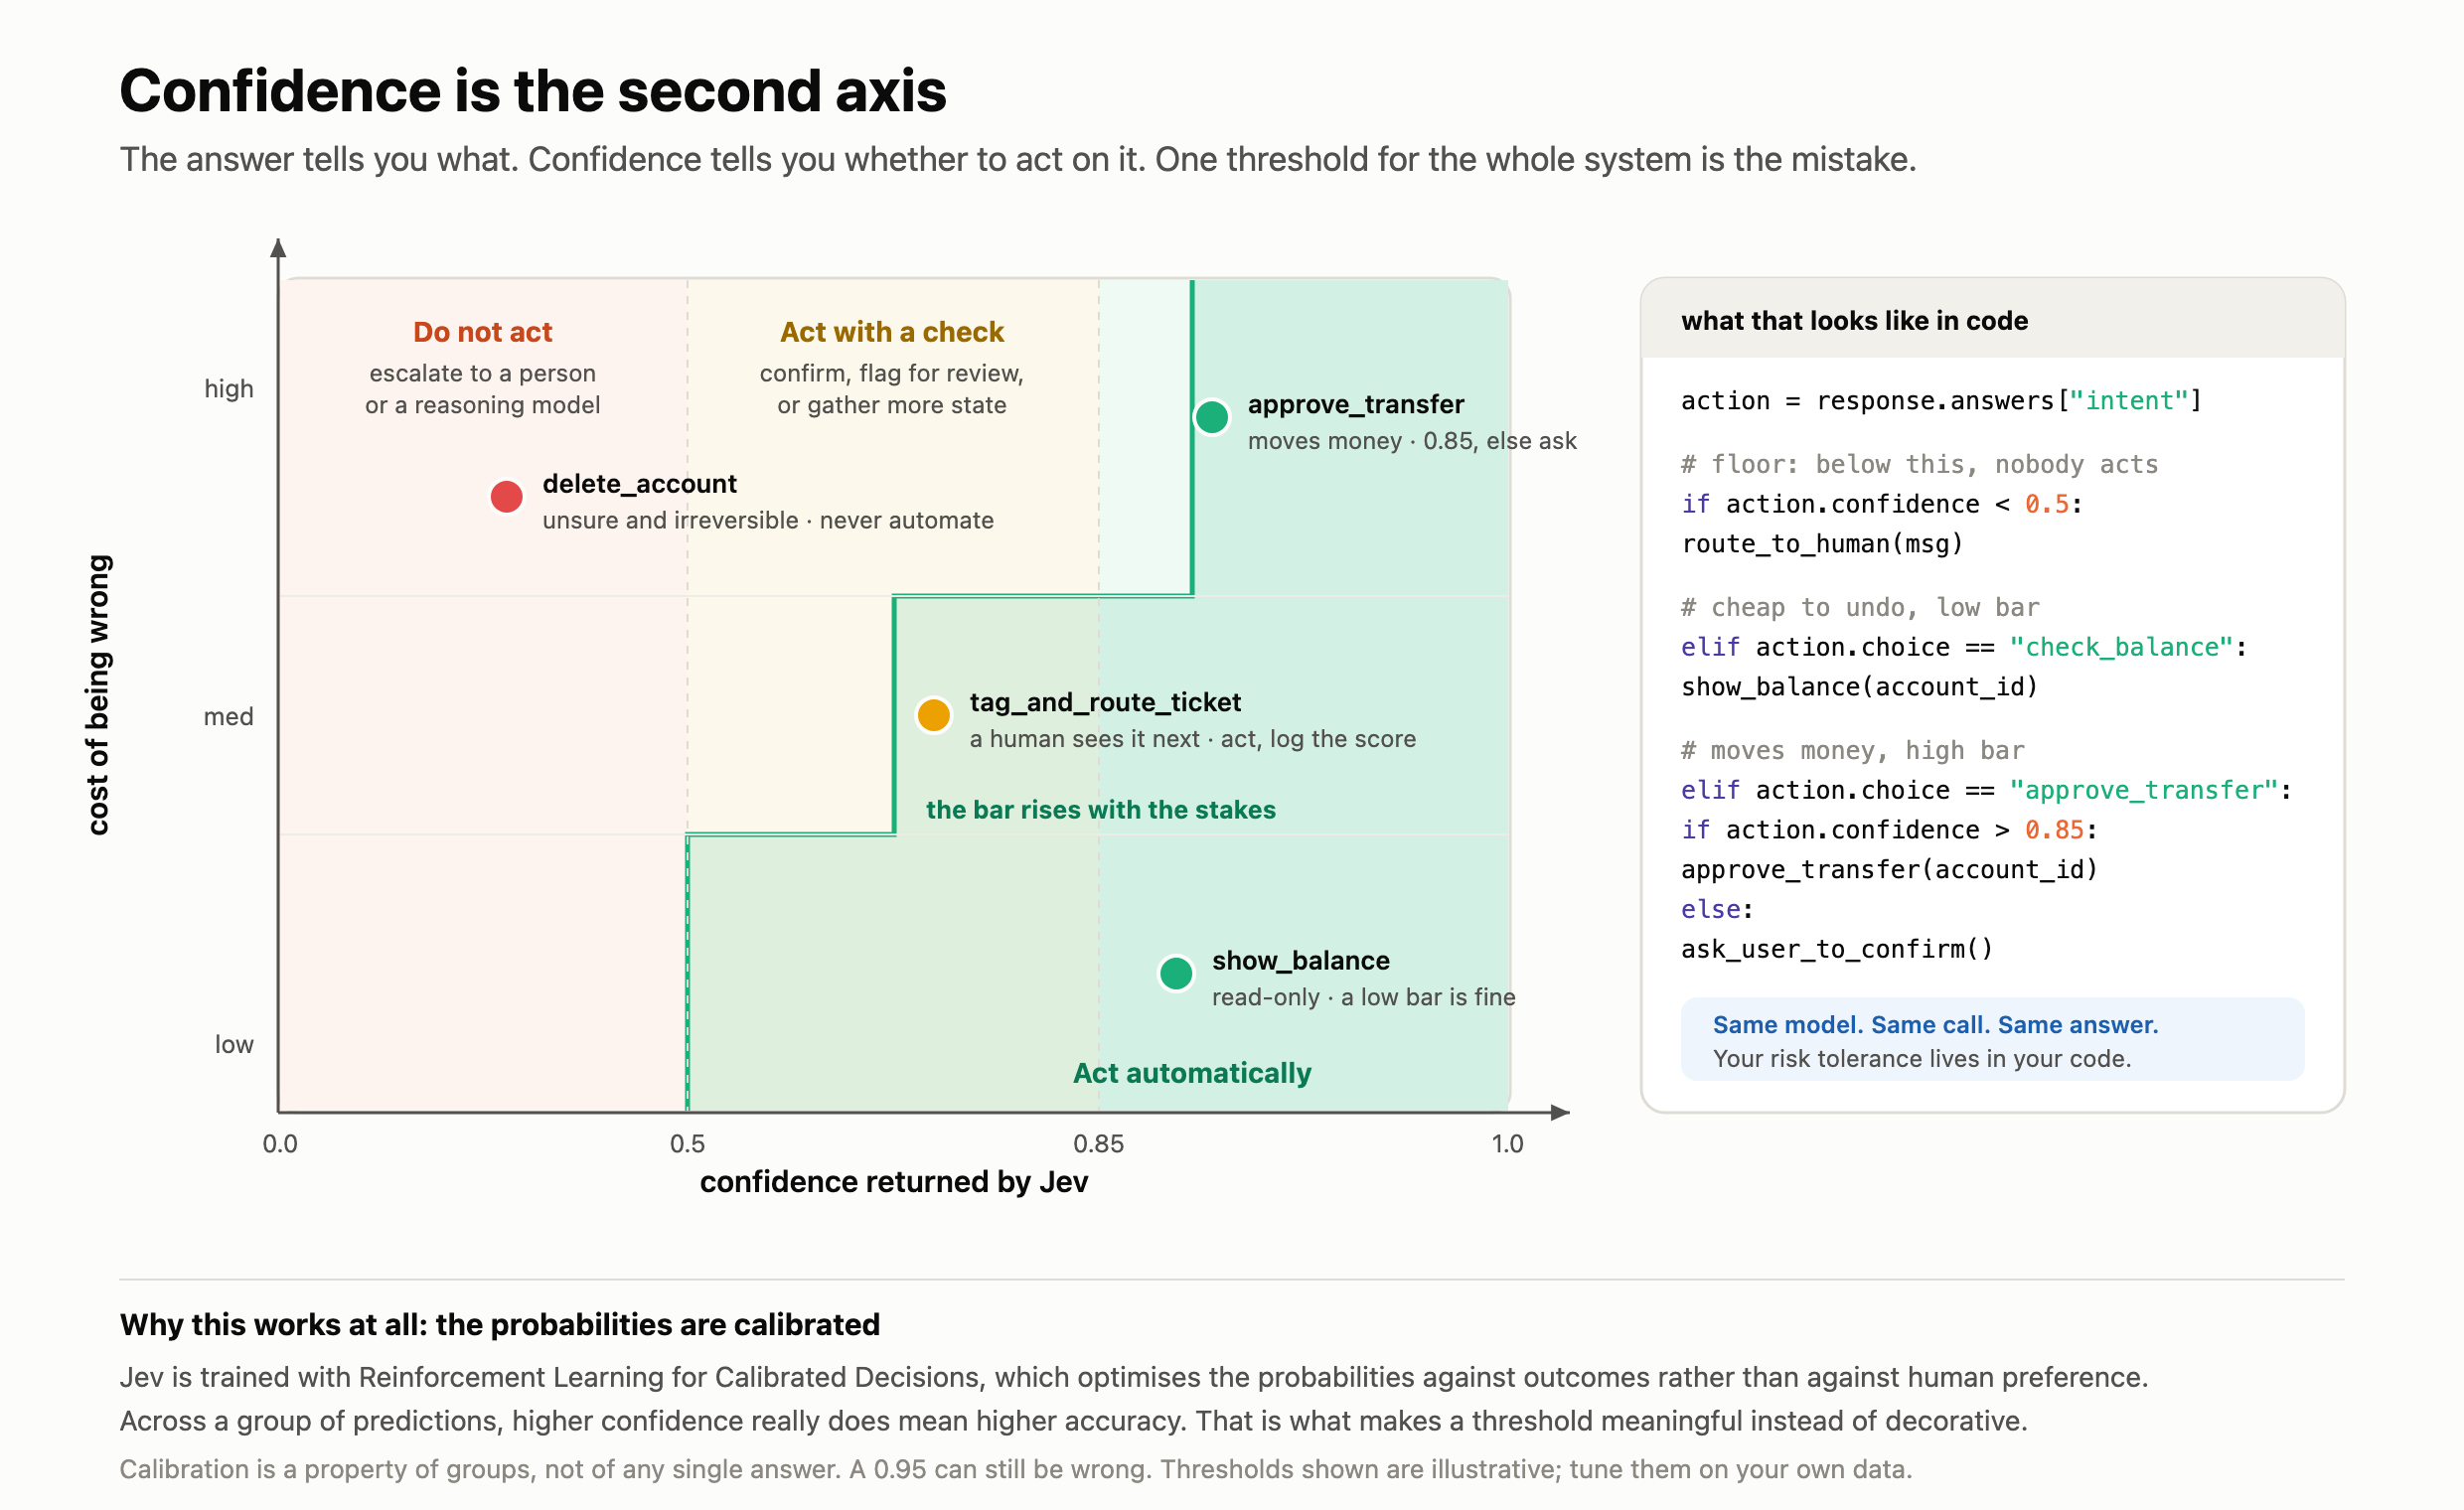
這個模式會改變你的架構。Jev 是用 RLCD(Reinforcement Learning for Calibrated Decisions,校準式決策強化學習)訓練,會根據結果而不是人類偏好來最佳化機率。因此 confidence 在整體上是有意義的:信心越高,確實通常代表正確率越高。
所以不要替整個系統寫一個統一門檻。每個動作都該有自己的門檻,並依照出錯代價調整。
action = response.answers["intent"]

if action.confidence < 0.5:
    route_to_human(user_message)                  # 底線:真的不確定

elif action.choice == "check_balance":
    show_balance(account_id)                      # 只讀操作,門檻低

elif action.choice == "approve_transfer":
    if action.confidence > 0.85:                  # 會動到錢,門檻高
        approve_transfer(account_id)
    else:
        ask_user_to_confirm("Approve this transfer?")

else:
    route_to_human(user_message)
如果 TypeSafe 的 confidence 統計不是你要的指標,你也可以直接拿原始的 .probabilities。如果分佈很平均,代表它無法從你給的 state 分辨這些選項;這通常是在暗示你的 criteria 有問題,而不是模型混亂。
模式 3:組合式評分
把模糊判斷拆成彼此獨立的維度,逐一評分,再用你自己控制的權重組合。這比直接問「這個候選人有多好」更好,因為後者把好幾個判斷包成一個答案。
response = client.system_one(
    state=resume_text,
    questions={
        "python_depth":    Score(instructions="Depth of Python experience shown",
                                 criteria=["None mentioned", "Mentioned, no detail",
                                           "Used in projects", "Primary language",
                                           "Deep expertise: architecture, performance"]),
        "team_leadership": Score(instructions="Experience leading engineering teams",
                                 criteria=["None", "Informal mentorship", "Led a small team",
                                           "Managed direct reports", "Managed multiple teams"]),
        "system_design":   Score(instructions="Experience designing distributed systems",
                                 criteria=["None mentioned", "Contributed to discussions",
                                           "Designed components", "Owned a system's architecture",
                                           "Designed at scale across domains"]),
    },
)

a = response.answers
composite = (
    0.40 * (a["python_depth"].score / 4) +
    0.25 * (a["team_leadership"].score / 4) +
    0.35 * (a["system_design"].score / 4)
)
現在要重新加權只需要改程式碼,不需要重寫 prompt。你也可以做 A/B test。
模式 4:級聯流程
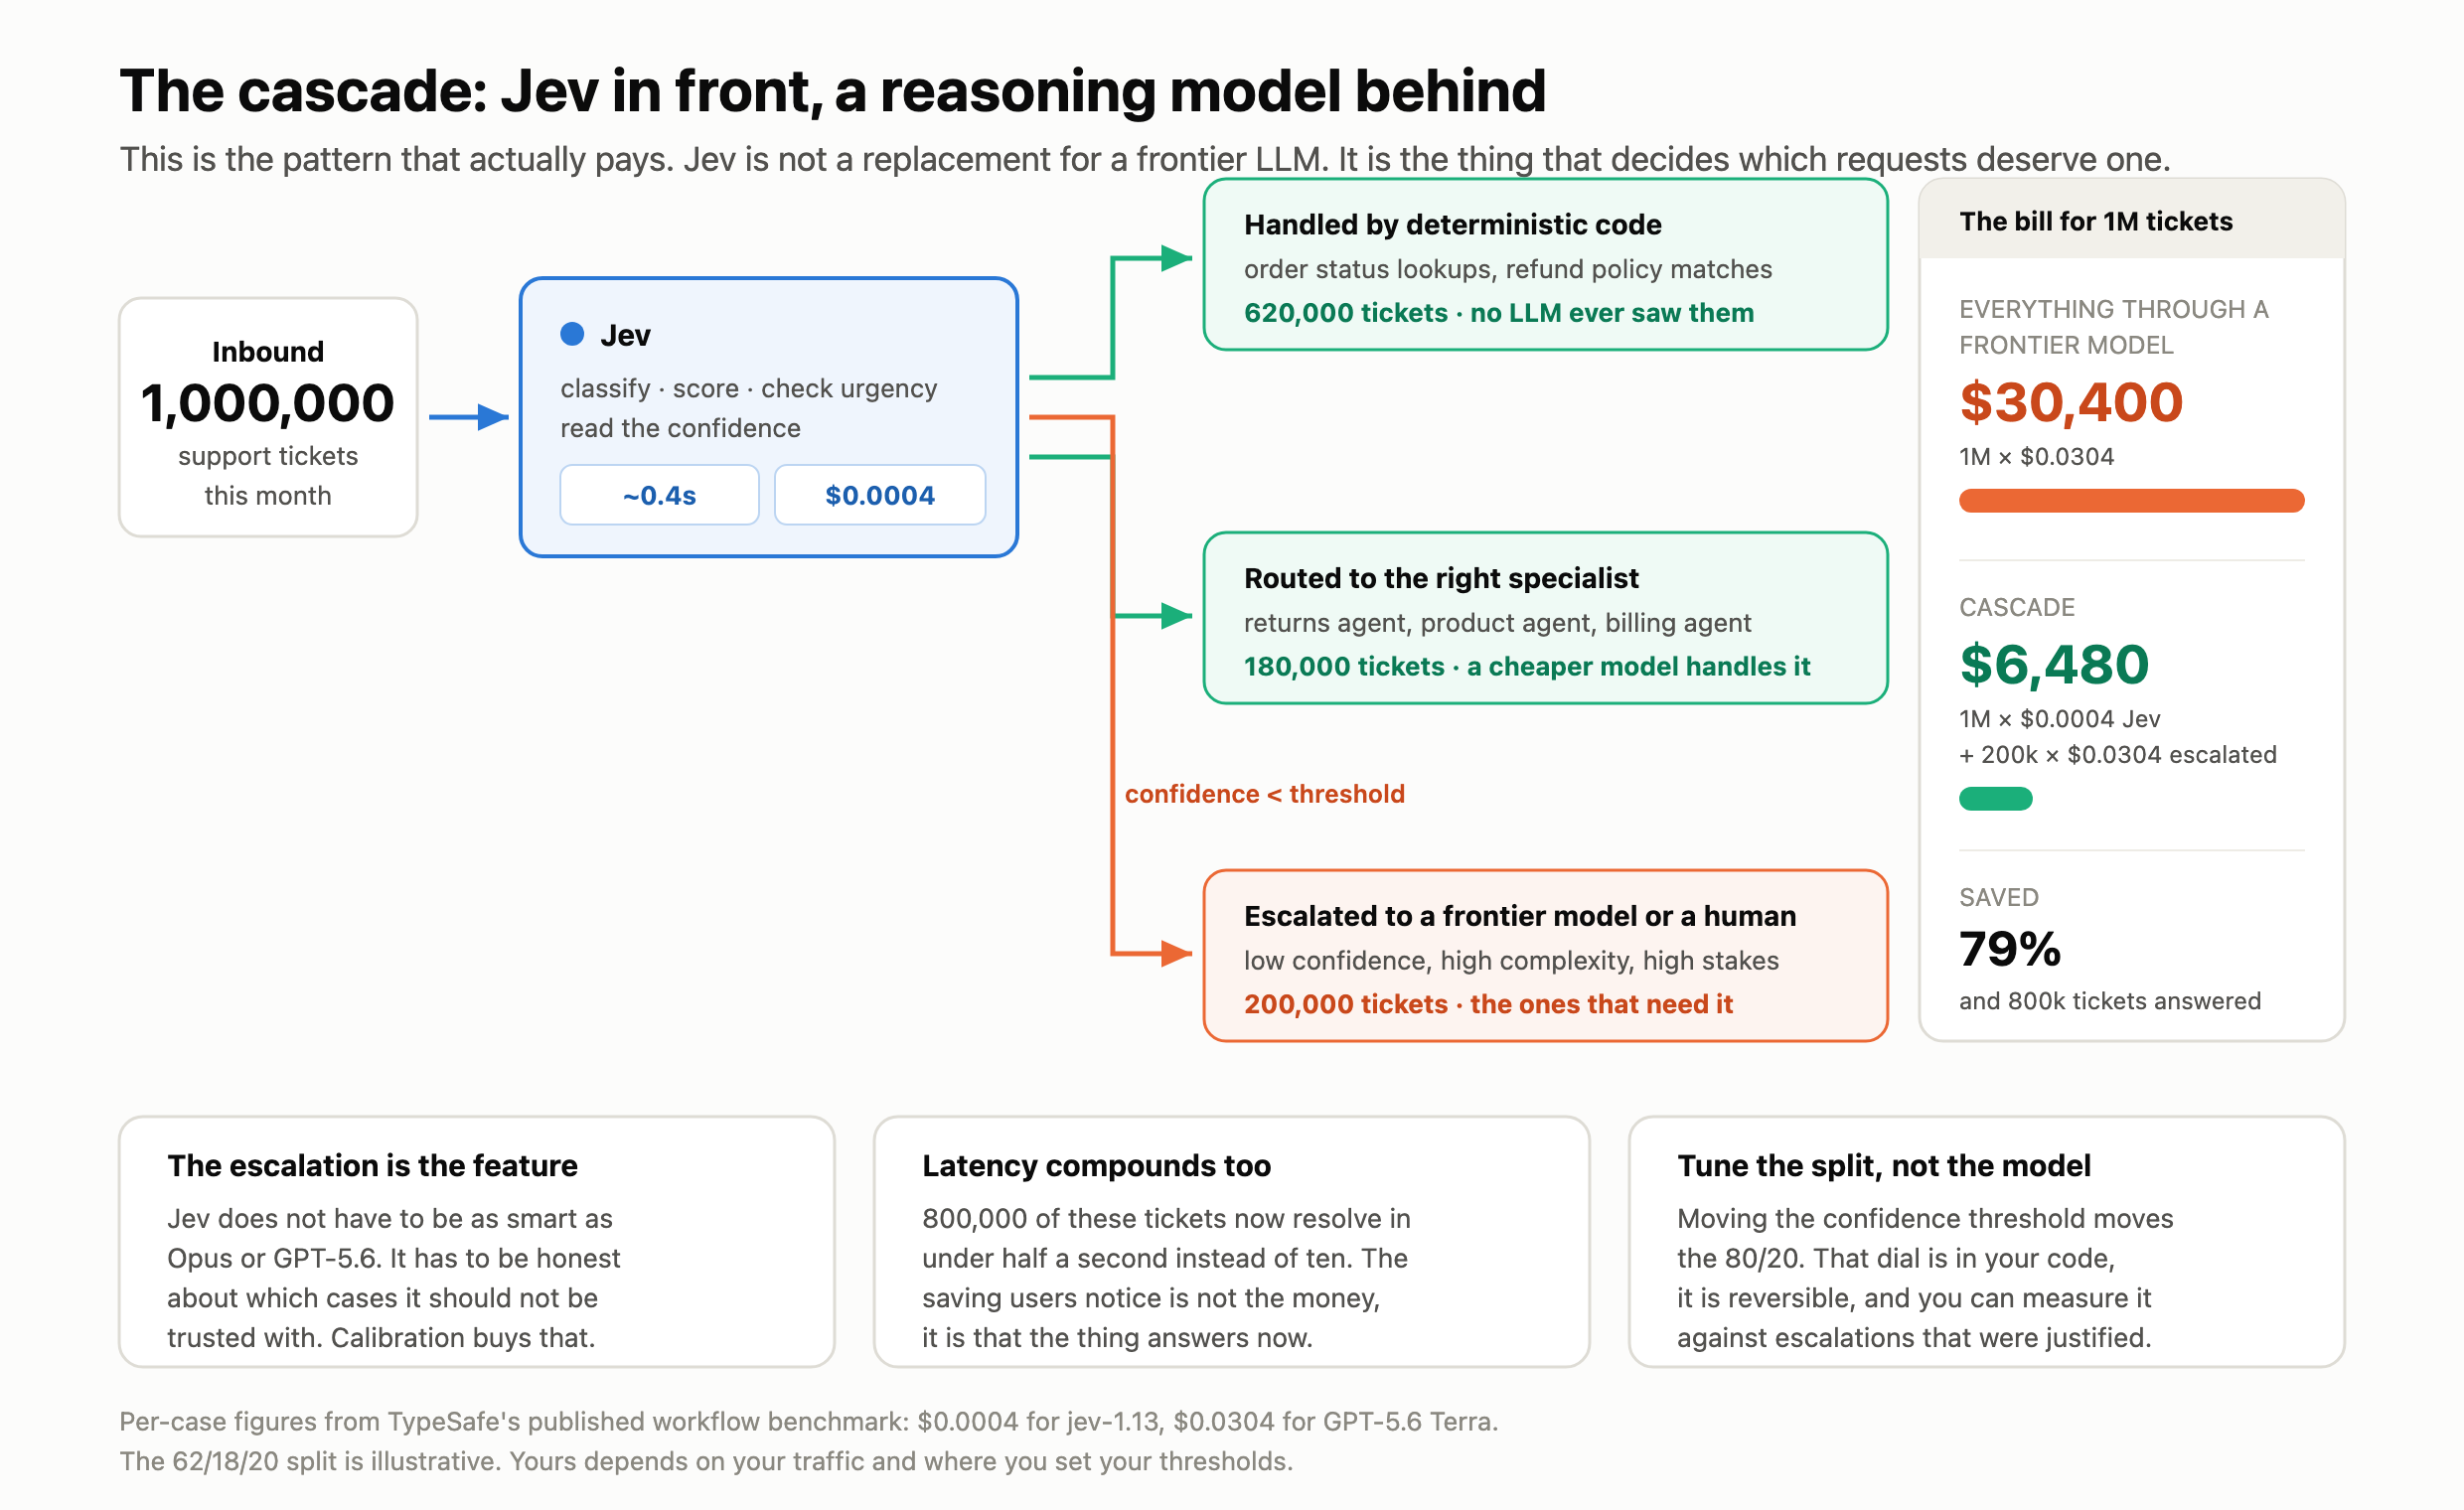
Jev 不是 Opus 5 或 GPT-5.6 的替代品。它是用來決定哪些請求值得交給它們處理的那個東西。
def handle(message):
    r = client.system_one(
        state=message,
        questions={
            "intent":     Choice(instructions="Primary intent of this message",
                                 criteria={"order_status": "Asking about an existing order",
                                           "product_question": "Asking about a product",
                                           "return_exchange": "Wants to return or exchange",
                                           "complaint": "Unhappy, wants resolution"}),
            "complexity": Score(instructions="How complex is this to resolve",
                                criteria=["Simple lookup or standard procedure",
                                          "Requires judgment or multiple steps",
                                          "Unusual edge case, escalation needed"]),
        },
    )
    intent, complexity = r.answers["intent"], r.answers["complexity"]

    if intent.confidence < 0.5:
        return route_to_human(message)

    if intent.choice == "order_status":
        return lookup_order(message)                      # 純程式碼,完全不用 LLM
    if intent.choice == "product_question":
        return handle_with_llm(message, PRODUCT_SPECIALIST)
    if intent.choice == "return_exchange":
        return handle_with_llm(message, RETURNS_SPECIALIST)
    if intent.choice == "complaint":
        if complexity.score > 1 or complexity.confidence < 0.5:
            return route_to_human(message)
        return handle_with_llm(message, COMPLAINT_RESOLUTION)
一條分支完全不碰模型。兩條分支呼叫不同專家。一條則升級處理。
以一百萬張票來看,依 TypeSafe 的單筆估算,大約是 $6,480,而不是 $30,400,其中約 80 萬筆能在半秒內完成,而不是十秒。
模式 5:先檢索,再判斷
在那個級聯流程裡,有一步是 Jev 不做的,而這一步決定了後面所有事情的上限。
Jev 對你交給它的 state 之外一無所知。它不能查詢外部資料。而 jaggedness 頁面也直白地指出:當 state 裡填進了問題不需要的材料時,準確率就會下降:「先在程式裡做 retrieve 與 filter,只把問題需要的欄位送進去。」
把這兩句合在一起,後果就很明確。組 state 的那一層,決定了 Jev 被允許知道什麼。你若塞太多,準確率會被 context 汙染拖垮。你若只依賴弱來源,Jev 仍然只會對那份差材料做出校準良好的判斷,因為 state 就是它唯一的世界。
所以完整模式應該是兩層:精準擷取,再便宜判斷。
from valyu import Valyu
from typesafe_sdk import Noul, Score, TypeSafeClient

valyu = Valyu()          # 讀取 VALYU_API_KEY
jev = TypeSafeClient()   # 讀取 TYPESAFE_API_KEY

# 1. 檢索:先從主要來源過濾,才讓任何東西進入模型。
hits = valyu.search(
    "GLP-1 receptor agonists cardiovascular outcomes",
    included_sources=["valyu/valyu-pubmed", "valyu/valyu-arxiv"],
    start_date="2024-01-01",
    max_num_results=20,
    relevance_threshold=0.5,
)

# 2. 判斷:每篇論文一次有限呼叫,約每篇 $0.0004。
shortlist = []
for paper in hits.results:
    verdict = jev.system_one(
        state={"title": paper.title, "source": paper.url, "content": paper.content},
        questions={
            "is_rct": Noul(
                instructions="This paper reports a randomised controlled trial"),
            "reports_mace": Noul(
                instructions="The paper reports major adverse cardiovascular events as an outcome"),
            "evidence_strength": Score(
                instructions="How strong is the causal evidence presented",
                criteria=["Anecdotal or preclinical",
                          "Observational",
                          "Single randomised trial",
                          "Meta-analysis of randomised trials"],
            ),
        },
    )
    a = verdict.answers
    if a["is_rct"].noul > 0.7 and a["evidence_strength"].score > 1.5:
        shortlist.append((paper, a["evidence_strength"].confidence))
用不到一美分就能篩選 20 篇論文、比較四個維度,而且依據的是原始文獻,而不是一般爬蟲隨便抓到的東西。
這不只適用於文獻回顧。TypeSafe 自己的 RAG passage classification 和 citation check cookbooks 也是同樣的形狀:先大範圍檢索,再用每個 passage 一個 Noul 先篩 relevance,之後才讓昂貴的步驟看到。以 $0.042/MTok 且輸出免費的價格來看,這個 filter 的成本比它省下的 context window 還低。
前 48 小時大家做出了什麼
Jev 在 9 月 15 日上線。所以以下請當成 launch week 的作品,而不是 production case study,且要注意這些數字都由作者自行回報。採用時請保持判斷。
1,018 篇研究論文只花 $0.08 就完成分類
1kpapers.com by Hassan El Mghari(thread)
這是最清楚的經濟性展示,因為它在同一條 pipeline 裡同時跑生成模型與決策模型,並把各自帳單都顯示出來:
- 用 DeepSeek V4 Flash 對 1,018 篇論文做摘要
- 將 title + summary + 24 個候選主題送進 Jev
- 用一個 Choice 完成分類
- 視覺化
摘要:$3.99。分類:$0.08。 每篇論文中位端到端延遲 256ms。
「我認為未來會往這個方向走:工作流程的不同部分用不同模型,而不是全部都用同一個模型。」
他也提到,在把既有分類換掉之前,會先針對 Jev 的分類結果做 eval,這才是對的直覺,也是大多數 launch week demo 會跳過的部分。
一個能在 7.1 秒內訂好機票的瀏覽器代理
browser-use/jev-ultrafast · 641 stars · Python
Browser Use 的 Gregor Zunic 做出了一個具有動態索引動作空間的瀏覽器代理。每次 observation 都會把頁面轉成一張編號元素表。一次 Jev 請求會同時決定操作(CLICK、TYPE_TEXT、SELECT、SCROLL、WAIT、DONE、BLOCKED)與目標。只有當操作是 TYPE_TEXT 時,才會再叫一個小型 LLM。
真實 Google Flights 上的蘇黎世到倫敦,含頁面載入,7.1 秒、$0.0039。
設計上的技巧是把投機式展開用在動作上:點擊、輸入、選擇的目標都在同一輪往返中一起問,最後只執行與所選操作相符的那一個。兩個決策,一次網路呼叫。
每一步只要 $0.0002 的電腦操作
這個專案驅動一台 Mac 去達成一個自然語言目標,而且不把螢幕截圖送給大型模型。OCR 負責讀畫面,Jev 決定下一步動作,只有在需要自由文字時才會叫寫作模型。
| Jev | Opus 5(純螢幕截圖) | |
|---|---|---|
| 每個決策成本 | $0.0002 | $0.032 |
| 每個 12 步任務成本 | $0.003 | $0.40 到 $0.90 |
| 模型延遲 | 0.13 到 0.38s | 5.2s |
| 端到端每步 | 約 1.5s | 約 5.5s |
作者在 README 裡最有價值的一句話是:前沿模型能直接從像素讀出事件日期並自行比較,但分類器必須把明確的日期解析機制建在外面。「前沿模型免費完成的每一點推理,在這裡都必須以 deterministic state 的形式重建。」
一個每約 300ms 區塊就做一次決策的做市商
每個 Monad 區塊做一次決策。Jev 讀取 Kuru 的 MON-USDC order book,回答買或賣;機器人會在最接近的報價內側一跳掛出 post-only 限價單,因此賺的是價差,而不是付出價差。事件流中回報的模型延遲約為 81ms,而 hot loop 只做兩次 RPC 往返,以符合區塊時間預算。附帶 dry-run 模式,使用真實 order book 資料與模擬成交。
一架在 2.5Hz 下做判斷的自主無人機
值得研究的是它把 Jev 放在非常合適的位置:
| 速率 | 層級 | 擁有者 |
|---|---|---|
| 500 Hz | 幾何飛行控制器 | 程式碼 |
| 50 Hz | 導引與安全反射 | 程式碼,永遠掌管安全 |
| 15 Hz | 影像到符號化場景 | 傳統電腦視覺 |
| 約 2.5 Hz | 戰術判斷 | Jev,僅供建議 |
傳統電腦視覺會把深度與分割壓縮成距離扇區、障礙物高度與目標方位。Jev 一次回答三個問題:對 manoeuvre 做 Choice、對風險做 Score、對目標是否真的丟失或只是暫時遮蔽做 Noul。正如 README 所說,Jev「不能成為感知層,也不能以控制頻率執行」。
其他也值得一看
- fhshaik/typesafe-mario(73★)透過模擬器 RAM 轉成以物件為中心的 JSON 來玩《超級瑪利歐兄弟》。沒有螢幕截圖。
- devagrawal09/jev-review(48★)是一個分階段的程式碼審查器:先做 Noul 風險矩陣,再做 Choice/Score 檔案設定檔、證據選擇、嚴重程度與條件式路由。
- TheoLeeCJ/openjev(166★)在一個 4B 開源模型的 logits 上,以一次前向傳播讀出帶型別的選項機率。它明確表示自己重現的是介面模式,不是 Jev 的模型或訓練方法。
- phyous/tsai-sc 讓 Jev 在 421 次決策中完成《星海爭霸》共享版的第一個任務,並附上驗證報告。
- AbdelStark/awesome-typesafe 彙整整個生態系,並標註哪些結果依賴私有資料或單次執行。
這些專案共同的模式: 把迴圈、安全性與算術留在一般程式碼裡,讓 Jev 去處理中間那段難以用程式表達的狹窄判斷。
失敗模式(上線前先讀)
TypeSafe 有一頁叫做 "jaggedness",列出 jev-1.13 不擅長的地方。這份文件對一次產品發布來說意外地誠實,而且能幫你省下一週。
它會照字面理解。 Jev 回答的是你寫出的問題,不是你原本想問的那個。否定、範圍詞與隱含條件都會被照表面接收。判斷方法:你看到錯誤答案時,會忍不住開始解釋自己真正的意思;那段解釋就是你指令中缺少的一半。
它不是計算機。 它不會可靠地計數,而且錯誤率會隨著被計算物件的規模增加。請在程式裡迭代,然後每個專案問一個 Noul:
result = client.system_one(
    {"items": items},
    {f"item_{i}": Noul(instructions=f"Is `items[{i}]` the name of a fruit?")
     for i in range(len(items))},
)
count = sum(result.nouls[f"item_{i}"].noul > 0.5 for i in range(len(items)))
日期對它來說只是文字,不是有順序的量。 哪個日期先、相差多久、某個日期是否落在某個區間內:都不可靠。擷取本身是判斷,所以要用一個涵蓋月份與日期列舉的 Choice,並加上明確的「未提及」選項。組合與排序屬於算術,請留在程式裡。
context 汙染是真實存在的。 當 state 裡塞入了問題不需要的材料時,準確率就會下降。先做檢索與過濾。
state 不會被視為惡意輸入。 如果你放進 state 的文字本身是為了操控分類結果,那就是你的威脅模型要處理的事。要測試。
互相矛盾的指令與 criteria 會讓它混亂。 一個 true 對應到「no」的 Noul 會表現不佳。請把 criteria 當成 instructions 的延伸。
它不會生成。 不會產出文字、程式碼或摘要。如果你需要從自由文字中抽取某個值,先用 regex 或生成模型找出候選,再讓 Jev 做選擇。
來自他們文件中的一條元規則,其實也是普遍適用的好設計建議:
避免問模型那些程式可以精確計算的事。避免把好幾個判斷藏在同一個問題裡。
營運注意事項
jev-1.13 的 rate limit 是每秒 250,000 tokens 與每分鐘 1,200 requests。超過任一上限都會回傳 429。兩個 SDK 都會用 exponential backoff 重試,並遵守 retry-after。TypeSafe 提醒這些限制會在 GPU 容量到位前不預告地調整。
如果你有調整門檻,請固定版本。 jev-latest 目前對應到 jev-1.13.0,但新版本釋出時會變動,這可能讓你的答案跟著改變。回應裡的 model 欄位會回報實際回答的版本 ID,所以請記錄它。
client = TypeSafeClient(model="jev-1.13.0") # 固定版本計費只算輸入。 輸出 token 免費,所以投機式展開很便宜,也因為如此,在 Choice 裡多加選項幾乎不花錢。
如果你是用 coding agent,還有一個 agent skill:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
# 或者,其他 agent:
npx skills add typesafe-ai/skills --skill typesafe-ai
誠實的成績單
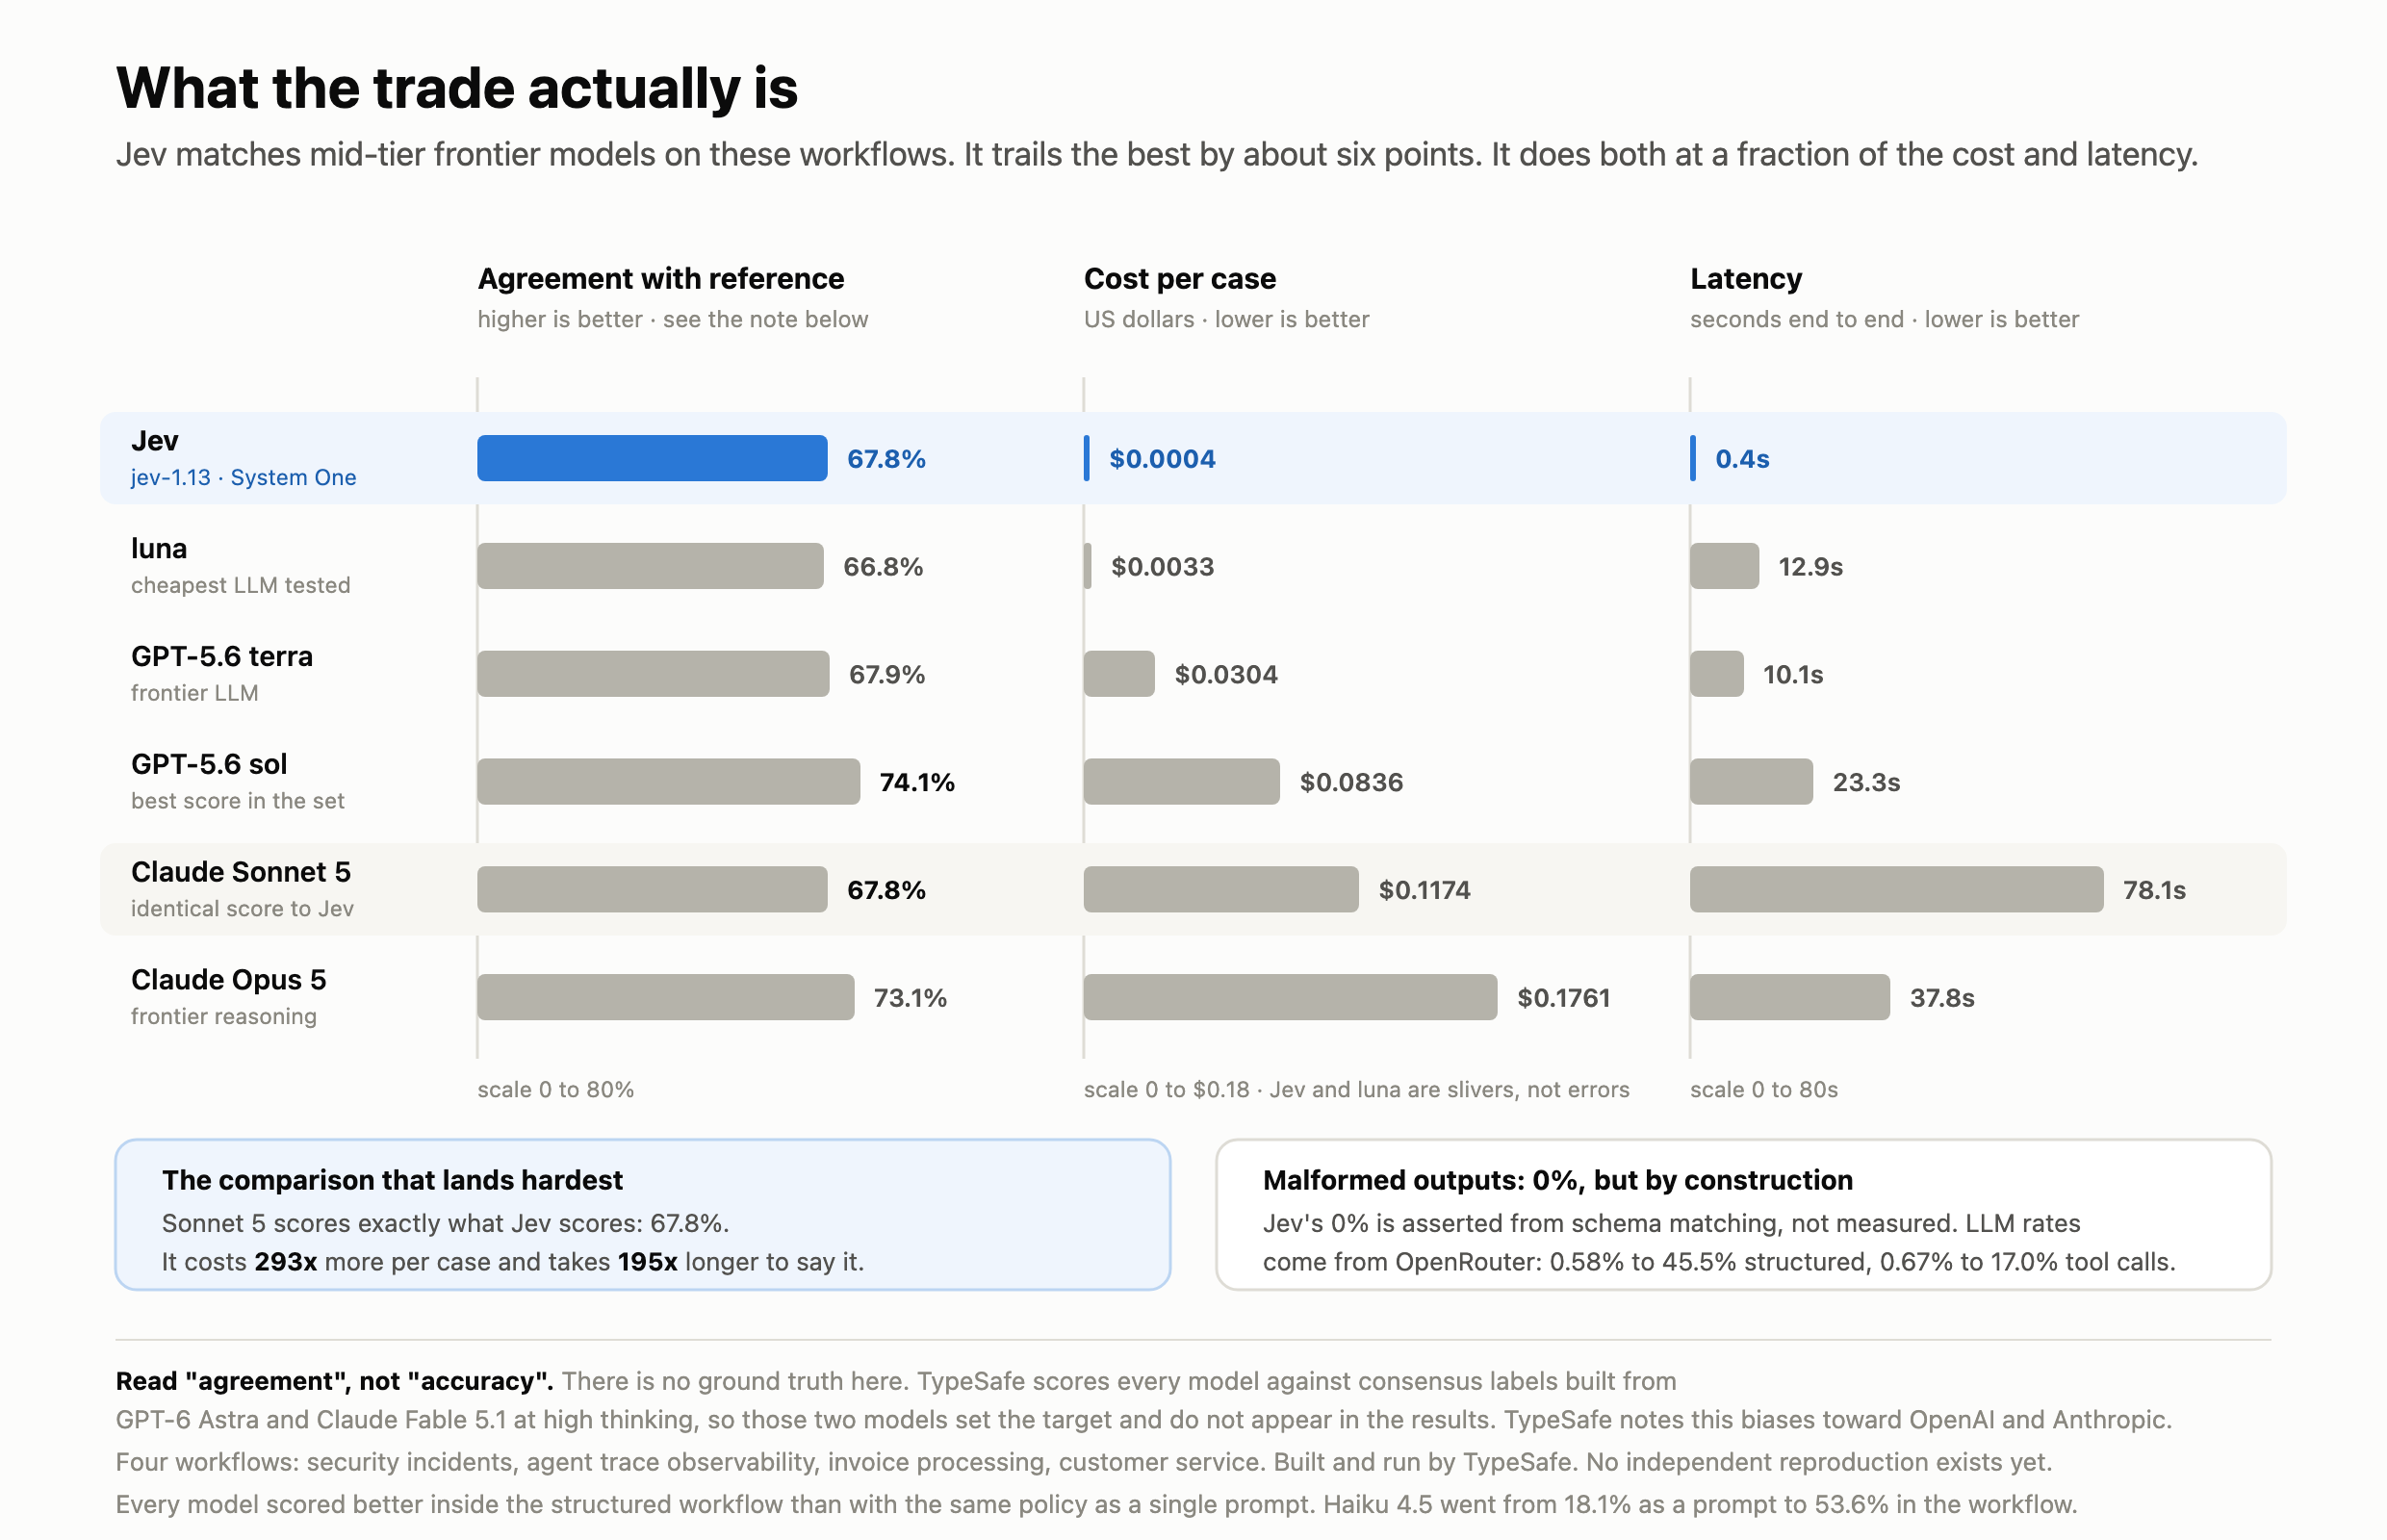
在 TypeSafe 的四個工作流程評估中,Jev 得分 67.8%,與 GPT-5.6 Terra(67.9%)幾乎持平,落後 Sol(74.1%)與 Opus 5(73.1%),但成本約為 1/200、延遲約為 1/50。
最刺眼的一句是:Claude Sonnet 5 也剛好是 67.8%,但每個案例的成本高出 293 倍,延遲高出 195 倍。
有四件事要記住:
- 那一欄不是 accuracy。 沒有 ground truth。TypeSafe 是把 GPT-6 Astra 與 Claude Fable 5.1 在高思考模式下的結果平均,建立 consensus labels,再拿大家去比對那些標籤。它測的是和兩個前沿模型的共識程度,所以結果裡才沒有把它們列進去。TypeSafe 表示這會偏向 OpenAI 與 Anthropic。
- 這是自家跑的結果。 TypeSafe 自己設計工作流程、建測試框架、自己執行。沒有獨立重現。請用你自己的流量評估。
- 「不會幻覺」比聽起來更狹義。 Jev 不會回傳 schema 之外的無效值,但它可以回傳錯的、但合法的值。那個 0% 是宣稱,不是測得的:「我們的數字不是經驗值。Schema matching 是保證的,所以我們可以自信地把 0% 放進圖表。」45.5% 的比較只是一個離群值(Haiku 4.5);多數模型介於 0.58% 到 13.2%。
- 價格可能會變。 TypeSafe 無法證明目前沒有補貼,不過它表示預期價格會下降而不是上升。
我會在什麼情況下真的使用它
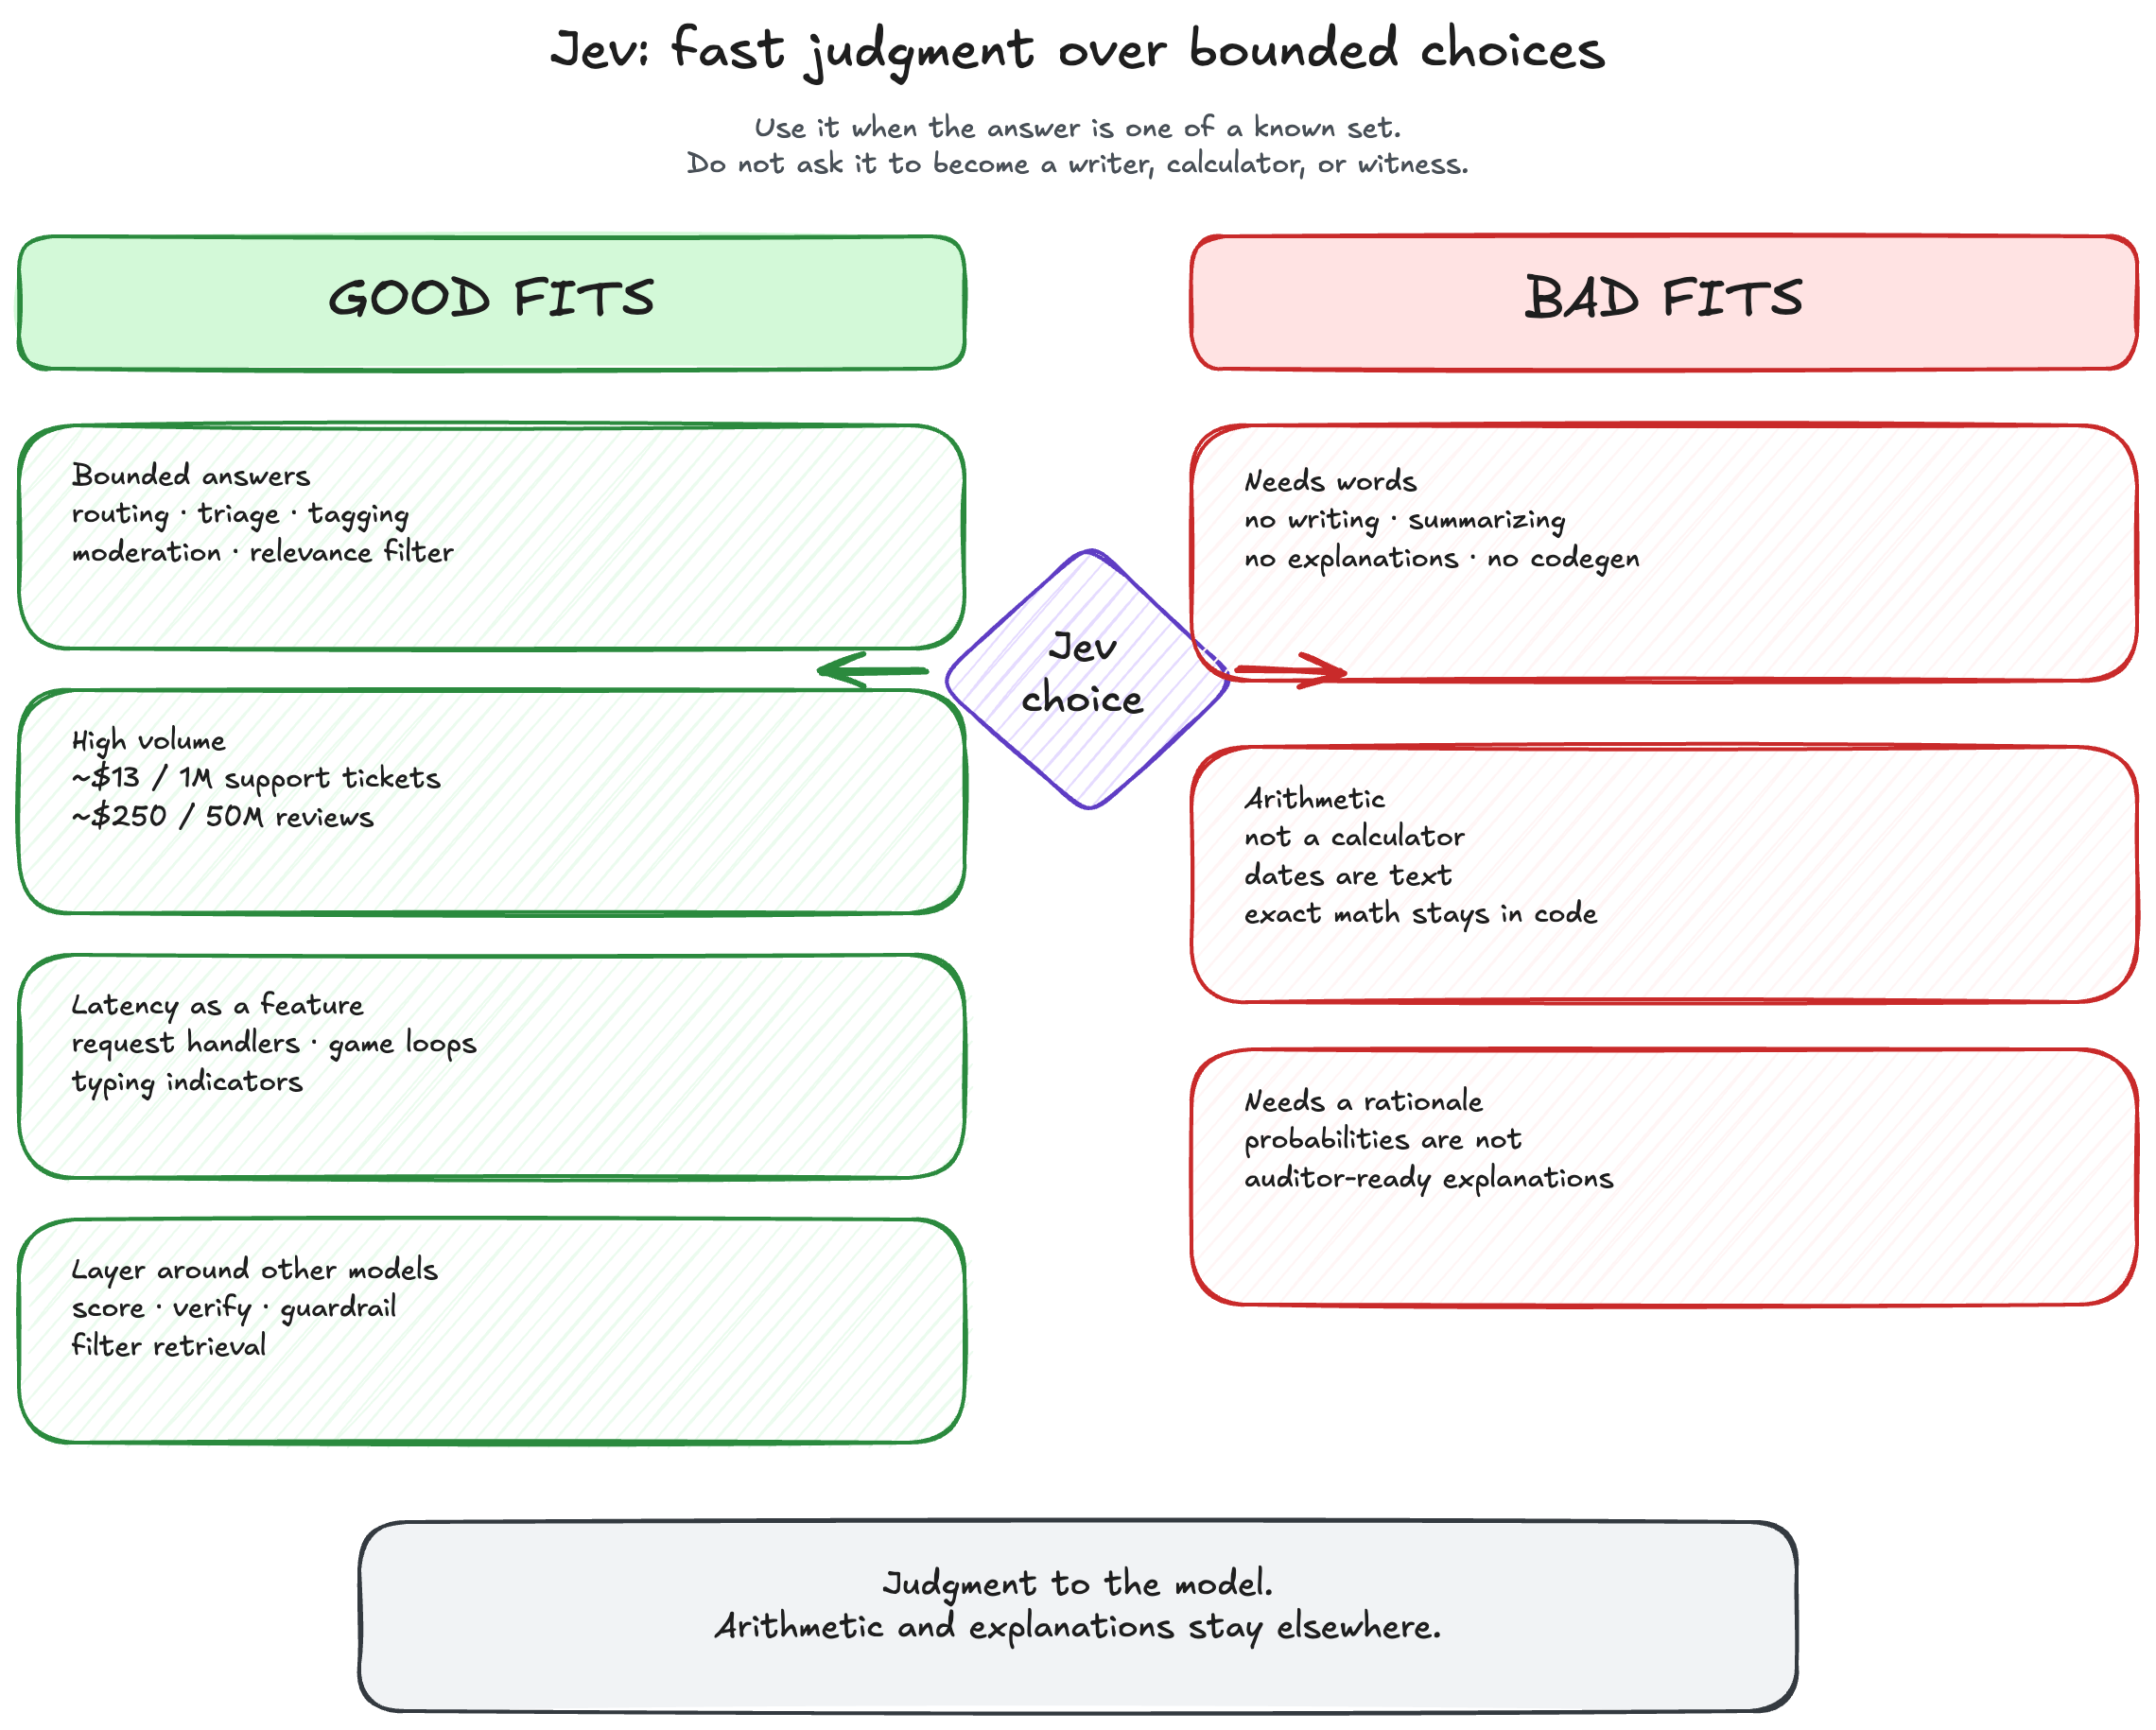
適合: 路由與分流、內容審核、昂貴 context window 之前的相關性過濾、LLM 輸出的評分或保護欄、過去不划算的大量標註、任何 request handler 裡需要亞秒級回應的判斷。
不適合: 生成任何內容、算術或計數或日期運算、需要寫給稽核人員看的判斷理由、一次性的複雜推理、真正開放式的答案空間。
有用的心智轉換是:這不是更便宜的 LLM。這是一個不同的原語:一個碰巧很聰明、會回傳型別、並告訴你自己有多值得信任的 function call。一旦你把它當成這種東西,很多原本只是為了撐住字串輸出而存在的程式碼就不需要存在了。
FAQ
Jev 是什麼? 一個回傳帶型別、機率性決策而不是文字的前沿模型,延遲 70 到 500ms。
多少錢? 輸入每百萬 token $0.042,輸出免費。在 TypeSafe 的 benchmark 上,每個案例約 $0.0004。
它會幻覺嗎? 它不會回傳 schema 之外的值,但可能回傳錯誤、卻合法的值。
它能寫程式或文章嗎? 不能。它根本就沒有被訓練來生成文字。
Choice、Score 和 Noul 是什麼? 三種問題型別:N 選 1(最多 255 個)、2 到 10 級尺度上的位置,以及 yes/no 機率。
我要怎麼取得存取權? 在 typesafe.ai 申請排隊的早鳥存取;金鑰在 console.typesafe.ai 取得。
我應該用它取代我的 LLM 嗎? 不用。級聯使用:Jev 負責便宜地分類與路由,程式碼做它能做的事,前沿模型處理少數困難案例。
原文出處:https://dev.to/valyuai/how-to-use-jev-a-practical-guide-to-typesafes-system-one-model-g5e
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

