
既有 Python 專案如果已經使用 OpenAI SDK,改接第三方相容 API 通常不需要重寫整個呼叫層。先替換 base_url、api_key 與 model,基本對話就有機會直接運作。
問題在於「可以送出請求」不等於「原本依賴的能力全部相容」。模型路由可能限制溫度參數、要求不同的結構化輸出格式,也可能在串流結尾加入空 choices 或額外的用量欄位。
2026 年 11 月 13 日,使用同一套 OpenAI Python SDK 測試 deepseek-v4-flash、gpt-6.1-terra 與 claude-sonnet-5-5。以下整理實際出現的差異,以及比較適合放進專案的處理方式。
遷移前先拆成「連線設定」與「能力設定」
連線設定只有三個核心欄位:
| 設定 | 作用 | 常見錯誤 |
|---|---|---|
base_url |
決定請求送往哪個相容服務 | 路徑多一層或少一層、重複 /v1 |
api_key |
決定身分與可用權限 | Key 與服務不匹配、過期、沒有模型權限 |
model |
決定實際模型路由 | ID 拼錯、版本不同、連字號或大小寫錯誤 |
先用最小請求驗證這三項:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["CRAZYROUTER_API_KEY"],
    base_url="https://api.crazyrouter.com/v1",
)

model = os.environ.get("OPENAI_MODEL", "deepseek-v4-flash")

response = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "只回覆:連線成功"}],
)

print(response.choices[0].message.content)
API Key 從環境變數讀取,不要放進原始碼、版本庫或公開截圖。模型 ID 則應從服務的模型目錄完整複製,不要依照顯示名稱自行改寫。
這個請求若回傳 200 且有正文,只完成「連線層」驗證。專案使用的選用參數與能力,應另外維護成模型設定。
MODEL_PROFILES = {
    "deepseek-v4-flash": {
        "temperature": 0,
        "structured_output": "json_schema",
    },
    "gpt-6.1-terra": {
        "temperature": 1,
        "structured_output": None,  # 本輪未驗證
    },
    "claude-sonnet-5-5": {
        "temperature": 0,
        "structured_output": "json_schema",
    },
}
這張表不是模型的永久規格,而是目前已驗證的路由能力。模型版本或上游適配更新後,應重新測試並更新紀錄。
問題一:公共參數可能讓特定模型直接回傳 400
原測試程式固定傳入 temperature=0。deepseek-v4-flash 與 claude-sonnet-5-5 可以接受,但切換到 gpt-6.1-terra 後回傳 400;測試 0.3 與 0.7 也得到相同結果。
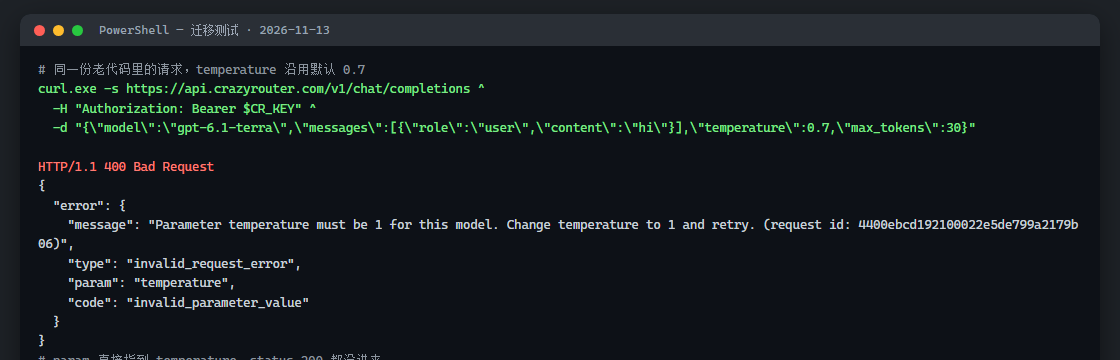
錯誤內容包含:
Parameter temperature must be 1 for this model
param=temperature
code=invalid_parameter_value
目前能確認的範圍是:2026 年 11 月 13 日測試的這條路由只接受 temperature=1。無法只靠這次回應判斷限制位於模型、供應商適配層或聚合服務。
實作上不要把溫度值寫死在共用函式。從 MODEL_PROFILES 讀取每個模型已驗證的參數,沒有必要傳的選用欄位就省略,通常比替所有模型設定同一組預設值穩定。
問題二:json_object 與 json_schema 不是所有路由都能互換
結構化輸出測試要求模型把「張三,30 歲,程式設計師」轉成 JSON,並傳入:
response_format={"type": "json_object"}同一個請求在兩個模型上得到不同結果:
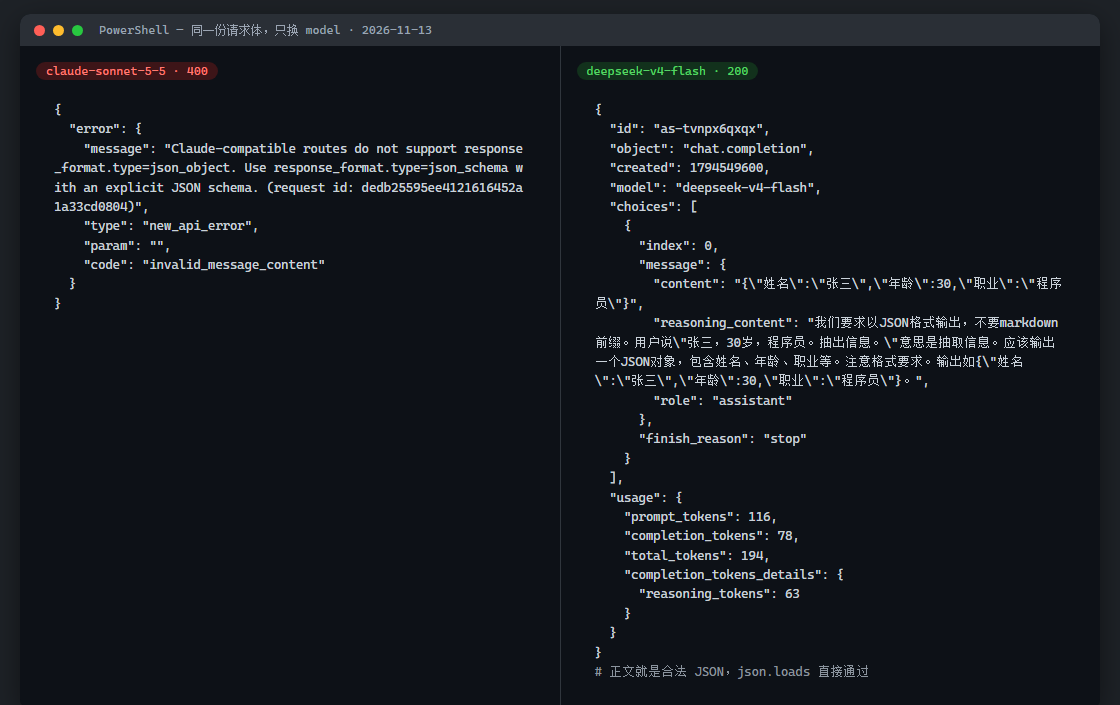
deepseek-v4-flash 回傳 200,內容能被 json.loads 解析;claude-sonnet-5-5 回傳 400,要求改用 json_schema 並提供明確 Schema。
後續測試中,json_schema 在 deepseek-v4-flash 與 claude-sonnet-5-5 都能產生合法 JSON。gpt-6.1-terra 的 json_schema 沒有在本輪測試,因此設定檔中保留為未知,不把推測寫成已支援。
可將 Schema 建立成共用函式,再依模型能力決定是否附加:
def person_schema():
    return {
        "type": "json_schema",
        "json_schema": {
            "name": "person",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "age": {"type": "integer"},
                    "job": {"type": "string"},
                },
                "required": ["name", "age", "job"],
                "additionalProperties": False,
            },
        },
    }
除了確認回傳值能解析,也要測試缺少必填欄位、錯誤型別與多餘欄位是否受到約束。只測一筆正常資料,還不足以驗證正式環境的資料契約。
問題三:工具呼叫失敗可能是上游狀態,不一定是請求參數
函式呼叫測試中,deepseek-v4-flash 與 claude-sonnet-5-5 都正常回傳 tool_calls。gpt-6.1-terra 連續兩次回傳 400,錯誤碼為 provider_temporarily_unavailable。
回應中的 param 指向 reasoning_effort,但實際請求沒有傳這個欄位。若只依 param 修改程式,很可能往錯誤方向排查。
建議保留一份脫敏後的診斷資料:
diagnostic = {
    "http_status": status_code,
    "message": error_message,
    "code": error_code,
    "param": error_param,
    "model": model,
    "requested_at": requested_at,
}
不要記錄 API Key、完整請求標頭或敏感的使用者內容。若錯誤屬於暫時不可用,可以先做有上限的退避重試,之後再切換已驗證的備援模型。
要加入備援模型前,可先閱讀相容 API 端點說明,確認 SDK 需要的路徑層級;再到Crazyrouter 模型目錄核對實際 ID 與帳號權限。目錄列出模型,只代表服務存在該路由,不代表每組 Key 都一定有呼叫權限。
工具如果會寫入資料、傳送訊息或建立訂單,重試只應包住「取得模型回應」的階段。真正執行工具後要使用冪等鍵或其他去重機制,避免請求重送造成重複副作用。
問題四:串流中可能同時出現空正文、思考欄位與空 choices
使用「數到 3」測試 deepseek-v4-flash 與 gpt-6.1-terra,原始分片如下:
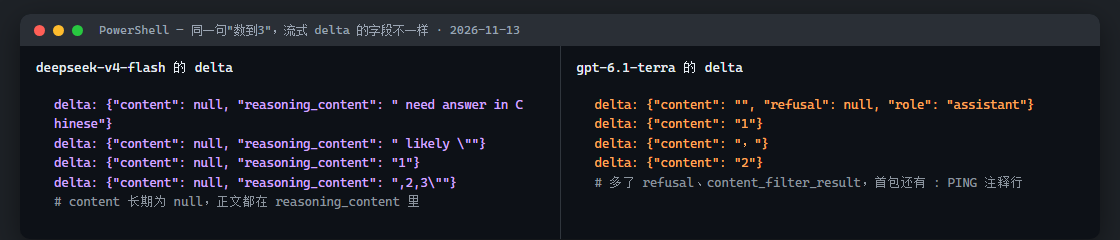
deepseek-v4-flash 產生思考內容時,content 會連續為 null,文字位於 reasoning_content;最後答案仍然從 content 回傳。前端若只顯示 content,思考期間可能看起來像沒有反應。
gpt-6.1-terra 的 delta 還出現 refusal,choice 同層包含內容過濾資訊。使用 stream_options={"include_usage": True} 時,串流結尾會收到 choices=[] 的用量分片,直接存取 chunk.choices[0] 會拋出索引錯誤。
stream = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "數到 3"}],
    stream=True,
    stream_options={"include_usage": True},
)

answer_parts = []
usage = None

for chunk in stream:
    if chunk.usage is not None:
        usage = chunk.usage

    if not chunk.choices:
        continue

    delta = chunk.choices[0].delta

    if delta.content:
        answer_parts.append(delta.content)

    reasoning = getattr(delta, "reasoning_content", None)
    if reasoning:
        # 可更新思考狀態,但不要混入最後答案
        pass

answer = "".join(answer_parts)
若透過 SDK 迭代分片,通常不需要自行解析 SSE。直接讀取 HTTP 串流時,才需要額外處理 : PING、data: [DONE]、空資料行與無法解析的事件。
問題五:usage 的擴充欄位可能是明細或別名
三個模型都回傳 prompt_tokens、completion_tokens 與 total_tokens,但附加欄位不同。部分路由提供輸入輸出明細,部分帶延遲檢查點,另一些同時出現快取讀寫與 input_tokens、output_tokens。
這些數值不能全部加總。擴充欄位可能是標準欄位的明細、別名或計費輔助資料,直接相加會造成重複統計。
專案內可先統一保存三個核心值:
normalized_usage = {
    "input": usage.prompt_tokens,
    "output": usage.completion_tokens,
    "total": usage.total_tokens,
    "raw": usage.model_dump(),  # 僅保存脫敏後且確有需要的資料
}
成本計算則依模型價格、快取規則與平台帳單另建映射。上線前抽幾筆真實請求與帳單逐一核對,比月底才比對整批資料容易定位問題。
上線與回滾檢查表
基本連線成功後,依序跑完以下項目:
- [ ] 一般非串流對話能取得正文;
- [ ] 模型專屬參數不會被路由拒絕;
- [ ] 結構化輸出通過解析與欄位驗證;
- [ ] 串流可處理空
choices、正文與用量分片; - [ ] 工具呼叫的函式名稱、參數、重試與降級正常;
- [ ] 用量欄位已與實際帳單抽樣核對;
- [ ] 備援模型與回滾設定已實際測試。
回滾設定必須同時包含 base_url、api_key 與 model。只恢復位址與金鑰,卻繼續使用另一個服務的模型 ID,仍然可能得到 404 或模型不存在。
OpenAI 相容 API 的價值在於降低呼叫層改寫成本;它沒有承諾所有模型具備相同參數和回應欄位。把連線設定、模型能力與錯誤診斷分開管理,後續新增或替換模型時,才不會把每一次差異都變成臨時例外。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式


