
先把結論放前面。要接一個模型做面向使用者的對話,選 Claude Fable 5.2,它回得快。要做批次任務、預算抓得緊,選 Kimi K3.1 Pro,它便宜、有百萬上下文、批次六折。要談能力,兩家在19題裡只差1題,而且是兩次行為性失誤造成的。
11月12日,同一天、同一個入口、同一台機器,19道題各跑一遍,兩個模型各19次呼叫,程式類允許最多3輪修復。入口只有一個,換模型只改一個字串:
base_url = "https://api.crazyrouter.com/v1"題目分七類:程式碼修復、從零實作、工具編排、倉庫問答、指令遵循、抗誤導、長上下文。每題都有可自動判定的驗收條件,只看最後交付。
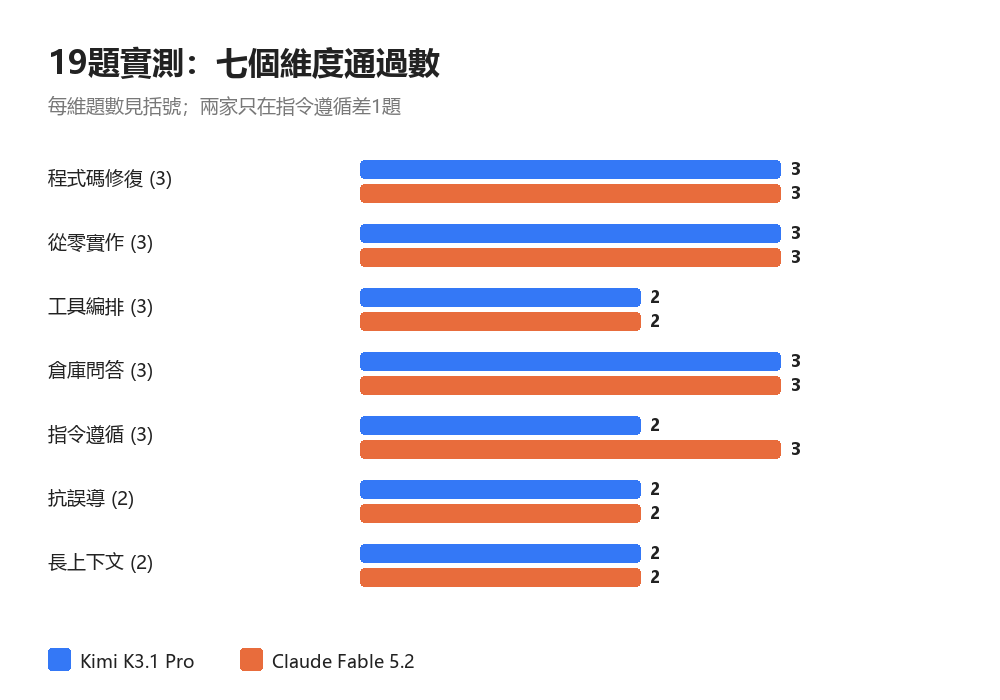
結果是17比18,七個維度裡五個完全打平。那兩處失手算什麼?算偶發,不算能力差,理由後面說。
| 維度 | 題數 | Kimi K3.1 Pro | Claude Fable 5.2 |
|---|---|---|---|
| 程式碼修復 | 3 | 3/3 | 3/3 |
| 從零實作 | 3 | 3/3 | 3/3 |
| 工具編排 | 3 | 2/3 | 2/3 |
| 倉庫問答 | 3 | 3/3 | 3/3 |
| 指令遵循 | 3 | 2/3 | 3/3 |
| 抗誤導 | 2 | 2/2 | 2/2 |
| 長上下文 | 2 | 2/2 | 2/2 |
| 合計 | 19 | 17/19 | 18/19 |
兩處失手,都不是「想不明白」
第一處在工具編排:「統計上個月訂單總金額」。Kimi 選了 search_docs,跑去文件裡搜;Fable 選了 run_sql,但 SQL 查的是 information_schema,不是訂單表。兩家都錯,錯法不同。
第二處在指令遵循的寫作題:140到160字、三個必提賣點、四個禁用詞。Kimi 這次字數超出區間,判不過;Fable 通過。同一題前一輪試跑 Kimi 寫過155字,是過的,所以更像輸出不穩定。
兩處都是「手滑」,不是能力不夠。這種失誤上線後不會報錯,只會變成返工。
影響帳單的是輸出 token 的結構
| 模型 | 19題輸出 token | 其中思考 | 可見正文 |
|---|---|---|---|
| Kimi K3.1 Pro | 10,896 | 9,175 | 1,721 |
| Claude Fable 5.2 | 6,386 | 0 | 6,386 |
Kimi 的輸出裡84% 是思考過程,錢花在「想」;Fable 沒有思考 token,輸出的每個 token 都是能讀到的內容。
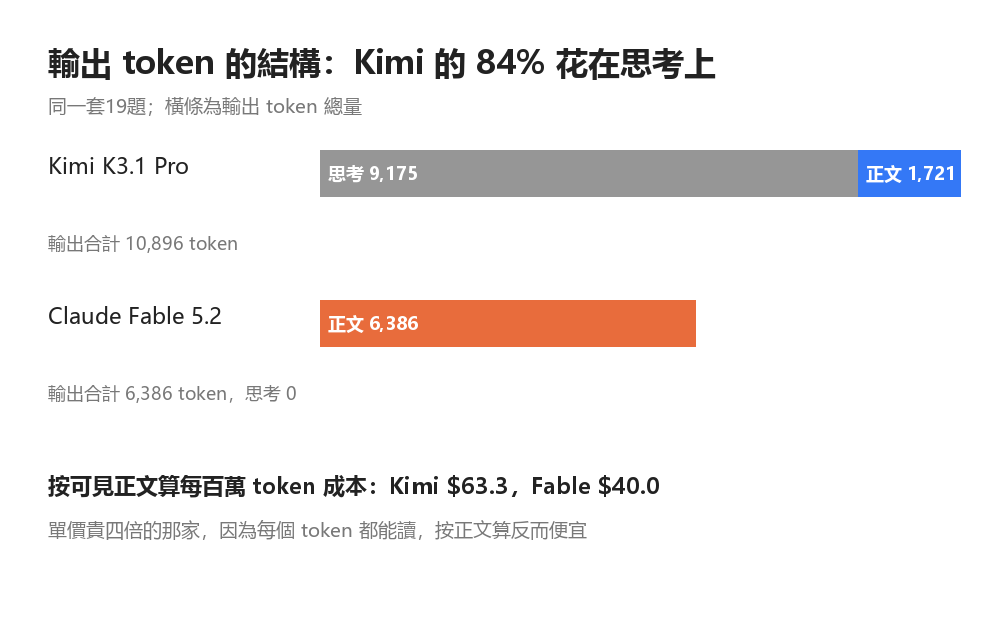
換成「可見正文」來算,結論會反過來:Kimi 每百萬可見正文 token 約 $63.3,Fable 約 $40.0。單價貴四倍的那家,因為每個 token 都能讀,按正文算反而便宜。
長材料這關兩家都過,但沒到上限
兩道材料題:400行日誌裡找埋在第287行的金鑰,800行模組裡找末尾常數。兩家都答對,輸出都只有幾個 token。
但百萬上下文到底能不能用?材料只有1.4萬 token 量級,Kimi 標稱104萬,Fable 官方頁沒標數字。這組資料說明不了「百萬上下文」能不能用,只能說明1.4萬 token 這個量級兩家都不會讀丟。要驗容量,得構造接近上限的輸入,這次沒做。
接進去才會遇到的四個坑
temperature 不是統一參數。 Kimi 傳0.7直接400,錯誤還說「未指明欄位」;gpt-6.1-terra 要求必須等於1;Claude 兩條線連2都收,靜默忽略;Gemini 傳5報429,看起來像限流;DeepSeek 傳5報明確的400。六家五種反應。
200成功、正文為空。 Kimi 把上限設1200,回200,finish_reason 是 length,正文0字,1197個 token 全花在思考。判斷標準要從「有沒有200」換成 finish_reason 和正文長度。
結構化輸出有方言。 Claude 那條線不收 json_object,直接400,要改用 json_schema;其餘幾家 json_object 都能用。
工具呼叫不是標配。 terra 三次都報「服務暫時不可用」,Gemini 必須指定 required,用 auto 時五次裡四次回空正文。
怎麼選,按場景不按跑分
| 手上的活 | 給誰 | 為什麼 |
|---|---|---|
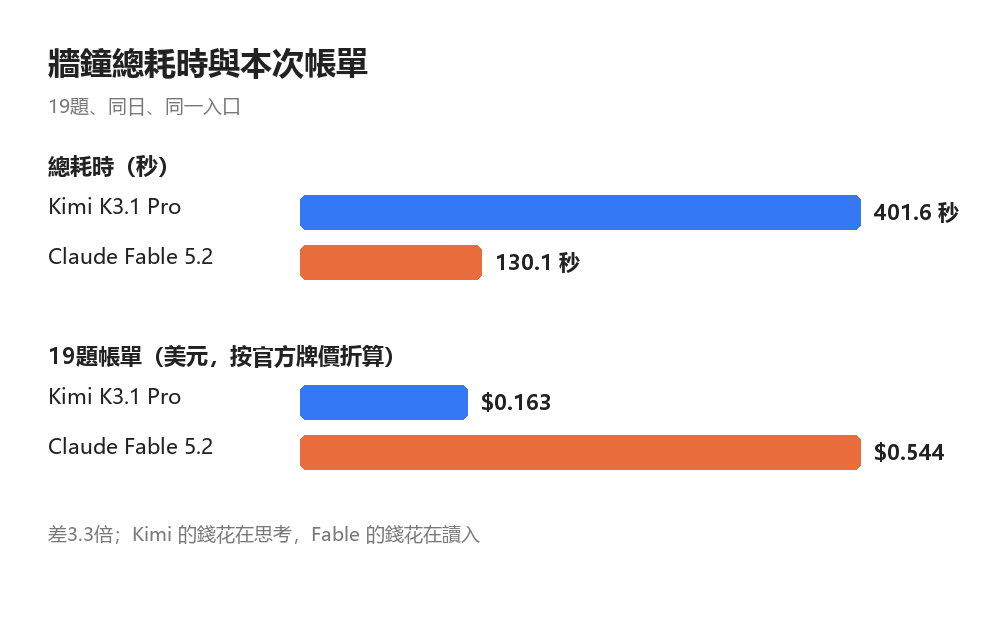
| 面向使用者、要即時回答 | Fable 5.2 | 總耗時130.1秒對401.6秒 |
| 大批次、可非同步 | Kimi K3.1 Pro | 批次檔按標準價60% 計費 |
| 輸出直接餵給程式 | 兩家都行 | JSON 與表格全過,但必須加校驗 |
| 長材料定位 | 兩家都行 | 1.4萬 token 量級都不丟,上限未驗 |
| 工具呼叫 | 兩家都要加校驗 | 同一道 SQL 題兩家都錯 |
查可用型號可以對著模型目錄看,別只信這篇裡的型號清單。
錢差多少
錢到底差在哪?按官方牌價折算這19題:Kimi 輸入27,131、輸出10,896,帳單 $0.163;Fable 輸入36,074、輸出6,386,帳單 $0.544,差3.3倍。
三種典型負載:客服10萬輪約 $460對 $1,840;文件1000份約 $31對 $124;編碼助理2M 輸入/400k 輸出約 $8對 $32。Fable 都貴3倍上下。
牌價會變,核對入口在這裡:模型目錄與價格頁。
限制與重現
19題、兩個模型、同一天,樣本就這麼大。三樣沒測:更長的上下文、多輪工具呼叫、Fable 5.2的官方價(這次用的是官方頁 $8/$40,快取讀 $0.20)。
想自己驗,三步:拿最常問的問題問10次,記中位數和最長那一次;挑一篇真要發的稿讓它按平台規矩寫一遍,數你改了幾個地方;max_tokens 設兩檔,各跑3次,看 finish_reason 裡有幾次 length。
三步不到二十分鐘,你手上的數字比這篇可靠。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

