
2026年11月,騰訊混元、豆包、Codex、Claude、Gemini、DeepSeek這六家,各自該負責哪一段工作?
同一套題我給六家各跑了一遍:三道能驗算的推理題、一篇帶硬約束的促銷文案、一個日常開發的小函數,同一天、同一套參數、同一個入口;另外補了兩輪聯網與時效的探測。結論先給——這類日常任務上,正確率已經拉不開差距,分高下的是快慢、輸出token,以及你怎麼設輸出上限。這篇寫給要接API、按次計費或者批量跑任務的人;只在網頁裡偶爾聊兩句的,看完幫助不大。數據來自2026年11月12日實測,六家的具體型號列在3.1那張表裡。
1. 引言:六家都說自己強,沒人告訴你該怎麼分工
2026年的模型市場不缺選擇,缺的是分工。廣告裡當然都說自己強,可中文圈能查到的橫評,大多還停在“豆包中文好、DeepSeek代碼強”這類印象上,版本號、價格、上下文長度經常是半年前的。
我這次不想再靠印象下判斷。三組題、18次正式調用、同一天跑完,答案能驗算的用腳本驗,代碼能跑的在本地跑,寫文案的約束條件全部可數。跑完發現一個有點掃興的結論:這批模型在「會不會做」上已經很接近,分出差異的是快慢、token用量,以及接入時那幾個參數怎麼設。
下面先按使用場景給六家排位置,再對參數和價格,然後看各家的絕活和短板,最後按角色給組合方案。趕時間的話,直接翻到2.3那張表和最後一節。
2. 四類日常活,六家各自站在哪個位置
日常用模型,其實就四種活:問問題、寫東西、寫代碼、做辦公文檔。前三種我各跑過一輪同題測試,結論都收在2.3那張表裡,各家的具體表現放在第4節。辦公這一類特殊,單獨說。
2.1 做PPT、寫會議紀要:那是客戶端的功能,API只管把內容寫出來
這一類要分兩層看,混在一起就容易買錯東西。
第一層是“一鍵出PPT、出會議紀要”,這是各家客戶端產品的功能,不在API裡。所以這篇不評誰做PPT好看——那是在選辦公軟件,不是在選模型。你在網頁版裡用得爽,不代表接進自己的系統裡也有那些按鈕。
那API能替你做什麼?寫內容、填模板。給個提綱讓它擴寫,給一堆數據讓它生成周報結構,給會議記錄讓它提煉待辦,這些它都能幹。這類活拼的是長文能力、格式穩定性,還有改起來麻不麻煩。
這塊我沒做同題實測,也不給排名。判斷依據只能參照3.1的上下文長度和3.3的計費方式:要處理幾十頁的原始材料再提煉,看上下文夠不夠;要批量生成幾百份報告,按輸出量算成本,長思考型的模型在這裡會喫虧。
2.2 問今天發生了什麼:六家的API都不帶搜索,知識停在一兩年前
問實時信息是另一個高頻需求,我在同一個入口上又跑了兩組。
第一組測時效:讓六家報2026年11月11日美股收盤點位。六家全部回答“無法獲取”,沒有一家編數字,這點比我預期好。再問訓練數據截止到哪天,答案集中在2024年6月到2025年1月——Codex和DeepSeek說2024年6月,騰訊混元和豆包說2024年7月,Gemini說2025年1月,Claude只能給個“2025年前後”。模型版本是2026年的,知識停在一兩年前,這個錯位是所有“實時問答”需求的坑。
第二組測聯網:請求裡帶一個web_search工具聲明,看接口認不認。五家直接報錯——Claude回“只支持function tools”,Gemini報“工具名不能爲空”,DeepSeek、豆包、騰訊混元報參數錯誤。唯一返回200的是Codex,但它沒有真去搜,而是編了一條具體的“今日頭條”新聞,還附了個techcrunch首頁鏈接當出處。
所以結論很直接:這六家在API裡都不帶搜索。有聯網開關的是各家客戶端(網頁版、App裡那個按鈕),不是接口。要實時數據,得自己接搜索工具或外部檢索,把結果塞進請求裡;指望模型自己知道今天發生了什麼,六家都做不到。
2.3 一張表對號:七類活分別交給誰
| 你要做的事 | 首選 | 備選 | 本次依據 |
|---|---|---|---|
| 一次問幾個要驗算的嚴謹問題 | Claude | 騰訊混元 | 三題全對,6.6秒、612個輸出token |
| 對外文案,150字級 | Claude | 豆包 | 150字、三個賣點齊,10.9秒 |
| 中文口語、投流風格 | 豆包 | 騰訊混元 | 約束全達標,風格最像投放素材,單次94.7秒 |
| 寫小函數、腳本、一次性工具 | Codex | Claude | 13條隱藏用例全過,4.8秒 |
| 長文改寫、報告初稿 | Claude | 豆包 | 字數與禁用詞零違規,改動量最小 |
| 批量出稿、要快要多 | Codex | Claude | 同題寫作3秒出稿,六家裡最快 |
| 查今天/昨天的實時信息 | 都不行 | — | 六家API都不帶搜索,知識停在2024—2025年初 |
表裡的依據來自那三組同題測試,哪家栽在哪、錯成什麼樣,第4節有記錄。
3. 硬指標:參數全不公開,能比的只有上下文和速度
參數都藏着,那還能比什麼?能比的只有上下文、架構類型、權重是否開放,還有我實測出來的速度和開銷。這六家沒有一家公開完整參數規模,誰家“多少億參數”這類說法都別當真。
3.1 參數表六行全是“未公開”,只剩上下文和權重能看
| 模型 | 參數規模 | 架構 | 上下文 | 權重 |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 未公開 | 未公開 | 1M | 閉源 |
| GPT-5.3 Codex | 未公開 | 未公開 | 272K | 閉源 |
| Gemini 3.1 Pro | 未公開 | 未公開 | 1M | 閉源 |
| DeepSeek V4 Pro | 未公開 | 未公開 | 1M | 家族一貫開放權重,具體版本以官方發佈爲準 |
| 騰訊混元(hy4) | 未公開 | 未公開 | 未公開 | 閉源 |
| 豆包(doubao-seed-2-1) | 未公開 | 未公開 | 未公開 | 閉源 |
橫向能比的只有上下文和權重,參數規模那一列六個“未公開”擺得整整齊齊。參數比不了,就看實際跑起來什麼樣。
速度上的差別,比那張參數表更能說明問題。
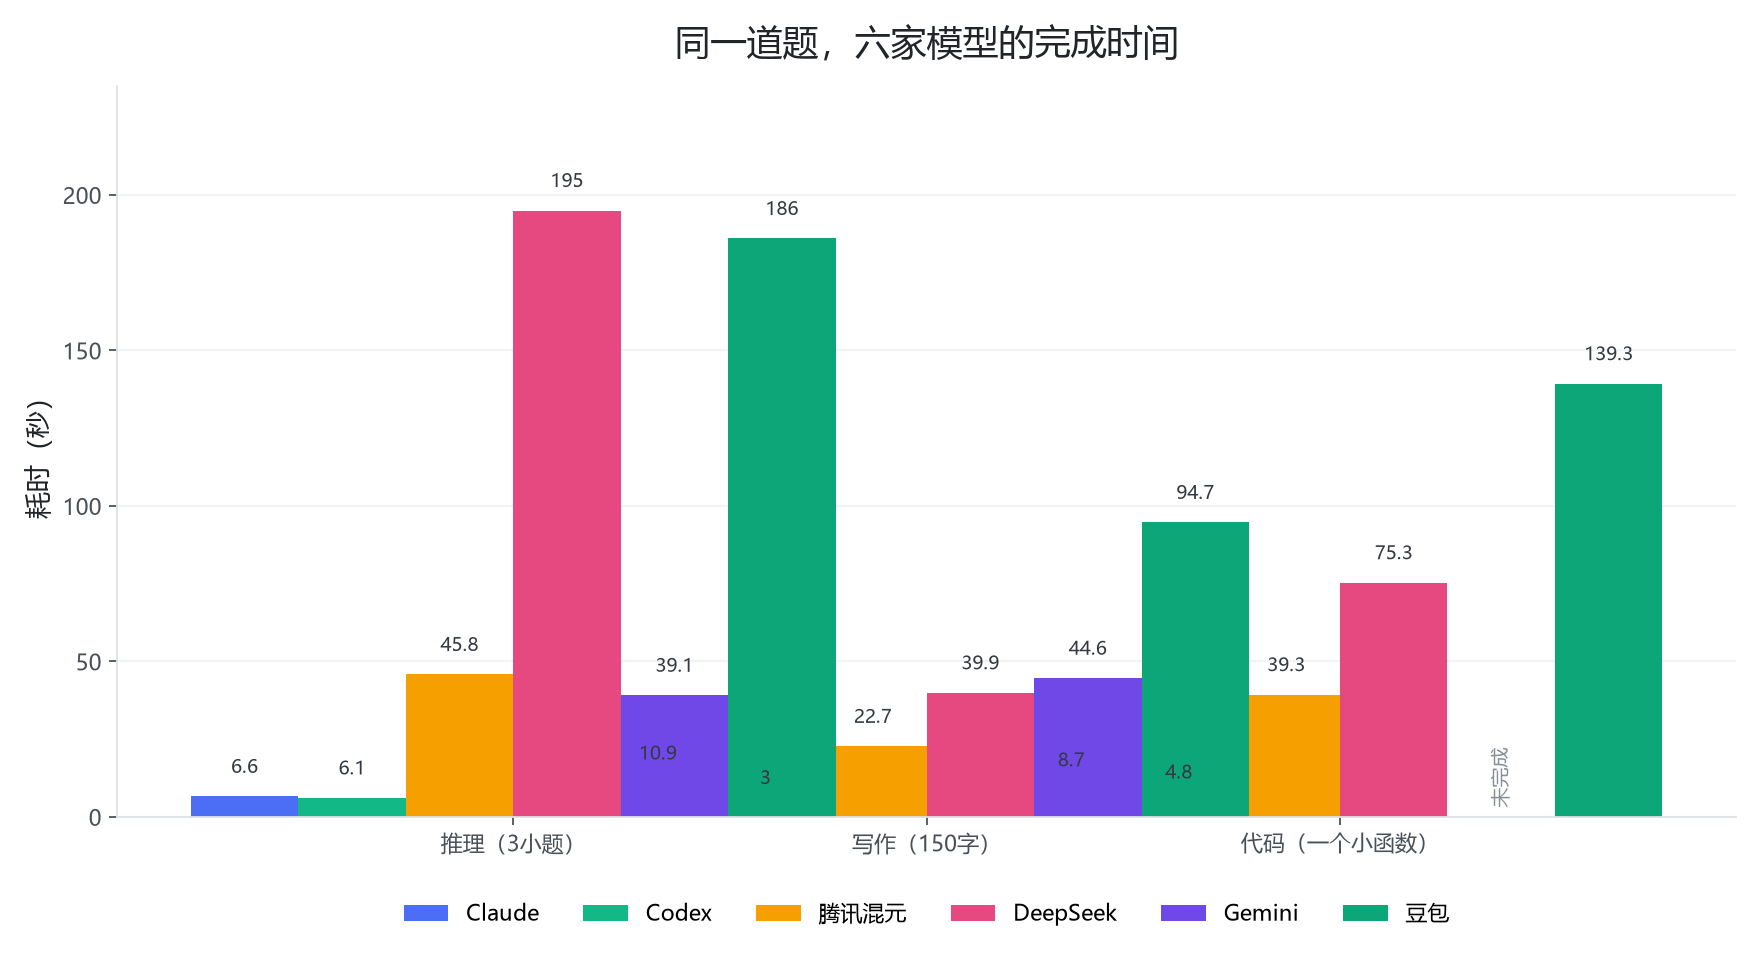
本次實測耗時,單位秒;Gemini的代碼任務因限流未完成。
Codex三組都在5秒內,Claude在7到11秒之間,騰訊混元落在二十到四十五秒這一檔,豆包和DeepSeek在長任務上要兩分鐘以上。這個差別單次用只是“等一會兒”,放到批量任務裡就是排隊長度和機器佔用。
3.2 圖片能看,視頻和語音得另找專門的模型
多模態我沒做同題實測——圖片、語音這類任務很難用一套題公平比較,下面只寫官方給出的能力範圍。
六家在這批API裡能接的主要是文本和圖片輸入。Claude、GPT-5.3 Codex、Gemini、DeepSeek都支持圖片理解;騰訊混元和豆包在同名產品線裡也有視覺版本,但這次實測用的hy4和doubao-seed-2-1-turbo是文本檔。視頻、語音生成不在這些模型的能力範圍裡,得另找專門的模型。
要用圖片,先確認你手上的model ID是不是視覺版。同一個名字下往往有純文本和帶視覺兩種,接錯了不會報錯,只會答非所問。
3.3 單價差三倍多,輸出token能差五十倍
| 模型 | 廠商官方價(每百萬token,輸入/輸出) | 本次實測單次成本 |
|---|---|---|
| Claude Sonnet 5.5 | $2.00/$10.00 | 0.65–1.22美分 |
| GPT-5.3 Codex | $1.75/$14.00 | 0.17–0.79美分 |
| Gemini 3.1 Pro | $2.00/$12.00(20萬token以內檔) | 4.27–4.57美分 |
| DeepSeek V4 Pro | $1.32/$3.96 | 1.64–6.42美分 |
| 騰訊混元(hy4) | 未公開 | 只記token:1933–3690 |
| 豆包(doubao-seed-2-1) | 未公開 | 只記token:5168–11958 |
價格按廠商官方價折算,各渠道的即時報價可以對照AI模型API價格對比那一頁,核對日期2026年11月11日。騰訊混元和豆包我沒找到可引用的官方按token報價,只記token用量,不折算金額。至於免費額度、新用戶贈送這類政策,各平台隨時調整,這篇不列數字,只提醒一句:拿免費額度試出來的結果,和你付費後的限流、併發政策可能不是一回事。
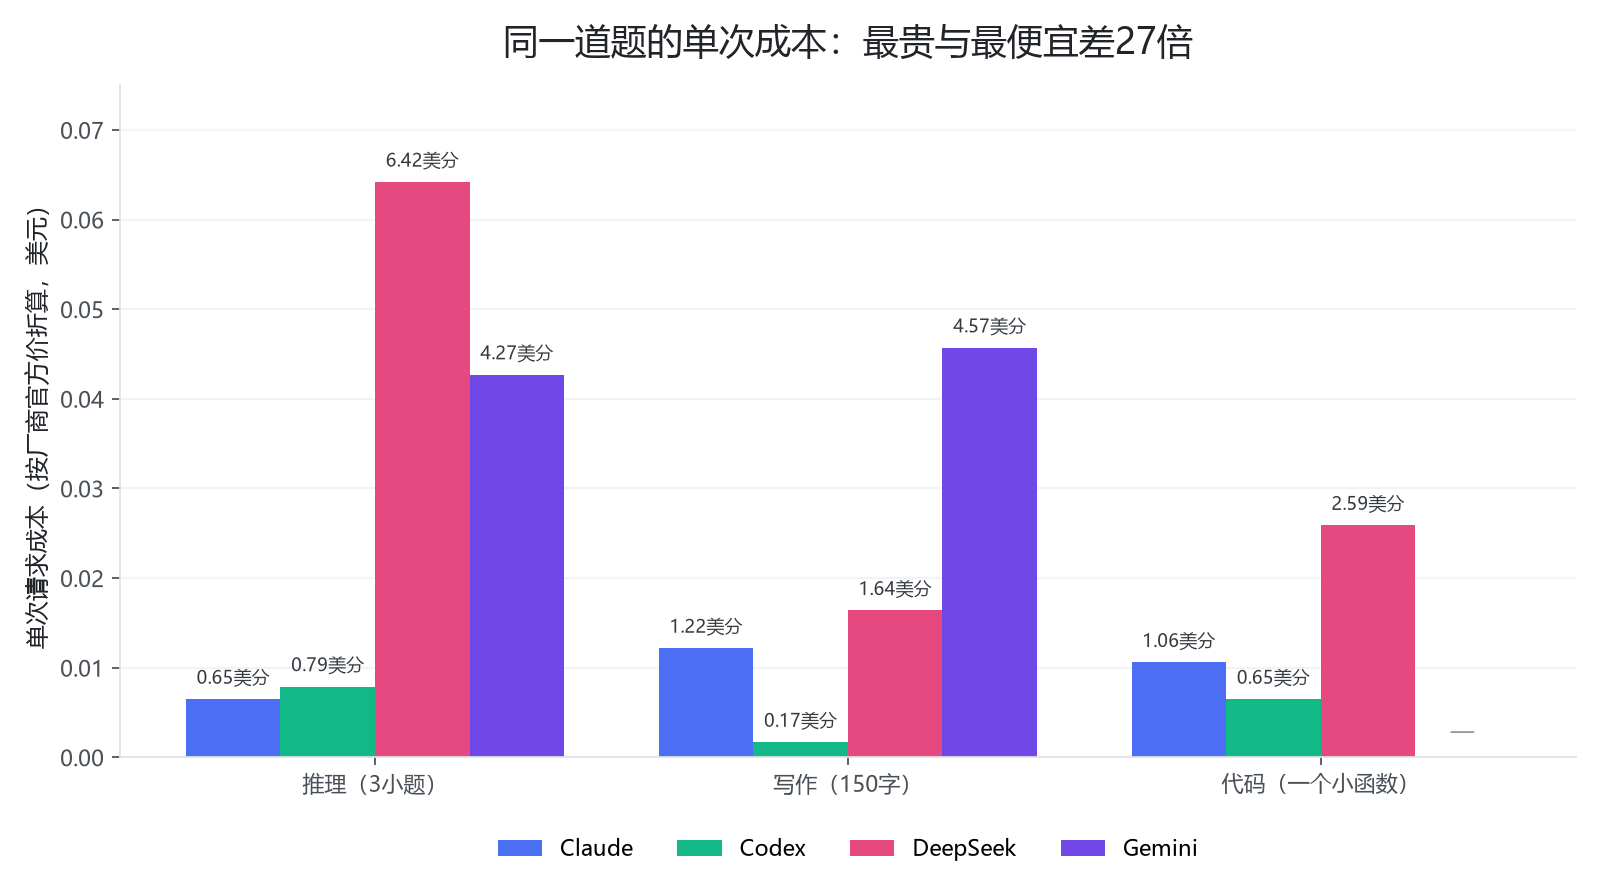
按廠商官方價折算的單次成本,騰訊混元和豆包無公開報價,未列入。
這張表最該看的不是單價,是用量。同樣是150字文案,Codex用了104個輸出token,豆包用了5168個,單價再便宜也架不住五十倍的消耗。
還有兩個坑,接進專案纔會遇到。
先說輸出預算。騰訊混元和DeepSeek在4096上限下,把預算全花在思考過程裡,返回的正文是空的,finish_reason是length;上限提到16384纔拿到完整答案。代碼裡只留兩三千輸出空間的話,接這兩家會得到“調用成功但沒內容”。
再說限流,這事得當成穩定性問題來測。Gemini 3.1 Pro在4096上限下連着429,把上限降下來才通。這類問題在單次測試裡只表現爲“沒結果”,上線後就是“偶發失敗”,得單獨跑一輪併發,才知道自己的量級撐不撐得住。
3.4 生態各佔一塊:要合規走雲、要自部署、要打通辦公
接模型不只是接一個接口,還接它周圍那一圈東西。
Claude常年掛在AWS和Google Cloud的託管服務上,企業採購走雲賬單方便;GPT系列在Azure上有託管版本,配企業權限、走合規流程更順;Gemini和Google Cloud綁得最緊,數據和訓練環境在同一個體系裡。
剩下三家走的是另一條路。DeepSeek的家族模型開放權重,想自己部署、把數據留在內網,它是這六家裡最現實的選擇;豆包在火山引擎上,和字節系的產品、數據打通;騰訊混元在騰訊雲上,和自家會議、文檔這類辦公產品聯動更自然。
所以這六家背後是六塊不同的地盤:要合規走雲、要自部署、要和現有辦公工具打通,方向完全不同。你現在的工作流落在哪家平臺上?那家的模型往往最省事——不是模型更強,是少一次對接。
4. 六家的絕活和短板:誰適合幹什麼,一次說清
六家都有絕活,但絕活不等於適合你。下面寫的是這次測試碰到的、官方明確說明過的,沒碰到的能力我不替它們吹。聯網那條在2.2說過,六家完全一致:都不帶搜索、知識都停在一兩年前,這裡不再重複。
Claude:穩字當頭,寫出來能直接用
- 三組題全對,推理6.6秒、612個輸出token,在這組裡算又快又省。
- 中文表達有分寸感,那句“下班回家,地板已經乾乾淨淨,是什麼感覺”,改都不用改。
- 代碼13/13,8.7秒交付,屬於給了就能用的類型。
- 短板:單價不便宜,輸入長、跑量大時賬單會提醒你。
GPT-5.3 Codex:快,便宜,只幹它理解對的那部分
- 兩組都是六家裡最省的,寫腳本幾乎不心疼。
- 代碼4.8秒、13/13全過,寫日常函數幾乎不用等。
- 寫作3秒出稿,快得像沒想,批量出稿不用排隊。
- 短板:日曆推算少算一天,把星期一答成星期日;寫作只寫117字,把字數下限漏了。它偏執行,對約束的檢查不夠。
Gemini 3.1 Pro:底子好,卡在限流上
- 三道推理題全對,39.1秒,1M上下文適合整庫、整本文檔。
- 輸出token比豆包、DeepSeek省,推理組3531個,寫作組3788個。
- 短板:本次代碼任務在4096輸出上限下連續429,降到2048又被截斷,沒拿到完整結果。穩定性得拿你自己的併發量再驗一次。
DeepSeek V4 Pro:單價最低,單次不一定便宜
- 三道推理題全對,單價是六家裡最低的一檔。
- 寫作147字合規,中規中矩。
- 代碼13/13,邊界沒翻車。
- 短板:輸出長。推理組195秒、16138個輸出token,按量計費時單次成本並不低——長思考任務上,它的便宜單價反而是陷阱。
騰訊混元(hy4):中文順,價格是個盲盒
- 三道推理題全對,45.8秒做完,比豆包和DeepSeek快四倍。
- 中文表達是長板,走“家裡地面總是一天就落灰”這種生活化痛點,讀着不像模板。
- 代碼13/13,39.3秒,邊界處理乾淨。
- 短板:官方價格和上下文長度都沒公開,做預算模型時只能按token量估;它還喫輸出預算,上限給小了直接返回空正文。
豆包(doubao-seed-2-1):最像人說話,也最慢
- 寫作組的語氣最接近真人,投放素材的味道最足,電商詳情頁、小紅書這類場景拿來就能用。
- 三個賣點齊、字數合規,沒用禁用詞,交稿不丟項。
- 代碼也是13/13,穩。
- 短板:慢。推理組186秒、11958個輸出token,寫作94.7秒、5168個token,長任務上體感明顯,成本也跟着上去。
5. 按角色配:開發者、學生、內容運營、跑量的團隊各怎麼搭
開發者、技術寫作者
主力Codex,日常函數、腳本、重構夠用,快而且便宜;需要一段能直接給客戶看的文字,切Claude;整庫代碼要通讀,切DeepSeek或Gemini的長上下文。這套組合裡沒有慢的,一個月幾十萬次調用也不至於卡在排隊上。
學生、研究人員
讀長材料用Gemini或DeepSeek的1M上下文,一次塞進去問,別切成幾十段;要嚴謹推導的題目用Claude,它三題全對,整組只用6.6秒。預算緊的話注意一點:DeepSeek在推理組token花得多,單次成本反而最高,別隻看單價挑。
內容與運營
中文表達和投放素材用豆包,語氣最接近真人,改起來動的地方少;需要卡字數、卡賣點的稿子交給Claude,150字一次到位。批量出稿記得加字數校驗,Codex那種漏要求的稿子會混進來。
預算敏感的批量任務
Codex在寫作和代碼兩組都最便宜,速度也最快,適合先拿它跑量;DeepSeek單價低但輸出長,實際單次成本不一定低。花五分鐘算一遍“輸入token×單價+輸出token×單價”,再決定給誰配額,比看單價表靠譜。
還有一件麻煩事:六個控制檯怎麼省成一個
按上面這樣組合,麻煩的地方不在模型,在賬號:六家就是六個控制檯、六套密鑰、六種計費方式,切一次模型要換一次登錄。這次三組測試我沒有註冊六遍,只用了一個OpenAI兼容入口:
https://api.crazyrouter.com/v1一套密鑰,把請求體裡的model字段換成你想用的那家,就能在這六家之間來回切,消息格式一個字都不用改。上面18次正式調用就是這麼跑完的(另有幾次因爲輸出預算不夠和限流重跑,沒有計入結果)。同題對比也可以用模型競技場自己重跑,跑完再決定給哪家配額。
如果你要把這套組合接進專案,可以按這個入口配置一次,六家的key一起拿到,後面換模型只改一個字段。
6. 四件事已經發生了:能力趨同、成本看用量、聯網仍是外掛、長上下文成標配
把這次的結果放到全年看,有四件事已經發生,不是預測。
能力在趨同。代碼題五家13/13,推理題五家全對,“日常任務上誰更聰明”這個問題正在失去區分度。今年上半年還能靠一道題拉開差距,現在得看幾十次相同任務的失敗率和延遲分佈。
花錢的重心也從單價挪到了用量。六家裡單價最高的Codex,在兩組裡反而最便宜;單價最低的DeepSeek,在推理組最貴。同一個任務輸出token差五十倍,單價表上那點差距全被蓋過去,照單價報價很容易估錯一個量級。
聯網這件事還是個外掛。六家在API裡都不帶搜索,問實時數據要麼說不知道,要麼直接編,實時信息得自己接工具,客戶端上那個“聯網”按鈕接不到接口裡。
長上下文則成了標配。Claude、Gemini、DeepSeek官方都標1M,“分段喂”這種工程習慣可以慢慢丟掉,但新問題也來了:塞得越多輸入token越貴,上下文長了會不會漏掉中間那段,還得自己測。
接下來幾個月該盯的不是誰又發了新版本,而是三件可量化的事:同樣的任務跑二十次失敗幾次、延遲的95分位是多少、一次任務的token分佈有多長尾。這三個數字變了,才值得重新選一次。
7. 一張表收尾:你最看重什麼,就選誰
上面所有判斷,收在這一張表裡:左邊是你最看重的東西,右邊是首選和備選。
| 你最看重什麼 | 首選 | 備選 | 本次依據 |
|---|---|---|---|
| 結論別出錯 | Claude | DeepSeek/Gemini | 三家推理題全對,Claude最快 |
| 一篇稿子直接能用 | Claude | 豆包 | 150字、賣點齊、字數合規 |
| 代碼能跑 | Codex | Claude/騰訊混元 | 13條隱藏用例全過,4.8秒 |
| 又快又省 | Codex | Claude | 三組響應都最快,兩組成本最低 |
| 中文說得像人 | 豆包 | 騰訊混元 | 口語化最自然,代價是慢 |
| 長文檔一次讀完 | Claude/Gemini/DeepSeek | — | 官方標註1M上下文 |
| 數據要留在自己機器上 | DeepSeek | — | 家族開放權重,可自部署 |
| 不要折騰賬號 | 統一入口 | — | 本次18次調用,一套密鑰完成 |
三組測試都是單輪、單日、單入口,樣本很小,不能外推成“某家永遠比另一家強”。真要定,拿你自己的任務跑二十次,看失敗率、延遲和token分佈,比看任何橫評都準。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

