
這篇寫給已經把 Claude Sonnet 5.5 或 Opus 5.5 接上 OpenAI 相容介面、但發現「明明回了 200,結果內容不對」的人。沒用同一批題目測過兩個模型,132 次呼叫全部是 HTTP 200,可是其中有幾種情況,狀態碼完全看不出問題。下面一一說明,並講沒怎麼處理。
情況一:輸出被截斷,但狀態碼仍是 200
這是最容易漏掉的一種。max_tokens 設得太小時,模型還沒寫完就停了,接口依然回傳 200。
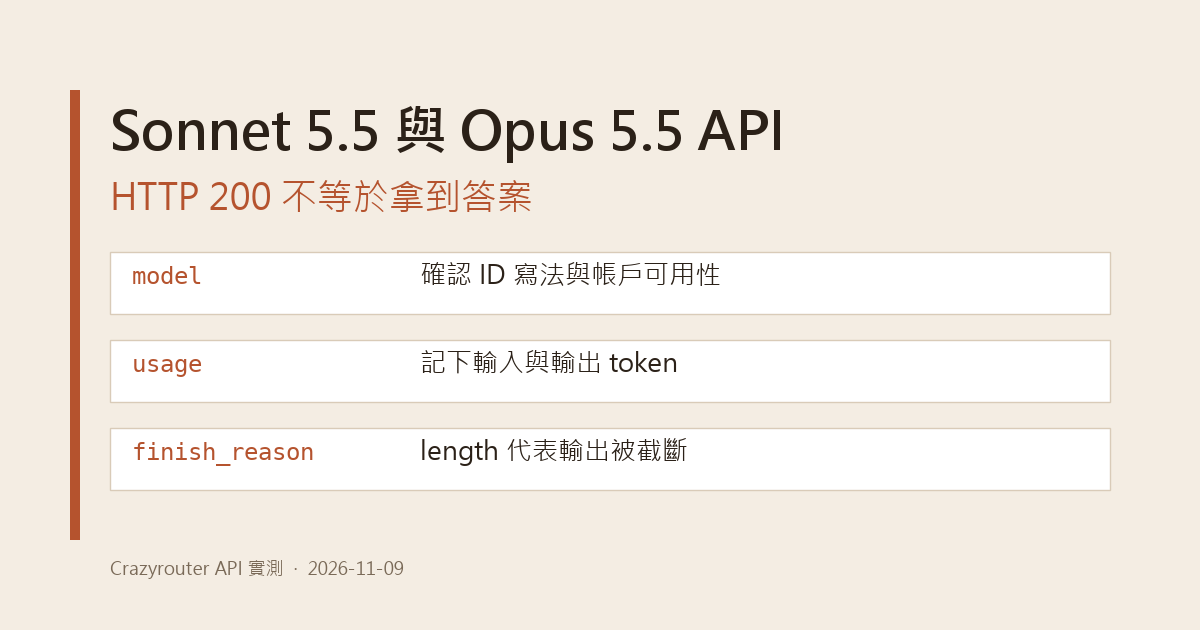
判斷的方法是看 finish_reason。它為 stop 代表正常結束;為 length 代表被上限截斷,回答可能只寫到一半。次次測試中兩個模型在長輸出題上都沒有被截斷,所以這一點主要依據接口文件說明,不是實測到的錯誤。
處理方式:先確認 finish_reason,再決定要不要加大 max_tokens。不要只看 HTTP 狀態碼就認定回答完整。
情況二:工具調用成功,但文字回答不見了
這是沒測試裡真正遇到的情況。題目是這樣的:模型先調用查天氣的工具,拿到結果後,使用者又問「要不要帶傘,順便幫沒訂酒店」。
兩個模型在三輪裡都只發出了訂酒店的工具調用,參數正確,卻沒有回答帶傘的問題。從 HTTP 角度,這一輪完全正常;從使用者角度,他的問題沒有得到回答。
處理方式:在提示裡明確寫上「先用文字回答使用者的問題,再決定要不要調用工具」。沒沒有在次次測試裡驗證過這個寫法的效果,你用的時候要自己確認。另外,程式端可以檢查回應的 content 是否為空,為空時再補一次請求。
情況三:內容有了,但格式不對
這次測試裡,沒讓模型把訂單文字轉成 JSON,以及把日誌轉成 JSON Lines。兩個模型的結果都能被解析,欄位值也正確。
不過在長文件找規則那道題裡,沒看到有一輪 Opus 把「支援 CSV 和 JSON 上傳」這類功能描述也列進約束表。內容次身沒有錯,但如果你直接把它當成結構化結果用,就會多出不需要的條目。
處理方式:只要下游會解析輸出,就一定要做校驗,例如 JSON 解析、必要欄位檢查或正則比對。校驗不過再重試或換模型,比直接相信輸出安全。
沒怎麼判斷一次呼叫是否真的成功
沒的做法分三層,每一層都要看:
- HTTP 狀態碼:確認請求有被接受。
finish_reason:確認輸出是正常結束,不是被截斷。- 內容校驗:文字非空、格式可解析、必要欄位存在;如果有工具調用,要檢查使用者的文字問題是否也被回答。
三層都通過,才算拿到答案。只通過第一層,只能說明請求成功,不能說明你要的內容到手了。測試前,可以先到模型列表確認帳戶可用的模型名稱。
Sonnet 與 Opus 在這個問題上有差別嗎
在上面三種情況裡,沒沒有觀察到兩個模型之間的穩定差異。它們都會出現工具調用漏答文字的問題,格式校驗的需求也一樣。所以這類問題不能靠換模型解決,主要靠提示寫法和程式端的檢查。
兩個模型的速度與輸出長度有差別:第二批題目裡,Sonnet 平均 11.6 秒、約 1,445 個輸出 token;Opus 平均 17.6 秒、約 1,843 個輸出 token。這些是沒在自己的環境裡測到的數字,會受網路與負載影響,只能當參考。
這次測試的限制
沒的測試共 22 道題,每道題跑三輪,樣次不大。次次未系統統計截斷的發生率,也未驗證各種提示寫法的效果。文中部分處理方式是依接口文件與經驗給出的建議,請以自己的實測為準。
所有請求都經過同一個相容介面,結果未必與官方直連完全一致。測試日期是 2026-11-09。
如果只能先改一件事,沒會把 finish_reason 寫進日誌。狀態碼幾乎看不出截斷,但這個欄位能在出問題時第一時間告訴你原因。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

