
如果你手上還留著2025年的DeepSeek教學,直接把程式碼貼進去,第一關很可能就卡住:不是環境沒設好,是模型名稱換過一輪了。這種「明明照著做卻跑不動」的狀況,比模型本身強不強還惱人。
所以這篇分兩半。前半講清楚DeepSeek當初是怎麼紅到國外去的,後半把現在真的能用的兩種接法整理成筆記:廠商直連,或走統一閘道(gateway)。兩邊共用同一份程式碼,只有三個欄位要改。不需要先懂很多,先掌握這三個就夠了,其他維持預設即可。
一、DeepSeek當初紅出圈,靠的不是「便宜」
先講最常被誤解的那個數字。2025年1月20日R1發布,AIME 2024拿到79.8%、MATH-500拿到97.3%,數學、程式、推理的基準測試成績直接對上當時只給API、不開放權重的OpenAI o1。底層V3那次訓練報出約560萬美元,2048張H800跑55天。
但這個560萬只算最後一次訓練的算力租金,不含前期研究、失敗實驗、資料和硬體,後來爭議不小。把它當成「就是因為便宜才紅」,其實把因果講反了。
真正讓人停下來看的是反差:當時幾乎所有人都預設「要做到前沿表現,就得先砸前沿規模的錢」,這個前提被動搖了。再加上幾個湊在一起的條件,事情就從技術新聞變成公共話題了。
- 身份自帶故事性。一家由量化基金孵化、約200人、核心成員多半是本土培養的公司,在晶片出口管制下做成這件事。投資人Marc Andreessen直接稱它是「AI的斯普特尼克時刻」,話題立刻從基準測試轉到美國AI領先性、管制有沒有效、幾千億美元資本支出值不值得。
- 有一個人人都看得懂的場面。2025年1月27日,App登上美區App Store免費榜第一,壓過ChatGPT;同一天輝達跌約17%,單日蒸發近6000億美元,是當時美股史上最大的單日市值損失。
- 速度快到不像新公司。7天1億用戶,ChatGPT到同樣規模用了約兩個月。《華爾街日報》《紐約時報》、CNBC、《時代》雜誌同日上頭條。
三件事擠在同一個月,「業內知名」才變成「圈外也記得住」。
二、DeepSeek的開源權重,才是讓國外工程師買單的關鍵
這一節是我覺得最該單獨拉出來講的,因為它正好回答標題裡的「在國外」三個字。
R1的權重用MIT授權放出,技術論文、訓練方法、6個從1.5B到70B的蒸餾小模型一併公開,可免費商用、可任意修改。伯克利、港科大、Hugging Face等團隊用幾十美元就重現出核心效果。
講得粗略一點:這就像一家餐廳不只把菜端給你看,還把食譜、食材比例和廚房鑰匙一起給你,讓你回家自己炒一盤。跑分是別人說的,重現是自己做的。工程圈本來就不太吃「相信我」這套,能下載、能自己跑、能改,才會真的擴散出去。
所以一家中國公司公布的成績,海外開發者不必先決定要不要信任它——直接驗證就好。驗證不依賴語言、不依賴媒體,也不依賴對發布方的態度。相較之下,國內討論多半圍繞「強不強」,國外先問的是「我憑什麼信」,這正是同一個模型在兩邊被寫成不同故事的原因。
三、DeepSeek到2026年,從新聞變成每天在跑的服務
到了2026年,OpenRouter上中國大模型的token調用量已連續27週超過美國,週調用量前五名裡占四席,DeepSeek居廠商首位;Hugging Face在2026年春季生態報告提到,過去一年該平台41%的模型下載量來自中國研發的模型。外媒的寫法也從「震驚世界」換成融資、IPO、毛利率,以及「續作有沒有打動人」。
對要動手接的人來說,這比當年的頭條實用:它已經不是一則話題,而是一項可以長期依賴的服務。討論它為什麼紅的人變少了,把它接進系統的人變多了。接下來就只剩很具體的事——服務位址填哪個、模型名稱寫哪個。
四、要呼叫DeepSeek,先填對三個欄位
先說個好消息:DeepSeek官方API本身就是OpenAI相容格式,統一閘道也提供OpenAI相容端點。所以SDK(軟體開發套件)用現成的openai套件就好,請求程式碼完全不用改,只換三個值:API_BASE_URL、API_KEY、API_MODEL。
用點餐來記這三格:API_BASE_URL是你要打電話過去的那家店,API_KEY是證明「這單是你點的」會員卡,API_MODEL是菜單上那道菜的編號。編號寫錯,送來就不會是你要的東西。
第一種,廠商直連。
| 項目 | 值 |
|---|---|
| Base URL | https://api.deepseek.com |
| 對話端點 | POST /chat/completions |
| 驗證 | Authorization: Bearer <API_KEY> |
| 金鑰申請 | https://platform.deepseek.com/api_keys |
| 現行模型 | deepseek-flash、deepseek-v4-pro |
| 上下文/最大輸出 | 1M/384K tokens |
export API_KEY="sk-你的金鑰"
export API_BASE_URL="https://api.deepseek.com"
export API_MODEL="deepseek-flash"
$env:API_KEY="sk-你的金鑰"
$env:API_BASE_URL="https://api.deepseek.com"
$env:API_MODEL="deepseek-flash"第二種,走Crazyrouter統一閘道。如果同一個專案還要跑GPT、Claude、Gemini,每家各管一把金鑰、一份用量紀錄和一組重試邏輯,很快就會煩。統一閘道把這些收進同一個相容入口:
| 項目 | 值 |
|---|---|
| Base URL(OpenAI相容) | https://api.crazyrouter.com/v1 |
| 東亞接入位址 | https://cn.crazyrouter.com/v1 |
| 對話端點 | POST /v1/chat/completions |
| 驗證 | Authorization: Bearer <API_KEY> |
| 金鑰申請 | https://crazyrouter.com/console/token |
| DeepSeek模型名稱 | deepseek-v4.1-flash、deepseek-v4-pro |
export API_KEY="sk-你的金鑰"
export API_BASE_URL="https://api.crazyrouter.com/v1"
export API_MODEL="deepseek-v4-pro"
$env:API_KEY="sk-你的金鑰"
$env:API_BASE_URL="https://api.crazyrouter.com/v1"
$env:API_MODEL="deepseek-v4-pro"金鑰記得放環境變數,不要寫死在程式碼裡;上面用的是佔位字串,換成自己的就好。
五、DeepSeek模型ID兩邊不同,舊教學會直接報錯
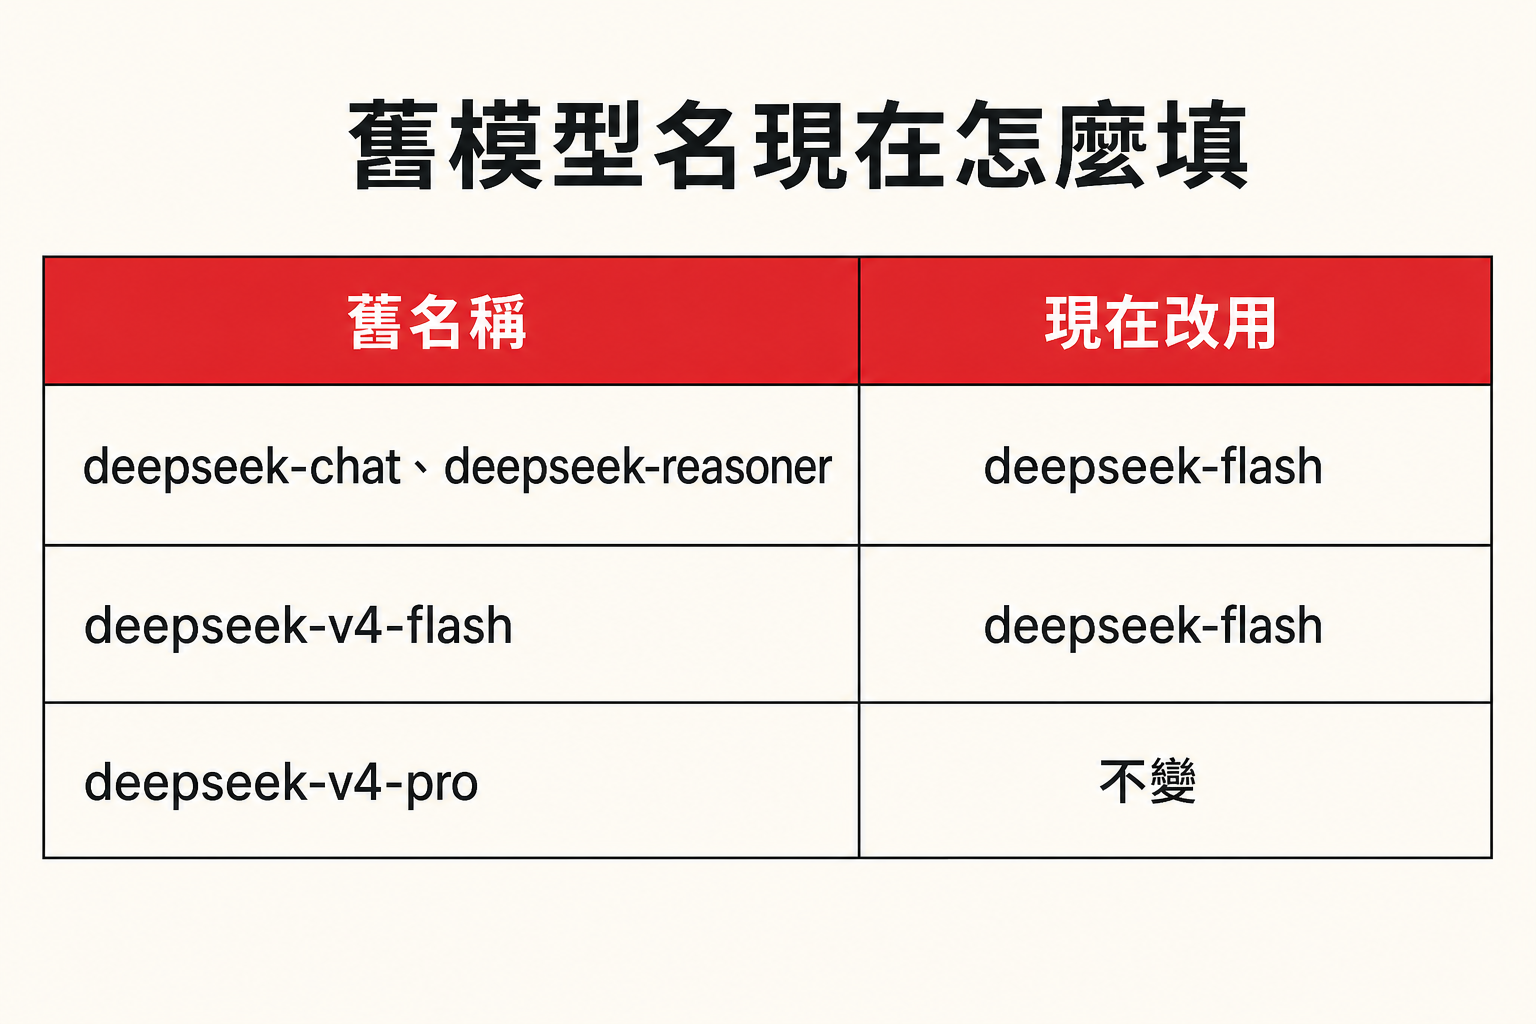
這是最常踩的雷,先幫你擋下來:兩邊的模型名稱不是同一套。廠商直連用deepseek-flash,閘道側要用公開目錄裡的名字,例如deepseek-v4.1-flash或deepseek-v4-pro。網路上還留著大量舊名稱的範例,貼過去第一發就失敗:
| 舊名稱 | 現況 | 改用 |
|---|---|---|
deepseek-chat、deepseek-reasoner |
2026年7月24日起停用,已不在官方模型清單 | deepseek-flash,thinking關/開分別對應舊的chat/reasoner行為 |
deepseek-v4-flash、deepseek-v4-flash-vision-exp |
對應模型已退役,請求暫由V4.1-Flash-1017承接 | deepseek-flash |
deepseek-v4-pro |
現行 | 不用改 |
模型會隨通路和帳號權限變動,接進去之前先問一下自己的金鑰到底能叫哪些:
curl https://api.crazyrouter.com/v1/models \
-H "Authorization: Bearer $API_KEY"這支GET /v1/models的欄位與回傳格式,在列出可用模型的說明裡有完整整理,照著對就好,不用自己猜。
不想敲指令,也可以對照公開模型目錄確認閘道側目前列出的DeepSeek名稱。另外有個位址細節容易手滑:OpenAI相容SDK要帶/v1,Anthropic原生的客戶端則用根網域、不要自己補/v1。
六、一份DeepSeek請求程式碼,兩種設定都能跑
上面任選一組環境變數設好,下面這段都不用動:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("API_BASE_URL"),
)

resp = client.chat.completions.create(
    model=os.getenv("API_MODEL"),
    messages=[{"role": "user", "content": "用一句話解釋什麼是MoE"}],
    extra_body={"thinking": {"type": "disabled"}},
)
print(resp.choices[0].message.content)
print(resp.usage)兩個小地方值得先記起來。thinking在OpenAI的Python SDK裡要放進extra_body,不是最外層的參數;思考模式預設是開的,簡單問答關掉,輸出會精簡很多。最後印出usage則是為了看實際的token組成,別直覺以為「一個詞就是一個token」。
curl版本的thinking放在body最外層:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "用一句話解釋什麼是MoE"}],
    "thinking": {"type": "disabled"},
    "stream": false
}'換到閘道時,位址改成https://api.crazyrouter.com/v1/chat/completions、model改成目錄裡的名字即可。Node也一樣,openai套件留著,只改baseURL。
七、DeepSeek接上線前,先確認這三件事
- 按任務選,不要按版本號選。日常對話、分類、抽取、RAG(檢索增強生成)這類高頻短任務用
deepseek-flash;多步推理、長上下文的程式任務用deepseek-v4-pro。走閘道時對應deepseek-v4.1-flash和deepseek-v4-pro,兩邊別混著寫。 - 把不變的內容放最前面。系統提示、長文件這類每次都重複的段落往前擺,重複請求才容易命中上下文快取,
usage.prompt_cache_hit_tokens看得到命中量。RAG和長對話先做這一步,業務邏輯一行都不用改。 - 看
usage,不要只看回答文字。短問答回得漂亮,不代表長上下文、工具呼叫和串流都正常。接進專案前,拿一段真實輸入跑一輪,確認HTTP狀態、回答非空、回傳結構完整,再往上疊程式。
統一閘道省事的地方也在這裡:把API_MODEL換成目錄裡別的模型名稱,上面那段Python、錯誤處理、串流和紀錄全都不用動,用量和速率限制也集中在一處。已經有一套OpenAI相容程式的專案,接入成本差不多就是改三個環境變數。
反過來說,如果只叫DeepSeek一家,又需要廠商側最細的參數和原始用量明細,直連還是比較直接。判斷標準不是誰比較好,而是你的專案裡到底有幾家模型、要不要集中管理。
回到標題第一問:DeepSeek為什麼在國外這麼紅?不是「便宜」兩個字能交代的。R1的基準測試讓技術圈願意認真看,MIT授權讓海外工程師幾十美元就能自己重現、不必先決定信不信,2025年1月27日登上美區免費榜、輝達單日蒸發近6000億美元讓圈外的人也記住了它;而「在國外」這個限定,還要再加上它正好撞上一場關於算力資本支出的公共辯論,模型發布才升級成公共議題。
第二問就落在開頭那句「把它接進系統的人變多了」:OpenRouter上中國模型token調用量連續27週超過美國、DeepSeek居廠商首位,話題沉澱成了服務。拿第六節那段程式跑一次最小請求,只改API_MODEL試兩個名字,印出resp.usage確認回傳結構;萬一報錯,照「模型ID→base URL→金鑰權限」這個順序查最快。這一步跑通,標題裡的兩個問題在你手上就都有答案了。
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式

