

AI 成本很讓人困惑。各家供應商會丟給你一堆數字,卻沒有真正告訴你長期下來到底要付多少錢。若你不知道做推理任務時會花多少推理 token、多少會被快取,輸入/快取/輸出 token 的價格其實沒有什麼意義。我們將檢視 27 個前沿模型在真實世界中的使用情況。
你甚至沒辦法比較不同模型,因為它們的推理方式不同。有些供應商會對快取儲存收費,有些提供不同的快取策略,有些在尖峰時段套用不同費率,還有些……
而且這還只是文字。圖片和語音就更混亂了。
所以,從回應中收集成本中繼資料是唯一的方法。這篇文章是根據我在 AI Werewolf 文字遊戲中的 51,000 次 AI 呼叫整理而成。純粹是從我的荷包裡統計出來的資料。
文字遊戲中的 AI
我的文字遊戲本質上就是一個由人類玩家和 5~15 個機器人組成的群組聊天。這是一段很長的對話,裡面有一些角色扮演、遵守規則、定期壓縮上下文。我先前寫過它的設計,見 How to make LLMs play conversational games。這套做法可以套用到任何有 AI 的文字遊戲。我支援 27 個來自主要實驗室的 LLM,還有用於頭像和插圖的圖片生成、用於輸入和輸出的語音。我也會在使用者輸入上跑分類器。AI 無所不在,而這些都要花錢。
從 9 月中旬開始,遊戲的每一次 AI 呼叫都會在統計表中寫入一列:輸入 token、輸出 token、快取 token、成本和時間。到目前為止,已經累積 53 天、約 51,000 次呼叫。資料很多,我們一起來看。
我替免費使用者付錢
沒錯,API 呼叫總得有人買單,而這個人就是我。我有付費方案,但唯一的付費使用者是我自己。其他 651 位使用者都在免費方案上。而且我很大方——我讓每個人每天最多可以花我 5 美元。我除了最昂貴的模型之外,幾乎不限制任何東西。主要是因為留存率不高——人來人往。我覺得沒有必要逼大家付費。再說,免費使用者是很棒的測試者,尤其當他們在想辦法作弊、想辦法騙我的時候。
我知道,我知道,這種策略很容易破產。所有做新創的朋友大概都會覺得我的做法相當可疑。不過它某種程度上是有效的——大家可以無廣告地玩,不需要忍受像橫幅特價這種醜陋把戲。我會追蹤所有點擊和呼叫,只要有異常,5 分鐘內 Marlow 就會通知我。所以等情況改變時,我也準備好重新評估。
我每天花多少錢
我每天有 6 位獨立使用者。
平均每天 6.36 美元。 一般日子大概略低於 6 美元。最便宜的一天不到 30 美分,最糟的一天大約 16 美元。最近 30 天因為更多人開始玩,平均上升到約 7 美元。
| 類別 | 53 天 | 每天 | 占比 |
|---|---|---|---|
| 文字(機器人、遊戲主持人、故事) | $212.30 | $4.01 | 63% |
| 圖片(人物肖像、場景插圖) | $94.66 | $1.79 | 28% |
| 音訊(機器人語音、語音轉文字) | $28.29 | $0.53 | 8% |
| 分類器(下一位誰說話、內容審查) | $1.96 | $0.04 | 0.6% |
| 總計 | $337.21 | $6.36 |
一場正式遊戲(50 回合以上)平均花費 $1.49:其中文字 $1.03、圖片 $0.32、語音 $0.13。大約需要 165 次 AI 回合。
一個回合裡有什麼
它是某個機器人執行的一個動作。可能是聊天中的一句回覆、一票投票、或夜晚行動。我會把帶有上下文的請求送到官方 LLM API,然後拿回機器人的回應。我會把兩邊所有 token 的成本都算進去——回應訊息會包含這些資訊。
我用平均每回合成本來比較 27 個模型。我追蹤不同類型的回合:
| 機器人回合 | 回合占比 | 輸入 token | 其中快取 | 輸出 token | 每回合成本 |
|---|---|---|---|---|---|
| 介紹 | 13% | 3,690 | 504(14%) | 299 | 0.30 美分 |
| 白天討論 | 46% | 8,218 | 3,544(43%) | 428 | 0.41 美分 |
| 投票 | 19% | 10,094 | 1,987(20%) | 511 | 0.60 美分 |
| 夜間行動 | 10% | 11,950 | 3,254(27%) | 503 | 0.65 美分 |
| 當日結算摘要 | 11% | 13,545 | 945(7%) | 1,124 | 1.00 美分 |
| 遊戲後閒聊 | 1% | 12,313 | 4,101(33%) | 348 | 0.55 美分 |
摘要是我的壓縮步驟。每一天結束時,每個機器人都會閱讀當天內容並重寫自己的筆記。這是遊戲中最貴的回合:輸入最大、輸出最多,而且幾乎沒有快取。摘要占機器人回合的 11%,卻占機器人支出的 21%。
上下文會隨著遊戲進行而增長。白天討論回合的輸入 token 在第 1 天大約是 6,600,到了第 5 天約為 11,400。摘要則從約 12,100 增加到約 16,800。
有些呼叫不算機器人回合:
| 其他呼叫 | 輸入 token | 其中快取 | 輸出 token | 每次呼叫成本 |
|---|---|---|---|---|
| 新遊戲的故事生成 | 12,218 | 2,389(20%) | 4,309 | 0.85 美分 |
| 遊戲主持人旁白,各種類型 | 2,114 | 13(1%) | 595 | 0.16 美分 |
| 路由器(決定下一位誰說話),Jev | 3,400 | 0 | 0 | 0.014 美分 |
| 路由器備援,GPT-6 Luna | 3,814 | 0 | 0 | 0.038 美分 |
| 內容審查,Jev | 788 | 0 | 0 | 0.003 美分 |
| 內容審查備援,GPT-6 Luna | 1,415 | 0 | 0 | 0.014 美分 |
輸出 token 最棘手,因為它們包含回應文字加上所有推理。它們非常不可預測,因為你完全不知道模型會做多少推理。
LLM 的四個價位帶
文字是最大宗,所以我先從這部分開始。我的遊戲會根據一個機器人回合的成本,把每個文字模型分到四個價位帶之一。這個價位帶決定免費遊戲中可以放多少個該模型的機器人。
| 每回合成本 | 免費遊戲中的機器人數 | 回合占比 | 機器人支出占比 |
|---|---|---|---|
| 最多 0.3 美分 | 無上限 | 56% | 12% |
| 最多 1 美分 | 3 | 21% | 25% |
| 最多 2 美分 | 1 | 16% | 31% |
| 超過 2 美分 | 僅付費 | 7% | 33% |
這些價位帶一開始不是這樣設定的。我以前是根據輸出價格來設限。看起來很合理,但其實是錯的,付費限定那一節你就會看到。9 月 20 日,我改成依照實際測得的每回合成本來設定。接下來 30 天,免費方案的每回合成本從 0.91 美分降到 0.67 美分,最近 30 天又降到 0.50 美分。較便宜的新模型也有幫助,所以不能把全部功勞都算在這次改動上。但我本來就應該一開始就量測。
下面的表格列出最近 30 天內至少有 100 次呼叫的模型,或我特別指出的小樣本模型。
無上限:最多 0.3 美分
| 模型 | 公司 | 每回合成本 | 回覆中位時間 | 最慢 10% |
|---|---|---|---|---|
| GPT-6 Luna | OpenAI | 0.09 美分 | 4.8 秒 | 11.6 秒以上 |
| DeepSeek V4.1 Flash | DeepSeek | 0.09 美分 | 2.6 秒 | 7.2 秒以上 |
| Qwen 3.8 Flash | 阿里巴巴 | 0.10 美分 | 11.6 秒 | 22.9 秒以上 |
| MiniMax M3.1 Flash | MiniMax | 0.10 美分 | 3.9 秒 | 10.6 秒以上 |
| GLM-5.3 Flash | 智譜 | 0.13 美分 | 5.6 秒 | 16.7 秒以上 |
| Mistral 4 Small | Mistral | 0.17 美分 | 5.2 秒 | 10.1 秒以上 |
| Claude Haiku 5.5 | Anthropic | 0.19 美分 | 4.8 秒 | 9.1 秒以上 |
| Gemini 3.5 Flash Lite | 0.21 美分 | 1.0 秒 | 1.6 秒以上 |
對,大家家的小型前沿模型都在這裡。我沒有把推理額度和輸出預算放進表格,這樣可以省空間,也比較不會精神崩潰。不過我花了很多時間平衡這些設定,才換來不錯的速度和表現。
Luna 跟 DeepSeek Flash 一樣便宜。GLM 和 Qwen Flash 很慢。
最多 3 個機器人:最多 1 美分
| 模型 | 公司 | 每回合成本 | 回覆中位時間 | 最慢 10% |
|---|---|---|---|---|
| DeepSeek V4 Pro | DeepSeek | 0.55 美分 | 10.3 秒 | 30.0 秒以上 |
| GPT-6.1 Terra | OpenAI | 0.74 美分 | 3.1 秒 | 6.1 秒以上 |
| GLM-5.3 | 智譜 | 0.93 美分 | 5.0 秒 | 15.6 秒以上 |
| Gemini 3.8 Flash | 0.93 美分 | 10.0 秒 | 16.6 秒以上 |
Gemini 3.8 Flash 讓我很意外,而且是壞的那種。跟 Flash Lite 相比,成本跳很大。它每回合的成本是 Flash Lite 的 4.4 倍,回覆時間則是 10 倍。它的每 token 收費更高,而且每回合會輸出約 800 個 token,而 Flash Lite 大概只有 80 個。其中大多數 800 個都是推理內容。
DeepSeek Pro 很慢:中位回覆要 10.3 秒。完整版 GLM 比 Gemini 3.8 Flash 快三倍。
GPT-6.1 Terra 不錯。相較於 GPT-5.6,它便宜了很多,而且速度非常快。OpenAI 做得好。
1 個機器人:最多 2 美分
| 模型 | 公司 | 每回合成本 | 回覆中位時間 | 最慢 10% |
|---|---|---|---|---|
| Qwen 3.8 Max | 阿里巴巴 | 1.02 美分 | 10.5 秒 | 25.7 秒以上 |
| Mistral Large 4 | Mistral | 1.30 美分 | 17.2 秒 | 27.3 秒以上 |
| Muse Spark 1.3 | Meta | 1.31 美分 | 10.1 秒 | 23.6 秒以上 |
| Kimi K3.1 Pro | 月之暗面 | 1.47 美分 | 13.3 秒 | 34.1 秒以上 |
| Gemini 4 Argon | 1.63 美分 | 10.8 秒 | 28.3 秒以上 |
所有表現差的都在這裡。又貴又慢。Kimi K3.1 有一個更快的版本,但價格是兩倍。Mistral Large 4 和 Muse 在摘要上很常 1 分鐘逾時。
我保留這些模型是為了多樣性。它們對我的遊戲來說不太實用。有時我會把較貴的模型移到這個價位帶,讓使用者試試看,也順便收集一些資料。
僅付費:超過 2 美分
| 模型 | 公司 | 每回合成本 | 與 Luna 相比 | 呼叫次數 |
|---|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 約 10.6 美分 | 128 倍 | 27 |
| Grok 4.7 | xAI | 4.89 美分 | 59 倍 | 29 |
| GPT-6 Astra | OpenAI | 4.38 美分 | 53 倍 | 25 |
| Claude Sonnet 5.5 | Anthropic | 3.13 美分 | 38 倍 | 955 |
| Gemini 3.1 Pro | 2.94 美分 | 35 倍 | 458 | |
| Claude Opus 5.5 | Anthropic | 資料不足 | - | - |
| GPT-6.1 Sol | OpenAI | 資料不足 | - | - |
| Muse Wonder 1.0 | Meta | 資料不足 | - | - |
| Sakana Fugu Max | Sakana | 資料不足 | - | - |
Fable 比 Luna 貴超過 100 倍。這一節的數字不多——這裡大多數模型除了我以外,幾乎沒有人玩過。
Grok 和 Gemini Pro。 在我改規則之前的 30 天裡,Grok 4.6 一場遊戲被允許 3 個機器人,因為它的輸出價格只有 6 美元。它每回合成本 3.55 美分,是 app 裡最貴的模型。Gemini 3.1 Pro 以 2.80 美分排名第二。兩者合計約占 12% 的回合與 39% 的機器人支出:在 $111.52 之中占了 $43.75。與此同時,GLM-5.3 的輸出價格較低,只有 4.40 美元,卻只允許 1 個機器人,每回合成本僅 0.76 美分。
這就是我根據供應商 token 價格做出的糟糕平衡。還好有這些統計資料,讓我可以調整價位帶。最糟的是,玩家其實根本不怎麼在意模型——是我程式裡的隨機選擇把那些模型放進遊戲,因為它們被認為負擔得起。
Mistral Medium 3.5。 我後來又犯了同樣的錯。新系統讓它在每場遊戲中佔一個位置。它的推理 token 在某些回合飆到 15,000~24,000 個。每回合成本 3.5 美分,而且大約 6% 的呼叫會失敗。我在三週後把它移除了。它花了我 $12.32。
Sonnet 和 Haiku。 10 月 13 日,我讓 Sonnet 5.5 在免費遊戲中佔一個位置,好收集樣本。在同一段時間內:
| 輸入 token | 輸出 token | 回覆中位時間 | 每回合成本 | |
|---|---|---|---|---|
| Claude Haiku 5.5 | 13,255 | 784 | 4.8 秒 | 0.18 美分 |
| Claude Sonnet 5.5 | 12,231 | 460 | 4.2 秒 | 3.10 美分 |
Sonnet 每回合成本是 Haiku 的 17 倍,而且並沒有更快。它最後一週在我的統計裡,Claude 的 $12.22 支出中有 $11.35 都是它花掉的,幾乎全來自免費遊戲,而且都是因為每場只給了一個位置。
token 標價 vs. 實際價格
這是實際價格和我根據輸入/輸出費率預估的價格之間差了多少。預估價格我用的是 8,000 個輸入 token、300 個輸出 token,按照費率卡計算,且不含快取。然後再用實際平均每回合成本去除。
| 模型 | 實際成本 / 預期成本 |
|---|---|
| Grok 4.7 | 2.7 倍 |
| Mistral Medium 3.5 | 2.5 倍 |
| Mistral Large 4 | 2.1 倍 |
| Gemini 3.1 Pro | 1.5 倍 |
| Gemini 3.8 Flash | 1.3 倍 |
| GPT-6.1 Terra | 0.8 倍 |
| Kimi K3.1 Pro | 0.8 倍 |
| GLM-5.3 | 0.7 倍 |
| Qwen 3.8 Max | 0.6 倍 |
低於 1 倍的模型,是因為快取的關係。如果沒有快取,在相同 token 數下,Terra、GLM 和 Kimi 大約會是 1.0 倍,而 Qwen Max 會是 1.2 倍。Qwen Max 有 63% 的輸入來自快取,比這裡其他任何模型都多,所以它從高於標線變成表中最便宜的比例。排在上面的模型每回合會輸出遠超過 300 個 token,而快取折扣完全補不上這部分。
看不見的變數是推理。Grok 4.6/4.7 每回合大約會輸出 2,200 個 token,其中 94% 是推理內容。玩家實際只會看到其中約 100 個。不是每家供應商都會回報這個拆分,所以我沒辦法對所有模型都這樣分析。
另一個看不見的東西是 tokenizer。不同模型對同一段文字會產生不同數量的輸入 token。Claude Haiku 5.5 平均每回合 13,473 個輸入 token;GPT-6 Luna 在同類型遊戲中平均只有 7,377 個。
便宜中國模型的迷思
常見說法是,中國模型比美國模型便宜很多。從我的資料平均來看,這好像是真的:中國模型的一個回合平均 0.40 美分,其他所有模型則是 0.76 美分。
但把每個價位帶裡的模型拿來比,差距就消失了。各個價位帶大致平衡,兩邊都沒有勝出。我很驚訝地看到,Luna 可以跟 DeepSeek Flash 正面對決。
唯一的例外是 DeepSeek V4 Pro。它每回合 0.55 美分,是 3 機器人價位帶中最便宜的模型,低於 GPT-6.1 Terra(0.74 美分)以及 Gemini 3.8 Flash 和 GLM-5.3(各 0.93 美分)。
中國模型也比較慢。我在 8 月寫過這件事,見 How I tried to write an article about slow Chinese LLMs。DeepSeek Flash V4.1 是例外。它的回覆中位時間是 2.6 秒,是遊戲裡最快的模型之一。
快取超級麻煩
輸入是我文字費用中最大的一部分:大約占 73%,輸出則占 27%。而且提示詞也會隨著遊戲進行而增長,從第 1 天約 6,900 個 token 增加到第 8 天約 15,500 個。這些提示詞幾乎每一回合都一樣。供應商會把快取輸入打 75~98 折。照理說,快取應該能解決一切。
但實際上,只有 29% 的輸入 token 是從快取提供的。
第一個原因是遊戲節奏。寫程式的代理每隔幾秒就會呼叫一次模型。我的機器人則要等人類輸入,也要等其他機器人說話。同一個機器人兩次呼叫之間的中位時間是 4 分鐘。42% 的間隔超過 5 分鐘,6% 超過 30 分鐘。
以下是依照機器人沉默時間長短,統計輸入 token 被快取提供的比例。
| 機器人兩次呼叫的間隔 | <1 分鐘 | 1–5 分鐘 | 5–15 分鐘 | 15–60 分鐘 | 60 分鐘以上 |
|---|---|---|---|---|---|
| 所有回合占比 | 11% | 47% | 29% | 9% | 4% |
| DeepSeek | 68% | 56% | 48% | 49% | 45% |
| Claude(1 小時快取) | 51% | 45% | 42% | 41% | 7% |
| Qwen | 87% | 70% | 36% | 21% | 3% |
| OpenAI | 31% | 23% | 19% | 13% | 0% |
| GLM | 38% | 27% | 16% | 2% | 0% |
| Mistral | 42% | 21% | 6% | 2% | 0% |
| Gemini | 36% | 16% | 2% | 1% | 0% |
這張表說明幾件事:
- DeepSeek 不在乎我的節奏。 重複呼叫的命中率是 100%,即使隔了一小時也一樣。它的快取可以維持好幾小時甚至好幾天。這是唯一為這種遊戲設計的模型。
- Gemini 幾乎等於關掉了。 超過 5 分鐘就沒了。Gemini 3.8 Flash 是我花最多錢的模型之一,但只有 10% 的輸入有被快取。
- Qwen 在你很快時最划算。 Qwen Max 有 63% 的輸入來自快取,這幫它省下了將近一半帳單。
- 慢不慢不是全部。 OpenAI 的快取理論上可以維持 30 分鐘,但即使間隔不到 1 分鐘,也只提供了 31% 的 token。我不知道為什麼。也許只是機器人的呼叫落到不同伺服器上了。
第二個原因讓我很意外,因為我原本把一切都怪到節奏上。以下是依照回合類型統計的相同快取占比:
| 機器人兩次呼叫的間隔 | <1 分鐘 | 1–5 分鐘 | 5–60 分鐘 |
|---|---|---|---|
| 白天討論 | 55% | 51% | 33% |
| 夜間行動 | 52% | 16% | 13% |
| 投票 | 25% | 23% | 15% |
| 當日結算摘要 | 26% | 7% | 6% |
即使間隔很短,投票和摘要幾乎也不會命中。一次白天討論接著另一個白天討論,在 5 分鐘內可達 60% 命中率。一個討論回合之後接著投票,只有 23%。在 OpenAI 和 Gemini 上,5 分鐘內的投票和摘要命中率只有 0~2%。
在我上一篇文章 How to make LLMs play conversational games 之後,我重做了快取邏輯。我停止對 OpenAI 重複送出系統提示詞,把 Claude 改成 1 小時快取,並且讓每個提示詞中重複的部分逐字節完全一致。我以為自己做得很好。結果沒有。
投票問題出在結構化輸出。討論回合要求純文字。投票和夜間行動要求固定格式的 JSON,而每種夜間角色也都有自己的格式。歷史內容是相同的,所以快取理應還是能用。顯然不是,至少不是每家供應商都行。以下是同一個機器人在討論回合之後 5 分鐘內進行投票時的快取占比:
- OpenAI、Google、Mistral、Meta:0~3%。 這四家都把 JSON schema 當成獨立的請求設定,切換時就把快取丟掉了。
- Anthropic:25%。 Anthropic 的文件是這樣寫的:在結構化輸出下,「Claude 會自動收到額外的系統提示詞來說明預期的輸出格式」,而且「變更
output_config.format參數會使該對話執行緒的任何提示詞快取失效」。剩下的 25% 是系統提示詞最上方的遊戲規則。 - DeepSeek、GLM、MiniMax、Qwen、Kimi:41~76%。 DeepSeek、GLM 和 MiniMax 是把 schema 當作提示詞末尾的一段文字,所以開頭的提示詞不會變。Qwen 和 Kimi 則像 OpenAI 一樣使用獨立的 schema 設定,但仍然保留了快取。
中國模型在 JSON 回合上保留快取的能力要好很多。
摘要問題則是我自己的錯。提示詞裡會注入一些資料,這把快取直接炸掉了。我需要修正這件事,只是直到我抓這篇文章的資料時才發現。
快取真的很麻煩。
有快取反而可能比沒有更貴
Anthropic 的預設快取只維持 5 分鐘,而機器人兩次呼叫之間的中位間隔大約是 4 分鐘。所以我在 9 月把所有 Claude 呼叫都改成 1 小時快取。它比較貴。寫入快取的費用是正常輸入價格的兩倍;讀取快取則只有十分之一。
而我得到的是這樣:
| Sonnet 5.5 | 每回合成本 |
|---|---|
| 完全不使用快取 | 2.94 美分 |
| 使用 1 小時快取 | 3.13 美分 |
這怎麼可能?
較長的快取只有在你寫入的大部分內容都會被讀回來時才划算。我的不是。53 天內,Anthropic 的使用報表顯示,Sonnet 的輸入有 48% 是以兩倍價格寫入快取,而只有 42% 被讀回。每次切換到 JSON 回合,快取就會被清掉,機器人又得把全部內容重寫一次。
我自己的統計沒顯示這件事,因為我的程式把快取寫入按正常價格計算。直到 Anthropic 的餘額消耗速度大約是我統計所顯示的 1.5 倍時,我才發現。
圖片:帳單的 28%
圖片是最近才加入的功能。我一開始很猶豫要不要加,因為額外成本不低。但它大幅改善了 UI/UX,所以我決定盡量保留。
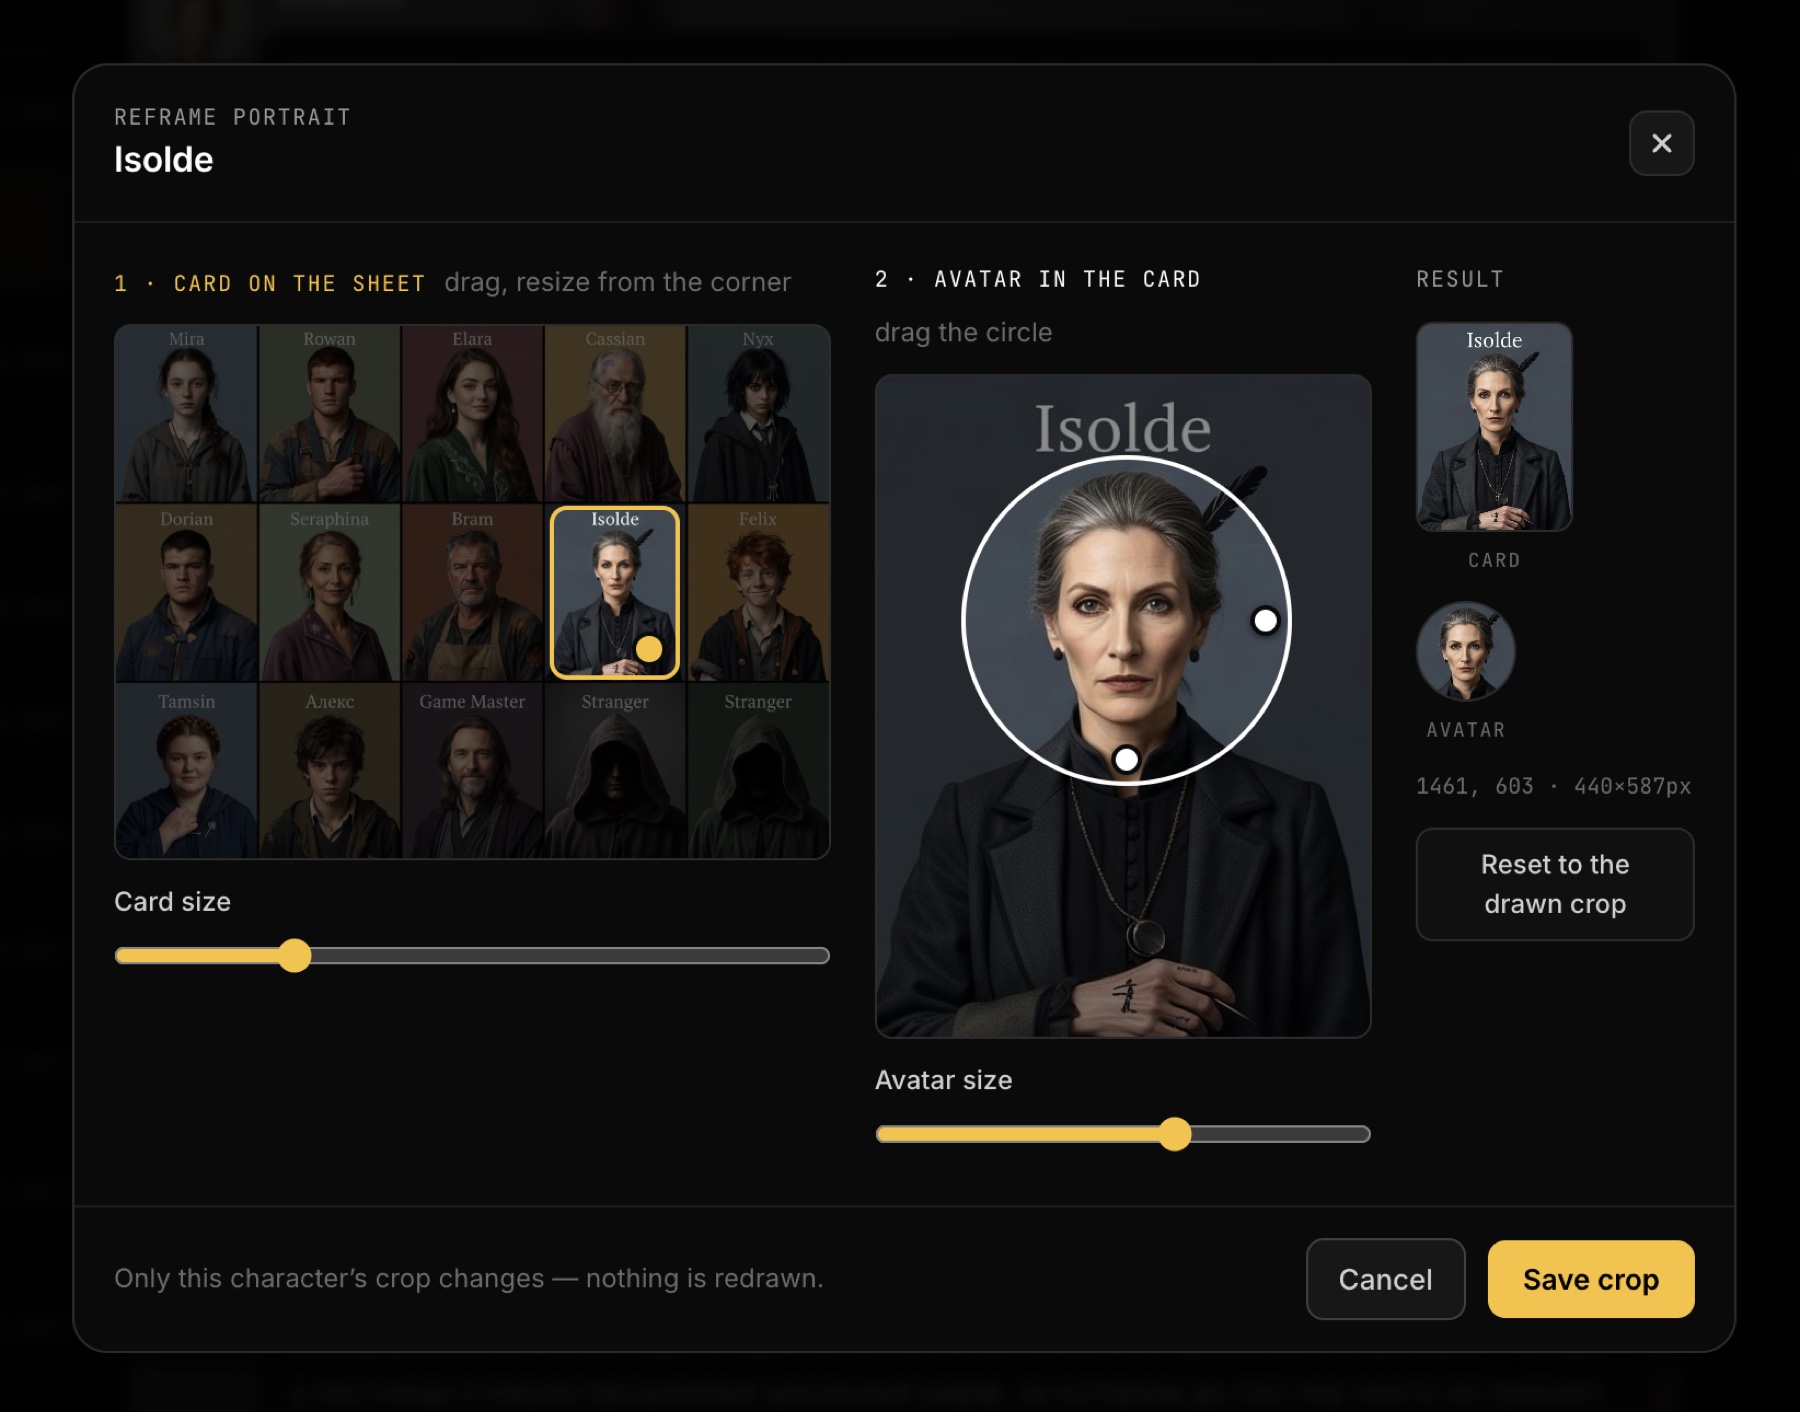
每場遊戲在建立時都會生成歡迎場景和一張肖像頁,之後還會隨著故事進行生成場景插圖。全部都跑在 Google 的圖片模型上。
我盡量把成本壓低——所有頭像都先以單張圖的方式生成,再由演算法切割成多個部分。我也讓使用者可以重新生成頭像——幸好他們沒有濫用這功能。重新生成的原因,主要是圖片功能剛上線時有很多 bug。某個模型生成出來的圖版很差,演算法無法正確切割。我甚至還加了一個簡單編輯器來調整頭像。
| 圖片類型 | 呼叫次數 | 支出 | 10 月 21 日前 | 10 月 21 日後 |
|---|---|---|---|---|
| 肖像與歡迎場景 | 421 | $62.75 | 17.0 美分 | 11.6 美分 |
| 遊戲中的插圖 | 585 | $31.91 | 6.9 美分 | 4.3 美分 |
一場中位數遊戲在圖片上花 20 美分。
很多遊戲建立後根本沒人玩。97 場遊戲在 10 回合前就結束了。它們讓我花了 $17.40,其中 $14.62 是圖片成本——相當浪費。
10 月 21 日,我從 Gemini 3.1 Flash Image 換成 Nano Banana 2.1。平均每次呼叫從 12 美分降到 6.7 美分。不過我的每日圖片支出還是上升了,從 $1.67 增加到 $2.06,因為每天的圖片呼叫數量超過翻倍,從 14 次變成 31 次。
圖片模型也會推理。思考 token 會算進文字費用,而且在 API 預設等級下,Nano Banana 的一張表比舊模型更貴。我把它跑在 minimal 等級。跟文字一樣,費率表上的每張圖價格,不等於你實際支付的價格。
音訊:便宜,而且正在成長
| 模型 | 工作 | 呼叫次數 | 支出 | 每次 |
|---|---|---|---|---|
| GPT-4o Mini TTS | 機器人語音 | 3,034 | $15.52 | 0.51 美分 |
| Gemini 3.8 Flash Lite TTS | 機器人語音 | 3,061 | $11.47 | 0.37 美分 |
| Gemini 3.1 Flash TTS(預覽版) | 機器人語音,直到 9 月 24 日 | 78 | $1.24 | 1.59 美分 |
| Gemini 3.5 Transcribe 和 Whisper | 語音轉文字 | 35 | $0.06 | 0.17 美分 |
Gemini 的語音比 OpenAI 便宜 27%,而且比它所取代的 Gemini 預覽版便宜超過 4 倍。玩家可以針對每場遊戲選擇供應商,所以兩者使用量差不多。
72% 的遊戲啟用了語音功能,405 場中有 292 場。大約每 5 則訊息就有 1 則是語音。因此它很受歡迎,但花費仍不到圖片成本的三分之一。
不過它正在成長。這份資料的第一週,音訊成本只有 $1.47;最後一個完整週則達到 $6.13。
語音轉文字功能不太受歡迎。53 天內只有 35 次使用,總共花了 6 美分。
分類器:四分之一的呼叫,只花 0.6% 的錢
兩個小型分類器在機器人周圍運作。路由器決定下一個應該由哪些機器人回覆。審查器則在使用者輸入送到供應商之前,先判斷所有內容。最後這個功能之所以必要,是因為太多使用者會想在 AI Werewolf 文字遊戲裡要求裸露和其他噁心內容。好吧,隨你。關於這件事我寫了 另一篇文章,而且我可能還會再寫幾篇,因為我還收到了更多有趣的案例。
我不覺得這有什麼不好,但如果 AI 供應商拒絕太多次,他們可能會封鎖我。不是封鎖使用者,是封鎖我和我的 API 金鑰。而且情況正變得更棘手——Anthropic 的 2026 使用政策更新 新增了對「持續且不必要地對模型施加辱罵或殘酷行為」的禁止。我不能讓這種事發生,而這些分類器很有幫助。
主要的分類器是 typesafe.ai 的 Jev。從 10 月 8 日開始,GPT-6 Luna 透過 OpenAI 的 Decisions API 跟它並行運作,幾乎每次呼叫都會跑。之所以加入它,是因為 Jev 有時候會失敗或逾時。雖然不常,但確實會發生。
Luna 只在 Jev 失敗時才會決定;否則它的答案會被保存下來,方便我比較兩者。
| 工作 | 模型 | 呼叫次數 | 支出 | 每次 | 中位時間 |
|---|---|---|---|---|---|
| 路由器 | Jev | 3,461 | $0.49 | 0.014 美分 | 82~149 毫秒 |
| 路由器 | GPT-6 Luna | 2,598 | $0.99 | 0.038 美分 | 201 毫秒 |
| 審查器 | Jev | 3,401 | $0.11 | 0.003 美分 | 84~160 毫秒 |
| 審查器 | GPT-6 Luna | 2,555 | $0.36 | 0.014 美分 | 327 毫秒 |
這總共是 12,015 次呼叫,占遊戲全部呼叫的 24%,總成本 $1.96。平均到每場遊戲,不到 1 美分。
把 Jev 當作路由器是一個巨大改進。它非常快,也非常便宜。
分類器唯一的問題是,它們彼此並不一致。Jev 和 Luna 對相同的輸入與問題會給出非常不同的分數——我得花很多時間調整。它們也會對我認為在角色扮演情境下無害的內容給出很高的分數。像是使用者罵自己是智障(0.9 仇恨言論)或「Good italian is dead italian」(0.95 種族主義)。這部分我留到另一篇文章再談。
追蹤錯誤
我透過讀取回應中的中繼資料來追蹤所有成本。但還是會漏掉一些。把我的數字和供應商的使用報告相比,常常會看到差異:
- DeepSeek:少 9%。 不知道為什麼。
- Gemini:到 10 月中旬前都很接近,之後少了 16~32%。 大概是我忘記關掉的、同一把金鑰上的其他專案。
- Claude:我實際支付的金額是我記錄的 1.54 倍。 這個不是共用金鑰的問題。Anthropic 的使用報告顯示,我的 token 數量其實在 2% 內都正確。問題出在我的程式:它把 1 小時快取寫入的價格算成了實際的一半。
還得再深入查查。
如果幾個月前的我要給現在的我建議
- 不要只看每 token 價格來選模型。要用你的真實工作負載跑一次,再用錢除以呼叫次數。
- 不要以為快取一定有幫助。先測試、讀文件,然後再測一次。要在真實的正式使用情境中測。快取是使用 LLM API 時最難的部分。
- 大多數使用者其實不太在意模型。所以,圍繞最便宜模型做隨機選擇,幫我省了很多錢。一開始我就是從支援清單裡隨機挑模型。
- 在能做的地方,把分類器用在遊戲邏輯上。
- 每個月都要把成本追蹤跟餘額對帳。一般來說,也要隨時分析統計資料。
數字還在持續成長
AI Werewolf 的 Models 頁面 會顯示遊戲中每個模型的實際每回合成本,這是根據真實遊戲量測出來的。隨著統計資料增加,我會重新量測,所以它是一個會持續更新的基準。
它是有偏差的。它反映的是我的使用情境、我的 bug,以及大家最常選擇的便宜模型。但誰說其他基準就比較好呢?至少這個來自真實世界。你的專案很可能會比一般性的基準更像我的專案。
原文出處:https://dev.to/hiper2d/how-much-does-it-cost-to-run-a-text-game-with-llms-57o7
1) --- 會變成分隔線(上一行必須是空白)
2) # 會變成一級標題
3) ## 會變成二級標題
4) ### 會變成三級標題
5) **粗體文字**會顯示粗體文字
6) ```當第一行與最後一行會顯示程式碼
7) 請搜尋 Markdown 語法,了解各種格式


